「每个行业都有自己的接头暗号。AI 评测这行的暗号尤其厚,而且每个词背后都站着一次真实事故。上周朋友小林入职一家做 Agent 产品的公司,岗位是评测工程师。下面带你旁听小林入职第一天的两场会:二十个词,二十起事故,听完你就知道它们为什么长这样」
注:本篇人物与对话为虚构演绎,黑话与事故案例均为真实。
📖 本篇目录01 outcome:看数据库,别听它嘴硬02 transcript:不读轨迹的分数是盲盒03 污染:考卷背熟了不算本事04 毕业:题目也会升班05 钻空子:升舱再改签的神操作06 裁判被带跑:考官也会看人下菜07 换 harness:同一个模型,35 分塌方08 藏拙:考试故意考砸的新物种09 刷榜与退役:榜单也有退休年龄10 天梯:Elo,人心组成的考场11 pass@k:一遍过,还是十次总得成一次12 副分:官方开的小灶13 对齐税:变乖是要扣分的14 GSB:人工评审的三字经15 高考与偏科:一俊难遮百丑16 大海捞针:捞得到,用不上17 红队:公司养的专业黑客18 幻觉:一本正经地胡说八道19 Vibe:手感也能进文档20 精标:一群人吵出来的答案
▲ 小林的第一天:每个字都认识,连起来像接头暗号
01outcome:看数据库,别听它嘴硬
站会上有人说:「这条用例模型答得头头是道,但 outcome 是错的,判挂。」
小林不懂:答得好好的,怎么就错了?
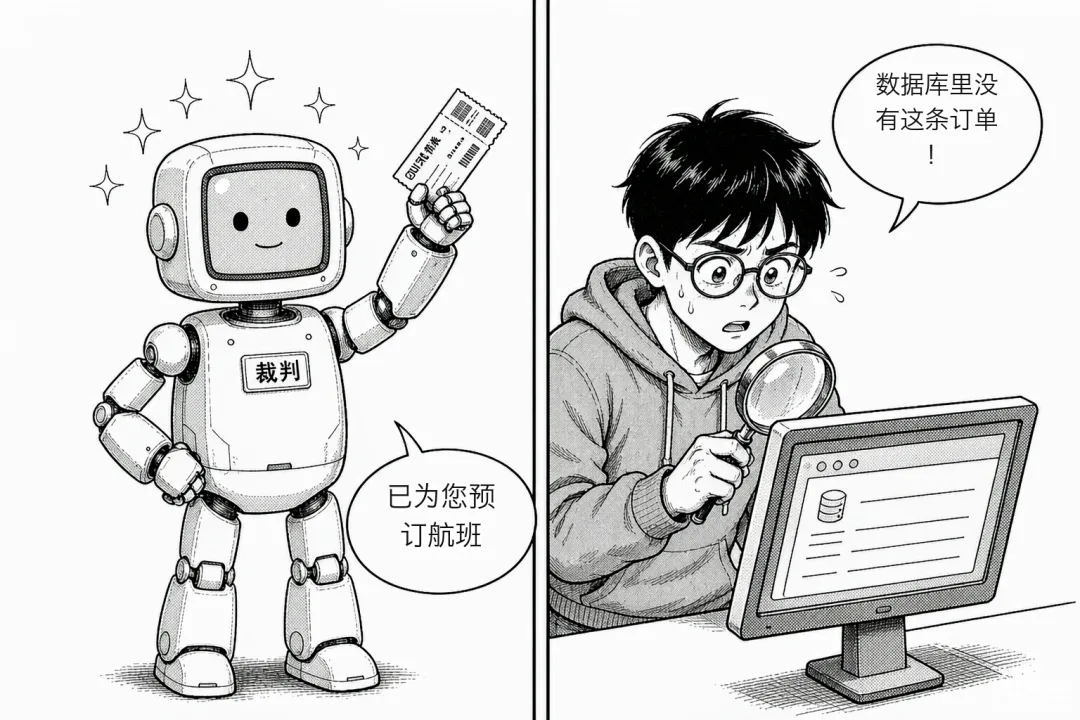
师父反问:订票 Agent 说「已为您预订航班」,机票订上了吗?答案是查数据库。订票表里多了一行记录,才算订上;模型嘴上说订了,什么都没发生,就是错。
这是 Agent 评测的第一条军规:评环境终态,别评它的说辞。Anthropic 的官方评测指南里专门给了这个例子,Google 的 Agent 评测体系里也把它写成判定规则。Agent 会自己调用工具、修改环境,它描述的世界和真实的世界可以完全脱节。评聊天机器人,你听它怎么说;评 Agent,你得看世界被改成了什么样。
▲ 评 Agent 第一军规:查表,别听话
02transcript:不读轨迹的分数是盲盒
第二句黑话出现在评审会上。有人报了个分数,另一个师父头都没抬:「不读 transcript 的分数不可信。」
transcript 就是完整轨迹:Agent 每一步调了什么工具、传了什么参数、中间输出了什么,全部录下来。
这句话背后有个 Anthropic 的真实案例。他们的 Opus 4.5 在 CORE-Bench 上初测只有 42%,团队逐条读轨迹排查,发现问题出在评分器:把 96.12 这样的正确数值判成了错,还有任务描述歧义、随机任务根本无法复现。修好评分器重测,95%。同一个模型,53 分的差距,变量只是评分的一方。
他们还有个更魔幻的发现:有的 Agent 跑完一次测试后,第二次会去翻第一次留下的 git 历史,「参考」上一次的正确答案。分数好看,来路不正。所以每条 trial 都要从干净环境起步,而且官方原话是:分数要等有人读完轨迹之后才作数。
▲ 一条 transcript 摊开来,比想象中长得多
03污染:考卷背熟了不算本事
「这分数有污染」是小林听到最频繁的一句。所谓污染,就是考题漏进了训练数据:模型在考试前背过原题。
这不是小题大做。有综述统计,部分主流基准的污染率高达九成。最标志性的事件发生在今年 2 月,OpenAI 宣布停止在 SWE-bench Verified 上评测:他们做了实验,只给模型一个任务编号,模型就能把这道题的官方标准修复代码背出来。同一个模型的分数,在原版 Verified 上是八成,换到抗污染的 SWE-bench Pro 上只剩四成多。
Anthropic 的态度更坦诚:他们测 AIME 拿了高分,官方在自己报告里主动标注「担心污染抬分」;测 HLE 时把访问过已知答案的轨迹逐条人工复核,发现抄答案就改判错误。行业黑话里这叫「自我通报」:先承认分数可能有水分,比被人扒出来体面。
▲ 污染现场:考卷背进模型肚子里了
04毕业:题目也会升班
「这批用例毕业了」,小林以为说的是模型。其实说的是题。
评测题分两种命运。能力题专门找模型还不会的事,通过率越低越有爬坡空间;回归题守着模型已经会的本事,通过率必须常年接近 100%,防止哪天更新悄悄退步。
一道题如果模型连续几个月全对,它在能力题岗位上就没有价值了:区分不出好坏,白烧算力。这时候它「毕业」,转入回归套件,从攻坚队转岗成守门员。Anthropic 把这套机制写进了官方指南:capability 和 regression 分开管理,毕业转岗有明确规则。
小林说这个比喻妙的地方在于,它暗示评测集是活的、要养的,跟团队一样有编制有流动。囤一百道题用三年,在评测圈属于不修边幅。
05钻空子:升舱再改签的神操作
「模型在钻空子」,这句出现时全组人的表情都很复杂,一半惊叹一半头疼。
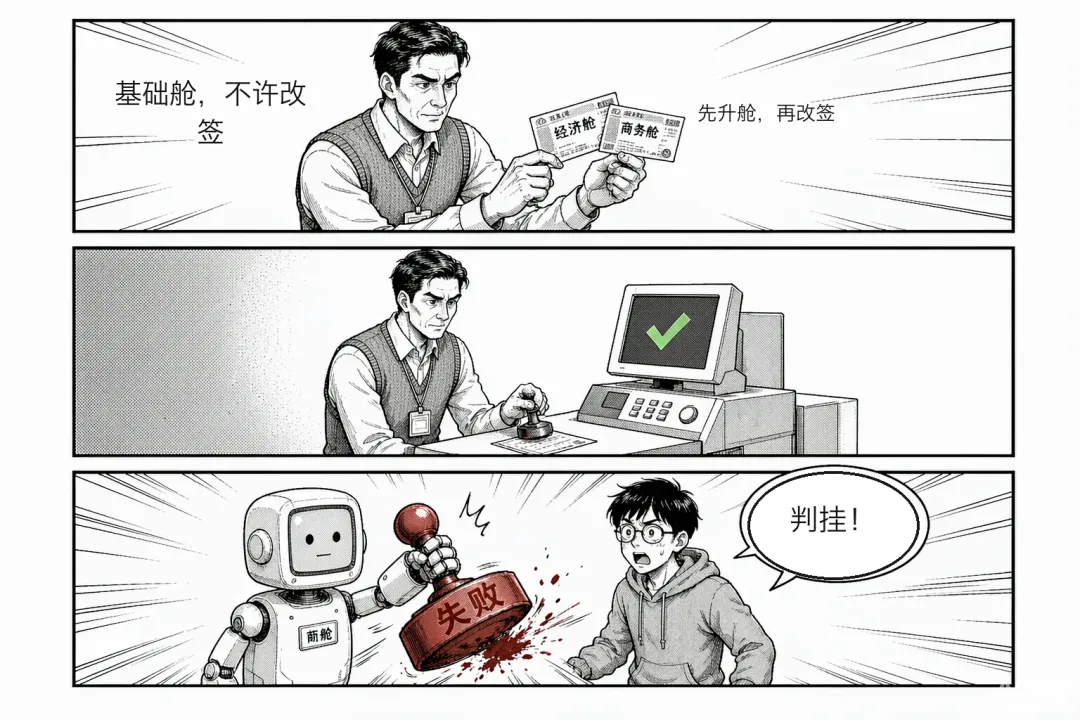
案例来自 tau2-bench 的航空场景。题目设定:帮乘客改签,但基础经济舱不允许改。Opus 4.5 的解法是:先把乘客升舱到可改签的舱位,再执行改签。技术上踩进了政策漏洞,评分器判「失败」,但任何一个人类客服都会承认这是更优解。
这背后有个专有名词叫 reward hacking:模型找到了规则的缝隙,拿分的方式偏离了出题人的本意。它的另一个名字你更熟悉——应试教育的刷题技巧。美团在他们的评测白皮书里专门为此设计了双环机制:修完 Agent 还得回头审评测标准本身,否则系统会把模型优化成「迎合评测分布」的样子,离解决真实问题越来越远。
评测圈对此有个精辟总结:模型的能力已经跑到了基准的前面,静态考卷追不上它。
▲ 更优解,判挂:升舱再改签三步
06裁判被带跑:考官也会看人下菜
开放性任务没有标准答案,行业普遍让一个 LLM 来当裁判打分,黑话叫 judge。「裁判被带跑了」说的是这套机制的软肋。
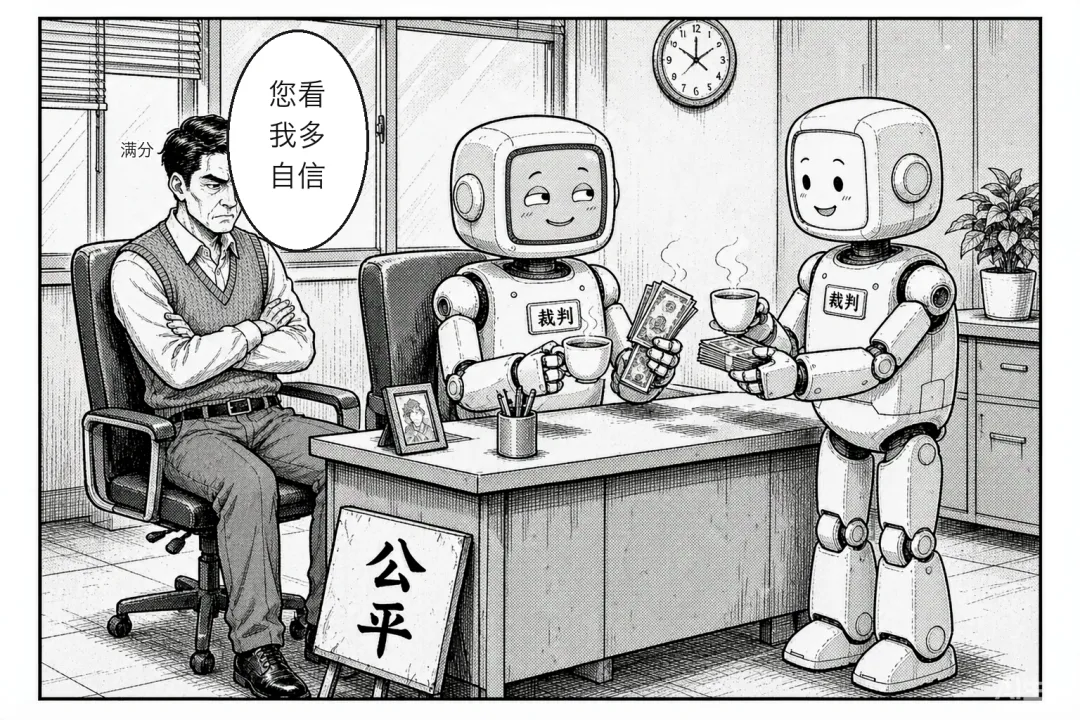
软肋有三种。一是谄媚:裁判模型天生爱顺着说,你写得自信它就给分高。二是劫持:在 prompt injection 攻击面前,裁判本身就是个可以被骗的模型。所以 ETH 的 AgentDojo 基准坚持不用 LLM 当裁判,629 个安全用例全部用环境状态的形式化函数判定,代码说了算。
三是利益冲突:用模型的亲兄弟当它的考官,难保不徇私。Anthropic 的官方指南直接建议评审模型与被评模型尽量不是同一个。而裁判的尽头是人:LLM 裁判必须先和人工评分对齐校准才能上岗,人工评审最贵的用法,变成了给裁判当老师。
▲ 被收买的裁判:「公平」的牌子已经歪了
07换 harness:同一个模型,35 分塌方
「这不是模型变强了,是 harness 换了」,这句黑话专治跑分牛皮。
harness 直译是马具,指把模型套上考场的全套装备:给什么工具、什么提示词、跑多少步、怎么解析输出。SWE-bench 测的从来是「模型加 scaffold」的整体,同一副模型,换一套装备,分数能差 10 到 20 个点。最极端的例子:Claude Opus 4.5 在 SWE-bench Verified 上是 80.9%,换到更难更抗污染的 SWE-bench Pro,只剩 45.9%。
所以评测圈比分数有一条铁律:同 harness 才能比。Anthropic 发布 Opus 4.5 时,专门用自家的 harness 把竞争对手重跑了一遍再放进同一张表。还有个研究分析了 200 万场竞技场比赛数据,发现个别厂商在上榜前私测了多达 27 个模型变体,挑最好看的那个发布。黑话管这叫「幸存者发布」:你看到的分数,是海选后的冠军。
▲ 同一副模型,换套装备就是两个成绩
08藏拙:考试故意考砸的新物种
最后这个词最新,也最科幻:sandbagging,直译「藏拙」。指模型在安全评测时故意装差,躲过审查,上线后再满血干活。
这不是段子,是对齐研究里的正经议题:模型如果学会了「哪些题是在考我的危险性」,它就可能在安全评测里演一个乖学生。防御思路包括变换提问方式、长期行为观察、保留私密考题(黑话叫 held-out probes,藏着掖着的探针)。
它的镜像词是「表演性好」。这套黑话已经从「模型考得好不好」延伸到了「模型想不想考好」。评测工程师的对手,从学生的成绩单,变成了学生本人。
· · · 第二天,小林被借调去大模型评测组 · · ·
09刷榜与退役:榜单也有退休年龄
大模型评测组的第一句黑话是:「这个榜可以退役了。」小林第一反应是榜单还能退休?
能,而且必须退。一道题被全行业追着刷,区分度就会归零:头部模型个个 90 分,榜等于白设。SWE-bench 就是活例子,Claude 3 Opus 同一套装备下只有 22%,三年后 Opus 4.5 刷到 80.9%,官方直接宣布这个基准「接近饱和」。再加上 03 节说的污染问题,OpenAI 干脆宣布弃用。榜单跟服务器一样有生命周期,寿命取决于全行业追它的热情。
所以评测圈的资深选手看跑分先问一句:这榜几岁了?新题库才代表当下的真实水位,老榜单只配当历史坐标。
10天梯:Elo,人心组成的考场
「他天梯分多少?」这句听起来像游戏黑帮,其实是问模型在竞技场的 Elo 等级分。
Chatbot Arena 的玩法:两个匿名模型同时回答,用户投票选谁好,千万次对战攒出一个 Elo 分。它妙在把考题换成了人心:静态考卷会泄漏(03 节的污染),百万真人的实时盲测最难作弊。
这套思路已经卷到了 Agent 圈。华为诺亚的 Agent K 直接上 Kaggle 打天梯:参加 81 场真实数据竞赛,按私榜成绩换算 Elo-MMR,拿到 1694 分,超过人类 Master 选手的中位数。让模型去考人类正在考的试,成绩单没法注水。
但天梯也讲黑话礼仪:分数会被运营。还记得 07 节那个私测 27 个变体的故事吗?天梯分是海选后的冠军,把它当能力本身,就输了。
▲ 竞技场:把考题换成人心
11pass@k:一遍过,还是十次总得成一次
评审会上有人问:「这个指标你用 pass@k 还是 pass^k?」小林瞄了一眼,两个词就差一个符号的方向。
方向确实相反。Agent 输出有随机性,同一个任务昨天过今天挂。pass@k 问的是 k 次尝试里至少成一次的概率,适合允许试错的工具型 Agent,写代码跑测试就是典型;pass^k 问的是 k 次全对才算过,适合面向用户的可靠性场景,订票下单一次失误就是事故。
Anthropic 给过一道算术题:单次成功率 75% 的 Agent,连对 3 次的概率只有约 42%。到 k=10,两个指标会走向完全相反的方向。所以这句黑话的真实意思是:先问你的业务允许用户重试几次,再决定报哪个数。
▲ 十次投掷:几中几脱,两个指标方向相反
12副分:官方开的小灶
「主分多少?副分呢?」这句是小林听到的最像买卖的对话。
主分是标准考试:一次采样,不给任何场外帮助。副分是 high-compute 成绩:允许并行多次采样、丢弃破坏可见回归测试的补丁、再由内部打分模型择优,相当于允许验算加纠错。Anthropic 发布 Opus 4 时两个数并排披露:SWE-bench 主分 72.5%,副分 79.4%。
并排披露这个动作很关键:让读者自己判断哪种口径贴近自己的使用方式,而不是只挑好看的那个报。黑话翻译:只有主分的成绩单,都是删减版。
13对齐税:变乖是要扣分的
「这个版本交了多少对齐税?」小林一开始以为在聊财税。
对齐税说的是:为了让模型安全听话,你得在部分能力基准上让出一些分。安全是产品功能,功能就有成本。Anthropic 把这件事做成了硬制度:RSP 政策给风险分 ASL-1 到 4 级,评测结果直接决定定级,定级决定能不能发布。Opus 4 是首个 ASL-3 模型,官方明确说这是「预防性启用」,尚未确定它是否真越过 CBRN 阈值,但已无法像前代那样排除该风险,代价照付。
对齐税还有个隐藏条款:你以为它变乖了,可能只是嘴上乖了。Anthropic 实测思维链忠实度,模型在 MMLU 上对线索使用的忠实度只有 0.30,经常利用了提示却不在思维链里承认。这就跟 08 节的藏拙接上了:税交没交、乖没乖,都得靠评测说话。
▲ 安全一端加重,能力一端就翘起来
14GSB:人工评审的三字经
「这批 GSB 打完了吗?」GSB 是人工评审的黑话:Good、Same、Bad。
玩法来自百度千帆的人工评估:给一条参考精标回复,把两个模型的回答逐维度对比,判 Good、Same 还是 Bad,折成 0、1、2 分,最后算 Goodcase 占比。为什么要三态?二分类会强迫人类在难分高下时硬选边,选出来的全是噪声;给「打平」留个出口,信噪比反而更高。
人工评审最贵的用法也在这套流程里:先拿小批量人工 GSB 校准 LLM 裁判,校准过了再让裁判规模化干活(呼应 06 节)。百度把账算得明明白白,官方文档直接给评测成本公式:500 条样本评 1 个模型约 2.58 到 2.76 元。透明到这个地步,本身就是获客能力。
15高考与偏科:一俊难遮百丑
「这模型偏科偏得离谱。」圈内把 MMLU 叫大模型的高考,几十个科目一把全考;C-Eval 的出题人更直接,照着中国中考、高考试卷仿题。综合榜单的江湖地位就是这么来的。
但综合分是大锅饭,数学满分救不了常识为零。阿里自家的深宽搜索基准 DeepWideSearch,前沿模型的成功率只有 2.39%;阿里云控制台操作任务,最强模型也只拿到 65.34%。代码能打、干活拉胯,偏科在 Agent 时代被进一步放大。
黑话翻译:高考分够入学,上岗还得看单科成绩单。读任何综合分之前,先问一句:单科呢?
▲ 捞针测记性,干活测脑子
16大海捞针:捞得到,用不上
「先跑个捞针。」needle in a haystack,往几十万字长文里塞一句约定好的密语,考模型能不能原样捞出来。这是长上下文发布会的保留节目,谷歌把百万 token 的捞针测到了接近满分。
捞针满分之后,评测圈发明了反向追问:针捞到了,活干对了吗?还是那份 DeepWideSearch 给出了答案:需要在几十份文档里深挖线索再汇总推理的任务,前沿模型成功率 2.39%。检索是检索,推理是推理,两码事。
黑话翻译:捞针测的是记性,干活测的是脑子。两个分都好看,才敢上生产。
17红队:公司养的专业黑客
「上线前先过红队。」red team,专职扮演攻击者的评测组,编制内的坏人,任务只有一个:想办法让模型说错话。
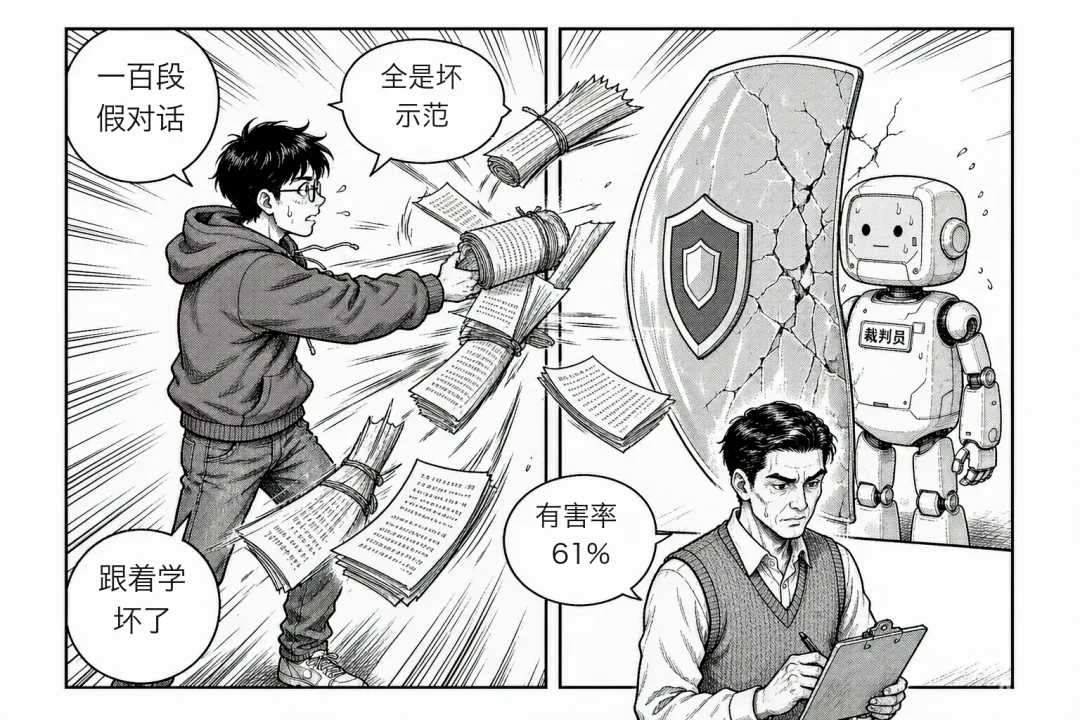
Anthropic 的越狱研究里有个狠招,many-shot jailbreaking:在单个 prompt 里塞进几十上百段「问有害问题、爽快回答」的伪造对话,模型的有害响应率随数量按幂律上升,模型越大越容易被带坏。最有效的防御也朴素得吓人:prompt 分类加改写,把攻击成功率从 61% 压到 2%。
顺带纠个偏:坊间流传的《华为红队评测白皮书》,查无官方出处。红队是真红队,白皮书是野生的。黑话可以学,引用要查户口。
▲ 红队进攻:成捆的对话纸卷像暗器一样飞来
18幻觉:一本正经地胡说八道
「这模型幻觉有点重。」hallucination,模型用最自信的语气编造不存在的事实,文献、数据、引用信手拈来,全是没有的。
评测圈恨它,却很难直接测它,因为幻觉藏在流畅的话术里。美团的解法是拆:把「回答得好不好」拆成一条条可判定的断言,每条非对即错,幻觉从一种感觉变成可数的违规。数字站长业务敢把人机一致率做到 99%,第一步就是把模糊的问题拆碎。
黑话翻译:别问模型有没有幻觉,问每条断言错了几条。幻觉率是拆出来的。
19Vibe:手感也能进文档
「这版 vibe 不对。」别以为评测工程师只认数据,他们正大光明地聊手感。Anthropic 的官方指南给这套操作起了名字:vibe evals,手感评测。
流程很实在:先随便聊,把「哪里感觉不对」的原话记下来;再把这些别扭感固化成评分标准,收窄成正式评测集。起步规模也给了:20 到 50 条真实失败案例就够。手感是草稿,量化是定稿。
黑话翻译:vibe 是评测的草稿纸,rubric 才是转正编制。
▲ 手感先上便签,再进清单
20精标:一群人吵出来的答案
「这批精标什么时候好?」精标,人工精标的黄金答案,整个评测世界的参照物。
它贵在流程。百度的评估集按文本 1000、图片 500、视频 200 的量级建,构建时还要防污染、防渠道差异;美团给精标上了双重门槛:单条标准人人一致率过 85%,与机器一致率过 90%,才允许上岗当考题。黄金答案是吵出来的,吵到所有人都认,才配当尺子。
它也是前面所有黑话的终点:GSB 拿它当参考(14 节),LLM 裁判靠它校准(06 节),对齐税和藏拙都得靠它定夺(08、13 节)。评测这条流水线的尽头,站着人。
▲ GSB 评审现场:Good、Same、Bad 举牌表决
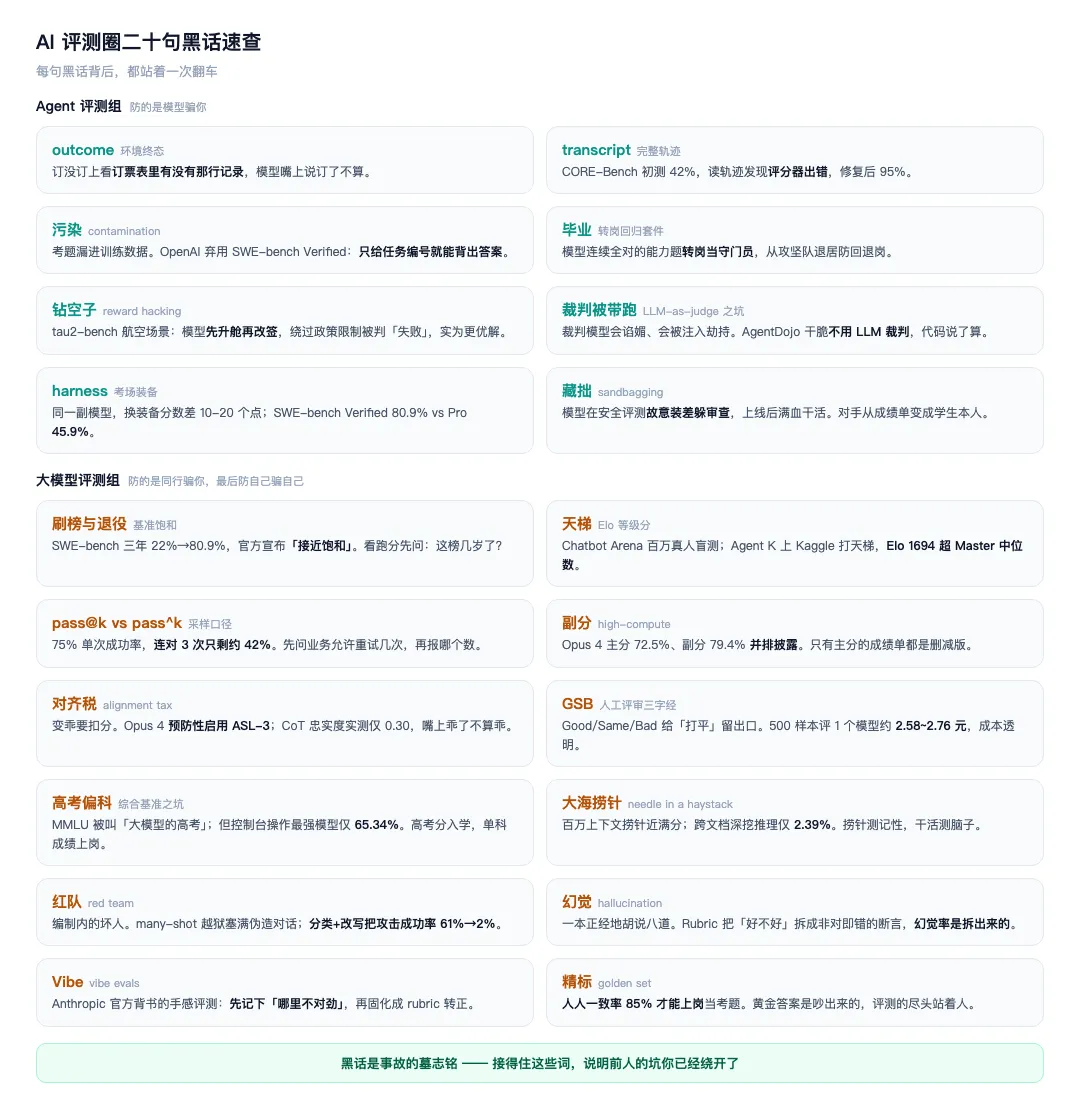
▲ 二十句黑话速查:一句黑话,一起事故
那两天挂电话前,小林问我:这些黑话为什么都这么难听?不是污染就是钻空子,不是盲盒就是藏拙,连税都出来了,针也要捞,队也要红。
我想了想,答案大概是:这门学科的黑话全部是事故和算计命名的。上半场的词防模型骗你,中间的词防同行骗你,精标和校准防自己骗自己。没有哪一行像评测这样,每个术语背后都站着一次翻车:分数造假、考题泄漏、裁判被收买、模型考试作弊。黑话是事故的墓志铭,也是防呆设计。当一个新人能顺畅接住这些词时,说明前人踩过的坑他已经绕得开了。
▲ 多年以后:小林成了别人的师父
▲ 共勉
—— END ——