做生信的人每年都会刷到几篇"我们的新方法在 X 数据集上全面超越 SOTA"的论文,可等到自己复现,往往发现根本跑不出那个数字。问题很少出在代码写错,而是出在评测本身:谁的数据、怎么分的组、拿什么当基线,这些细节一旦松一点,结论就能漂亮一大截。基准评测(benchmarking)不是顺手跑个脚本的事,它有一套方法学规范,也是社区反复较真的领域。
1. 基准评测为什么总翻车
评测的本质是拿一套固定规则,公平地给不同方法打分。但生信数据天然带偏:样本量小、批次效应重、标签噪声多。当一篇论文既要证明自己方法好、又自己设计评测时,很容易无意间把数据切得对自己有利。我见过最典型的,是把同一个队列既用来调参又用来报分,于是报告里的提升有一半是"过拟合到测试集"而非真实增益。
评测文化要解决的,就是怎么让这种增益可被信任。它不关心某个具体算法多花哨,只关心三件事:数据有没有被悄悄看过、比较是不是在同一条件下进行、结论能不能被别人原样复现。
2. 数据泄漏是最隐蔽的虚高来源
数据泄漏指模型在训练或调参阶段接触到了本应保密的测试信息。在组学里它常以很温和的面孔出现。比如用全部样本算出的基因均值去做标准化,再把这个标准化后的数据切成训练测试集,测试集其实已经"闻过"了整体分布;又比如特征选择先在全体样本上做完,再划分训练测试,选出来的特征天然偏向测试集。这两种情况在单细胞和中游流程里极其常见。还有一类更隐蔽的是人群或中心分层泄漏:做临床预测时,如果训练集里某家医院样本占多数、测试集也恰好偏这家,模型学到的很可能是这家医院的建库或仪器特征,而不是疾病本身的特征,换一个中心验证立刻崩。判断方法很直接,把医院、批次当作一个特征加进模型,看它是不是靠这个特征分对了样本,如果是,说明分组没做到位点无关。
识别泄漏有个土办法:把评测流程想成一条流水线,凡是"用了测试集信息"的操作,必须严格发生在切分之后。下图把最常见的泄漏路径标了出来。
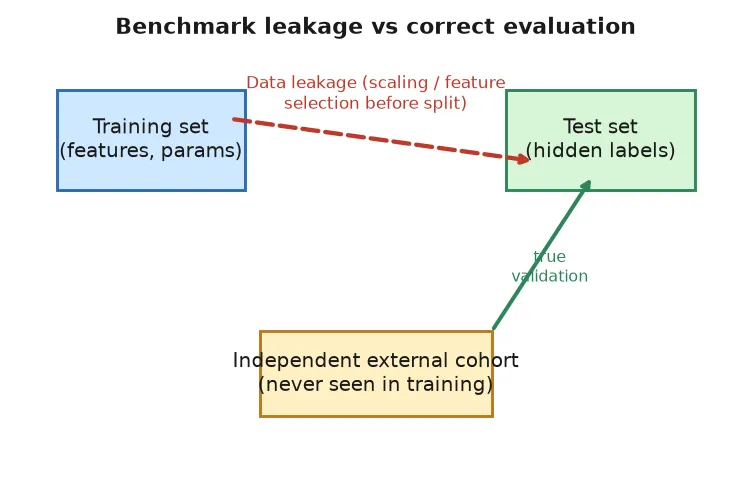 图1:基准评测中训练集与测试集之间的数据泄漏路径示意
3. 公平比较要守住三条硬线
第一,划分要独立于任何特征工程。标准化、降维、特征选择都只能在训练折内拟合,再应用到验证折。交叉验证的每一折都要重新走一遍这套流程,而不是先全局处理好再折内取子集。
第二,基线方法要用对它当前的版本和默认参数。拿三年前的旧版工具当对手,或者给新方法调了三个月参数、给基线用出厂默认值,这种对比没有意义。我一般会把基线也跑一遍当时的推荐配置,至少保证不是拿稻草人当靶子。
第三,报告要带上不确定度而不是单点数字。小样本下换一组随机种子,AUC 能浮动好几个点。只报一个最优点、不报标准差或置信区间,读者无法判断这 0.03 的提升是真有还是噪声。
4. 社区怎么一步步守住规范
方法学规范不是某篇论文定的,而是社区用一次次翻车换来的。像机器学习里的 CHECKLIST、组学里的标准化评测倡议,都在推同一件事:公开代码、固定随机种子、提供可重复的环境、在独立外部队列上再做一次验证。外部验证尤其关键,因为内部交叉验证再漂亮,也可能只是拟合了本队列特有的批次结构。
现在很多期刊要求投稿附带可运行环境和独立测试数据,也算把社区共识写进了流程。对使用者来说,看到一篇新方法的论文,先问一句"它在不属于作者的队列上验证过吗",比直接相信标题数字要稳妥得多。
5. 拿到评测论文先查三处
读一篇带着漂亮曲线的新方法论文,我习惯先翻方法部分的三处,而不是急着信结论。第一处看数据划分写在哪里、有没有按病人或中心分组,按样本随机切的往往藏着分层泄漏。第二处看基线是不是同版本同配置,有些论文基线用的是三年前的旧版工具,等于拿旧武器当靶子。第三处看有没有独立外部队列验证,只在作者自己队列上做交叉验证的,分数再高也只是内部潜力。
这三处都过关,才值得花时间去复现。复现也别从零写,先看作者有没有公开代码和随机种子,有的话直接拉下来换自己的数据跑一遍,比读十遍文字都管用。社区共识其实就是一句话:能被原样复现的结论,才配叫结论。
6. 常见坑
我自己踩过最深的坑是交叉验证写错层级。做多中心数据时用样本级随机 k 折,结果同一个病人的多个样本被拆到了训练和测试两边,测试集等于间接见过病人特征,报出来的泛化误差比真实情况好出一大截。正确做法是按中心或按病人分组切分。另一个坑是拿准确率评不平衡数据,组学里阳性样本常常极少,全猜阴性也能有九成准确率,这种数字看看就好,别当真。
7. 一个易混概念
很多人把"交叉验证分数高"和"模型泛化好"画等号,这俩不是一回事。交叉验证只保证在"与训练数据同分布"的测试折上稳定,一旦换队列、换平台、换建库协议,分布就漂移了。泛化好指的是跨分布仍成立,必须有外部独立数据支撑。内部验证是入场券,不是合格证。
8. 小结
评测的底线就一句:让结论经得起别人原样复现。动手前先把数据划分、基线配置、不确定度这三件事定死;跑完先问自己"测试集有没有被提前看过"。这次我们的判断标准是,一篇方法论文如果没有独立外部队列验证,再高的内部分数都只能算"有潜力",不能直接当结论用。
