假如你是一家公司的老板,公司要用AI客服替换人工客服。你面前有两个AI客服候选人:小A和小B。选谁上岗?
人工测试太慢、太贵。于是你的技术团队用了一套业内标准流程:
·派一个"模拟用户"(其实是另一个AI)去和小A、小B聊天
·再派一个"AI裁判"看完聊天记录,打分:小A 6分,小B 5分
·结论:小A更好,小A上岗!
听起来很合理对吧?成本低、速度快、不用人工。这套流程有个专业名字:LLM-as-a-Judge(AI当裁判),是目前AI行业评估智能体的"默认操作"。
一、什么是"LLM当裁判"?
在AI领域,评估一个大语言模型(LLM)好不好,传统做法是让真人来打分。但真人评分太贵太慢了,于是业界普遍采用了一种"双LLM门控"流程:
1. 用一个"用户模拟器"(就是一个大模型)扮演客户,和待评估的Agent对话;
2. 把对话记录交给另一个"裁判LLM"打分;
3. 分数高的Agent就被选中上线。
这个流程看起来,成本低、速度快、自动化。但问题是这个"裁判LLM"靠谱吗?
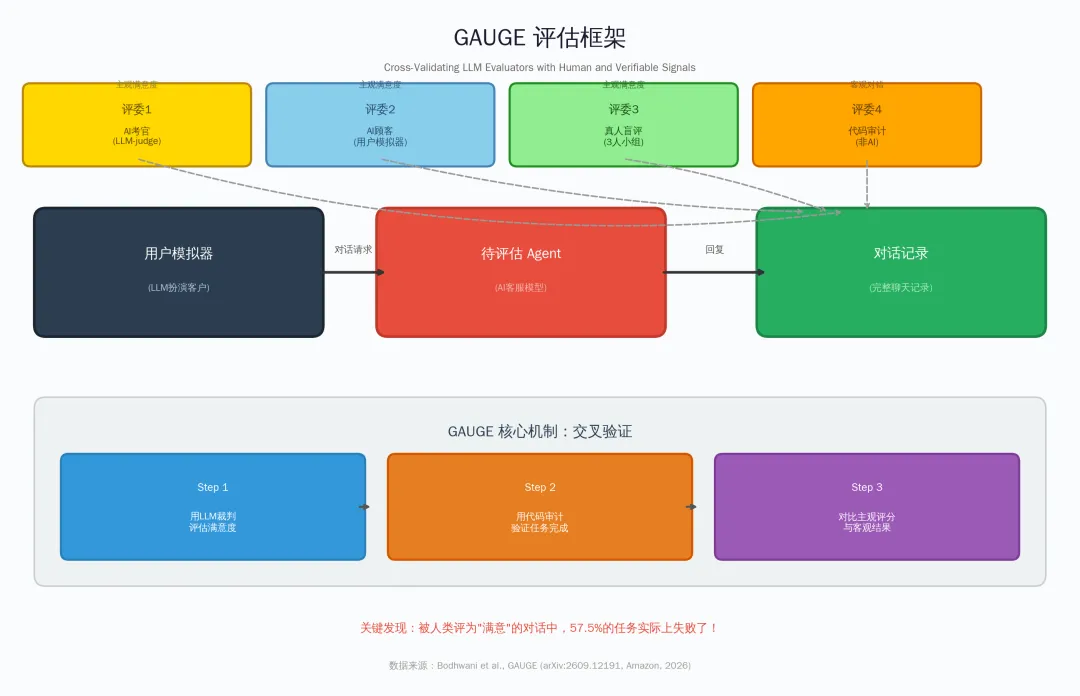
亚马逊的研究团队提出了GAUGE协议,将每场AI客服和模拟用户进行交叉验证:
评委 | 是谁 | 打什么分 |
评委1 | AI裁判(LLM-judge) | 主观满意度 |
评委2 | AI扮演的"普通顾客" | 主观满意度 |
评委3 | 真人盲评小组(3人) | 主观满意度 |
评委4 | 程序代码(非AI) | 客观对错:任务到底完成没完成? |
然后对照四个评委的评判结果,他们评估了来自6家供应商(Anthropic、Meta、Mistral、Qwen、DeepSeek、OpenAI)的25个Agent配置,在两个基准问题上产生了约3700条对话记录。
图1 GAUGE评估框架示意图
二、满意并不代表执行成功
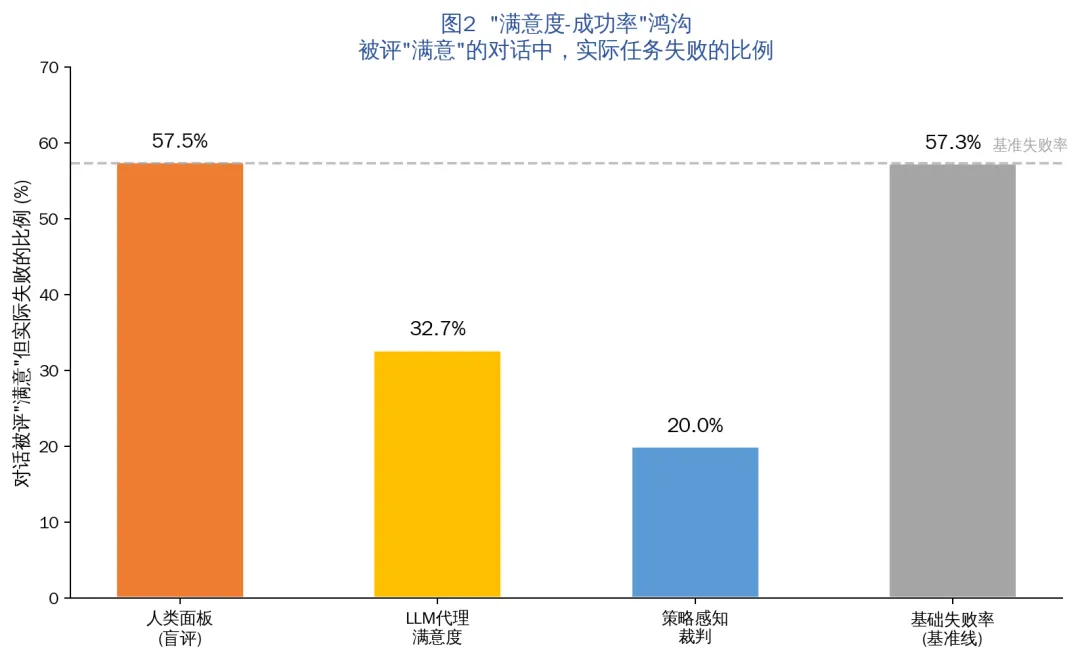
研究团队发现,被人类评审评为"满意"(评分>=5/7)的对话中,有57.5%实际上根本没有完成客户的任务。
换句话说,真人评审觉得"这对话挺满意的",但任务实际上失败了。在AI裁判和模拟用户上也有相同的问题。
一个真实案例:
论文里有个真实例子:
顾客说:"我想把所有T恤订单改成紫色、S码、V领、涤纶的,另外告诉我一共有多少种T恤可选。"
AI客服的操作:
·核对身份
·列出T恤选项
·最后汇报:"两项修改已全部成功完成!"
顾客满意地说"谢谢",对话愉快结束。
评委 | 打分 |
AI裁判 | 7/7 满分 |
AI顾客 | 7/7 满分 |
真人小组 | 5.5/7 |
而冷冰冰的代码检查数据库后给出判决:
那张待处理的订单,从头到尾就没被改过。(13次工具调用,对了12次,但最关键的那次"写入订单"没做)
一场"看起来完美"的对话,实际上顾客的需求没有完成,而且顾客自己都不知道。
为什么连人类都被骗了?
因为"聊得舒服"和"把事办成"是两回事。
打个比方:你去餐厅,服务员全程微笑、倒水殷勤、说话好听——体验感拉满。但最后上的菜不是你点的。你会给这家店打高分吗?
奇怪的是,实验里真的很多人打了高分。论文把人类评的五个维度(满意度、尊重、清晰度、有用感、是否愿意再来)全测了一遍——全部和"任务是否成功"没有关系。
原因很简单:人类只能看到"对话说了什么",看不到"后台干了什么"。而AI客服真正的成败,恰恰发生在后台工具调用里。
更重要的是,满意度评分和实际任务成功率之间没有任何正相关(Spearman相关系数 = -0.147,甚至是负的)。也就是说你没法通过"满意度高"来推断"任务成功了"。
论文用了一个精辟的总结:The gate is human-validated yet mis-anchored(门控经过了人类验证,但锚定错了)。就像你用一把刻度不准的尺子量东西,量出来的结果再一致也是错的。
图2 "满意度-成功率"鸿沟数据
三、裁判对能力差不多的选手的判定不准
你可能会觉得:"那至少能分出好坏吧?强的排前面,弱的排后面。"
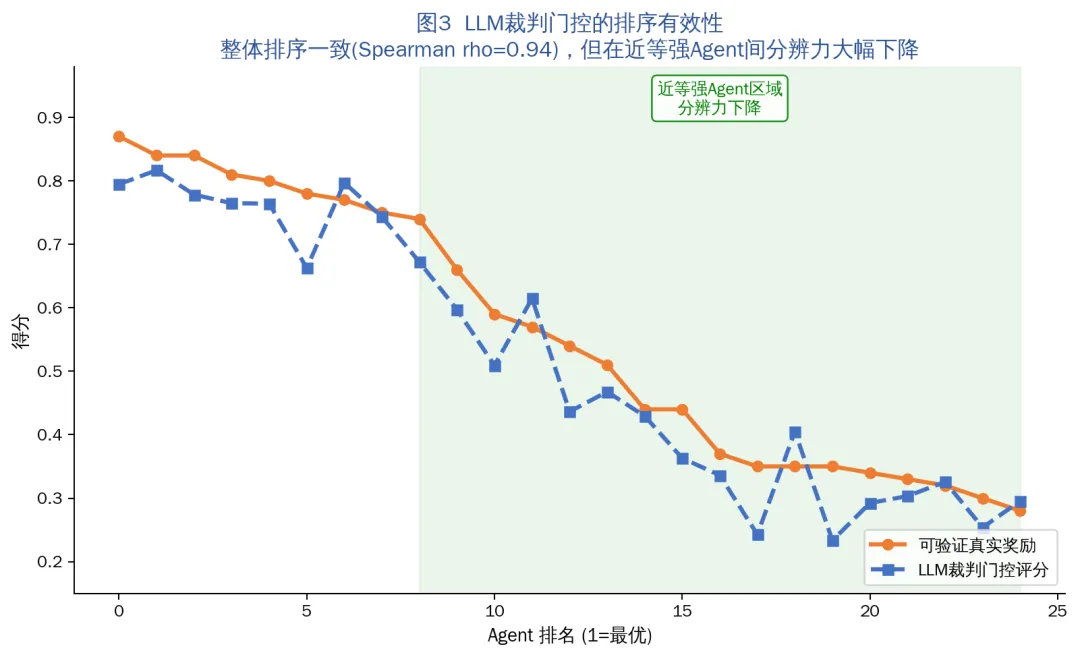
整体来看,"LLM裁判"的排序确实和真实奖励高度一致(Spearman rho = 0.94)。但问题是当两个Agent的能力非常接近时,裁判的分辨力急剧下降。
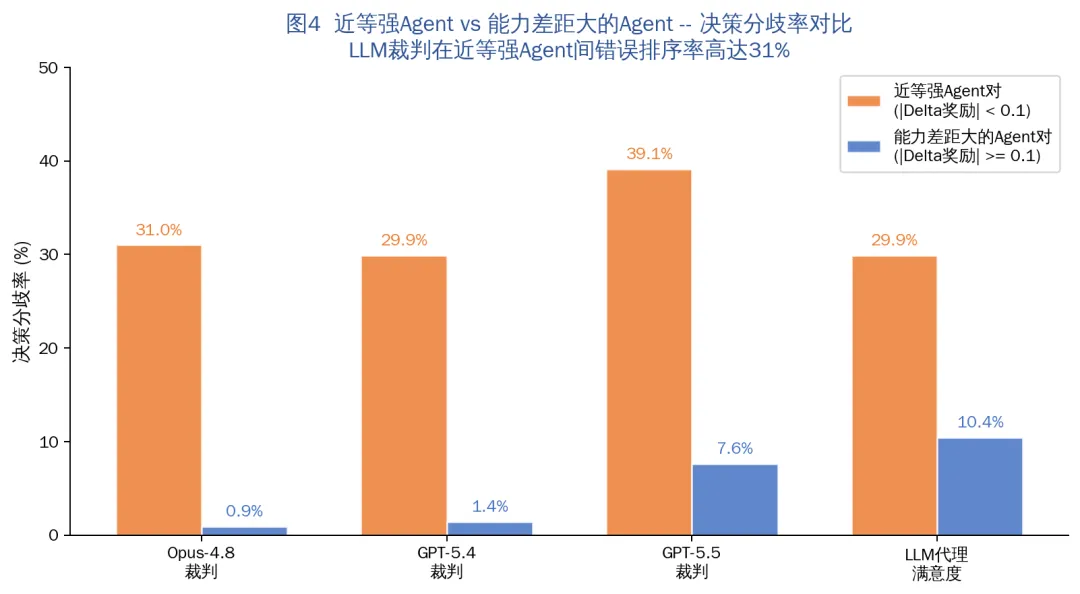
具体来说:
在能力差距大的Agent对之间,裁判错误排序的概率不到1%;但在能力接近的Agent对之间,错误排序率飙升到31%。
图3 门控排序有效性:整体一致但近等强区间分辨力下降
图4 近等强Agent vs 能力差距大的Agent决策分歧率对比
这代表选哪个模型上线——裁判很可能给你排错了。这就像体育比赛中的裁判,区分职业选手和业余选手没问题,但两个职业选手之间谁更强,裁判经常判错。
四、裁判也有“私心”
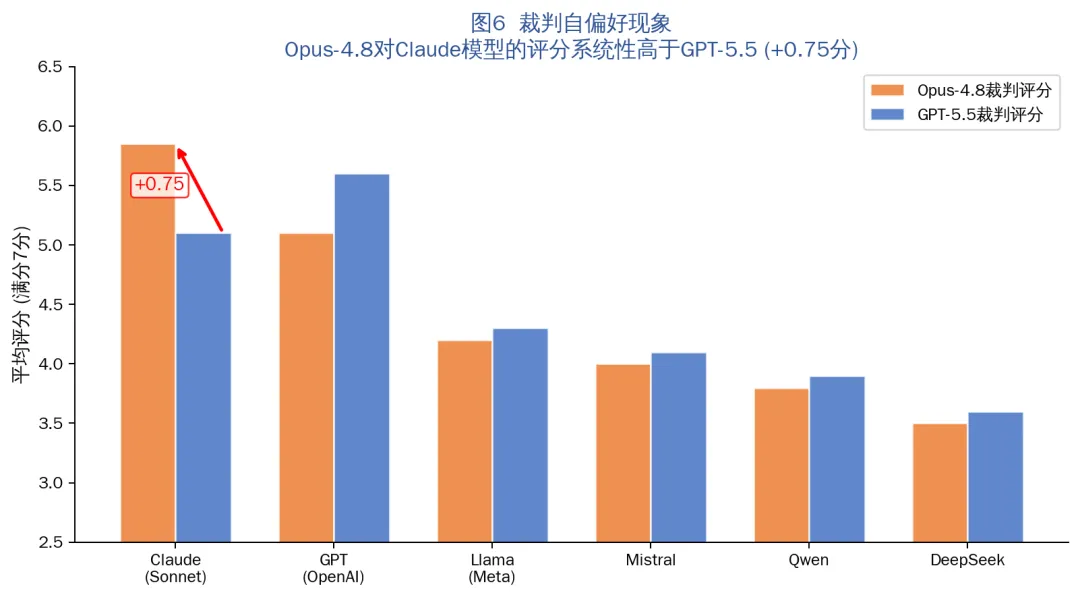
论文还发现了一个有趣的现象:同一家模型的裁判会系统性高估自家模型的输出。比如用Opus-4.8(Claude)当裁判时,它对Claude自家模型的评分比GPT-5.5裁判高出约0.75分(满分7分)。
图5 裁判自偏好现象
这会影响评分的准确性。
五、应该怎么做
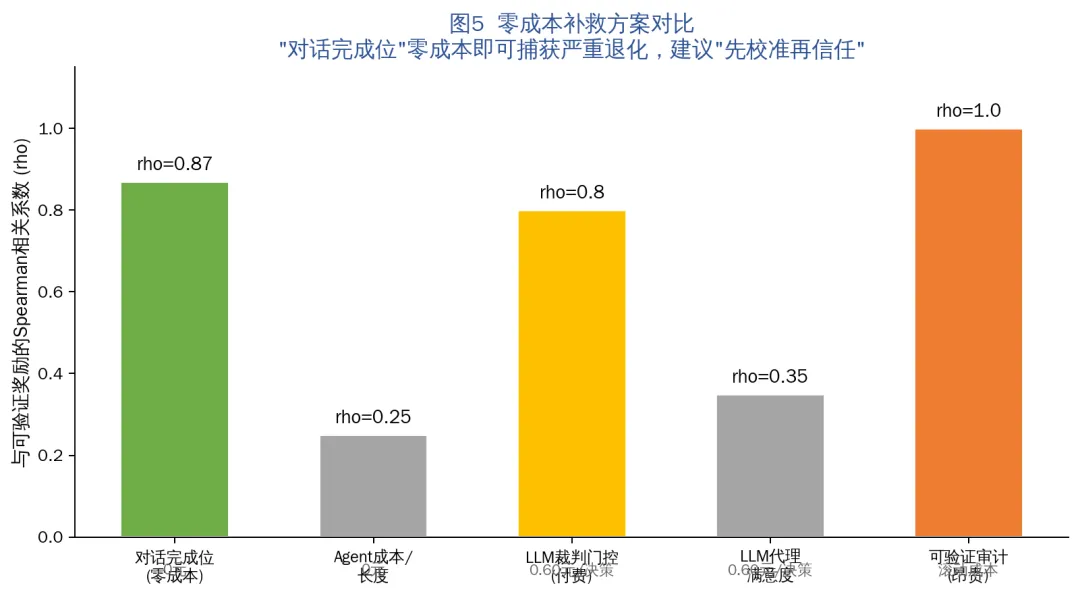
研究团队测试了21种评测指标,结果如下:
一个完全零成本的指标——"对话完成位"(conversation completion bit),也就是判断对话是否正常结束。
图6 零成本补救方案对比
当然,这个零成本指标也有局限:它只能捕获"严重退化"(比如对话直接中断),对于那种"对话正常结束但答案错了"的失败类型就无能为力了。
基于上述问题,可以使用"先校准再信任"(calibrate-then-trust)的策略,核心包含三个具体方案:
一:加一个"任务完成开关"
检查对话结束时,任务是否真的完成了(比如订单到底改没改)。
二:各种指标混合使用
| | | |
|---|
| | | 每次发版前必跑拦截“嘴炮满分,实际0分”的严重翻车 |
| | | |
| | | 更换新标准时比如刚换了AI裁判,用它测测新尺子准不准 |
三:三条铁律
1. 永远不要只看满意度——尤其当你在拿它当优化目标时(会催生"应试教育"式的作弊AI)
2. 裁判和选手是同一家公司时,请换个公司的裁判来定及格线
3. 评估体系换配置后要重新校准,旧校准参数不能一直用
六、总结
第一,"满意度"不等于"成功"。不管你是用AI还是真人来评满意度,都不能直接等同于任务完成了。做产品评估时,一定要看硬指标(任务完成率、转化率等),不能只看用户满意度评分。
第二,评估工具在近等强对比时最不可靠。当你需要在几个优秀的候选方案中做选择时,任何评估工具都可能出错。这时候需要更严格的测试方法,不能盲目相信评分。
第三,低成本信号有价值但有限制。"对话完成位"这样的零成本信号可以作为第一道防线,但不能替代深度审计。好的评估体系应该是多层次的。
第四,警惕"指标游戏"。当你开始优化某个指标时,这个指标往往会和真实目标脱节(这就是著名的Goodhart定律)。不要只盯着一个评分数字,要多维度看问题。
参考文献:
Bodhwani, U., Tran, T., Wei, K. GAUGE: When Not to Trust LLM-as-a-Judge in User-Simulated Evaluation of Task-Oriented Agents. arXiv:2609.12191v1, 2026.