导读:这篇拆腾讯的 Agent 评测体系。主线一句话:Agent = Model + Harness,评测是 Harness 自身的一层。从底座的 Harness 工程化讲到平台矩阵全景,再下钻到内部平台 EvalMate 的三层设计(能力四件套、三引擎质量飞轮、TestMate 测试智能体),最后是可以照抄的发布门禁阈值和 10 条工程启示。
📖 本篇目录 01 问题定义:Agent = Model + Harness 02 Harness 工程化:评测可归因的前提 03 链路六环节与两个被忽视的量化指标 04 平台矩阵:四层分工一张图 05 EvalMate 之一:能力四件套 06 EvalMate 之二:三引擎质量飞轮 07 EvalMate 之三:TestMate 测试智能体 08 发布门禁:可量化的 Pre-Launch 清单 09 六维度量标准与 Skill 安全闭环 10 工程启示(10 条)
01 问题定义:Agent = Model + Harness
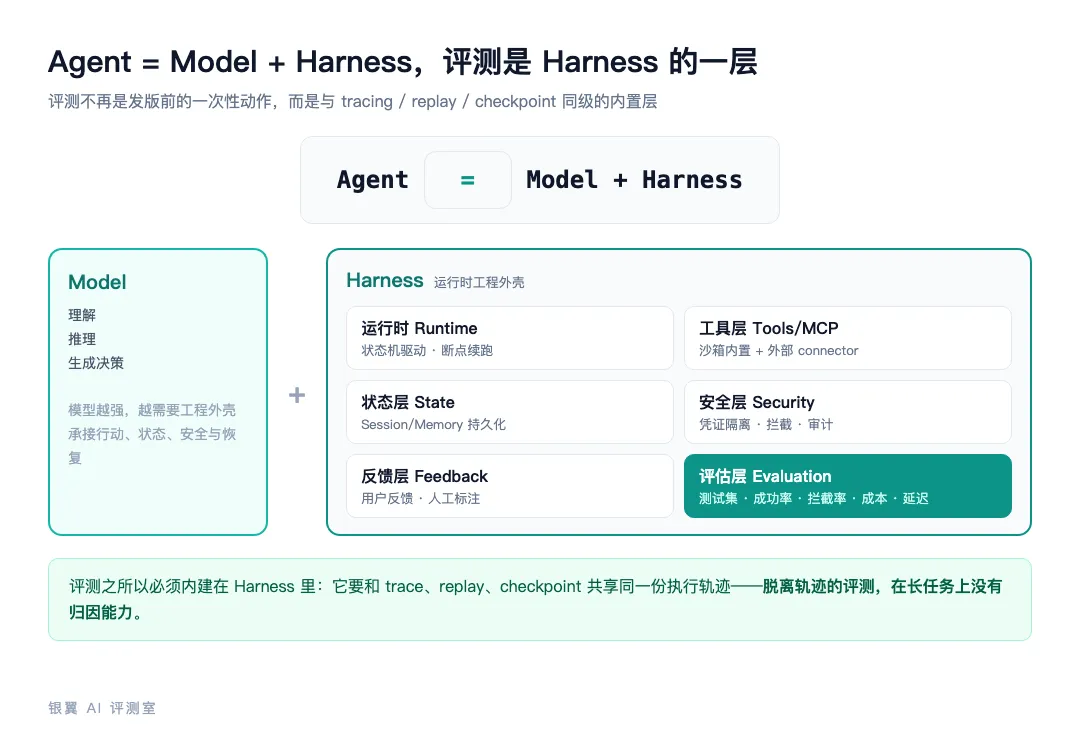
腾讯云 ADP 把 Agent 的定义写成一形式化等式:
Agent = Model + HarnessModel : 理解、推理、生成决策Harness : 运行时 + 工具层 + 状态层 + 安全层 + 反馈层 + 评估层
这个定义对评测的含义:评测不是发版前的一次性动作,而是 Harness 的内置层,与 tracing、logging、replay、checkpoint 同级。观测能力分两组:Observability/Transcript(对话记录、模型调用、工具调用、错误、耗时、token)与 Evaluation/Feedback(测试集、人工反馈、任务成功率、安全拦截率、成本、延迟)。
▲ 评测内建在 Harness 里,与 trace、replay、checkpoint 共享同一份执行轨迹
腾讯的判断是:只靠更强的模型加一个 Prompt,不足以稳定完成真实复杂任务。评测之所以内建在 Harness 里,是因为它必须和 trace、replay 共享同一份执行轨迹,脱离轨迹的评测在长任务上没有归因能力。
02 Harness 工程化:评测可归因的前提
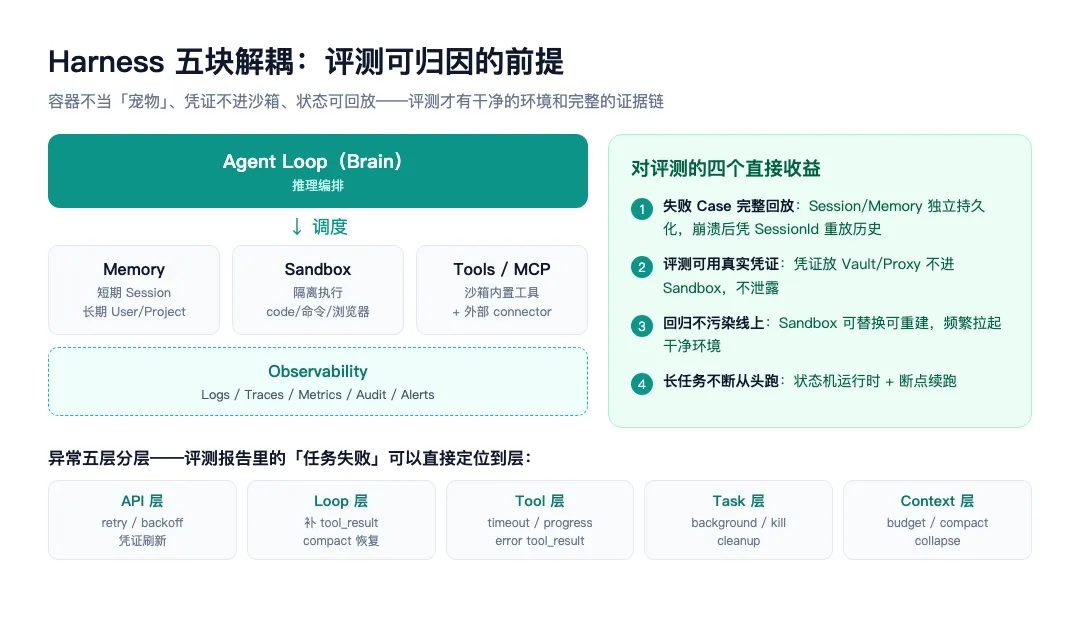
传统 CLI Agent 把 memory、sandbox、agent loop 全打包在容器里,遇到的问题:容器挂了状态丢失;排障要进用户容器有隐私风险;Prompt injection 可能读到环境变量里的 token。ADP 的解法是五块解耦:
▲ 五块解耦 + 异常五层分层:评测报告里的「失败」可以直接定位到层
当评测报告里出现「任务失败」,可以直接定位是哪一层抛出的(API/Loop/Tool/Task/Context)。这是可观测性对评测的反向赋能:没有分层,评测只能告诉你失败了;有了分层,评测能告诉你为什么失败。
03 链路六环节与两个被忽视的量化指标
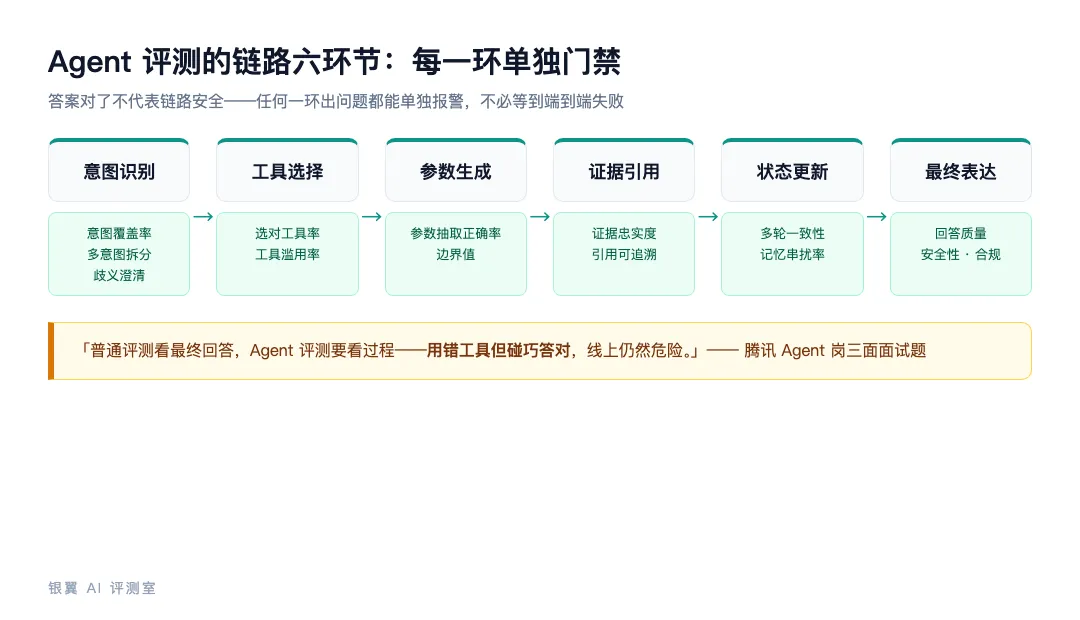
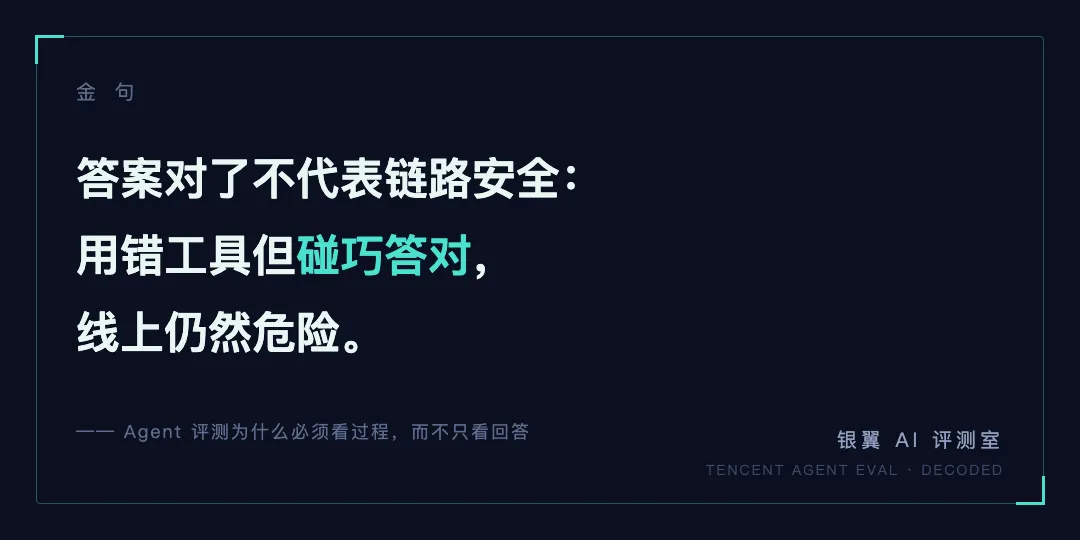
腾讯内部面试题把 Agent 评测与传统大模型评测的差异讲得很直白:答案对了不代表链路安全,用错工具但碰巧答对,线上仍然危险。评测要拆成六个环节分别度量:
▲ 链路六环节:任何一环出问题都能单独报警,不必等到端到端失败
六环节之外,有两个量化指标在公开资料里出现得不多,但很能代表腾讯的思路:
Tool Head Accuracy(工具选择正确率):任务结果对,不等于工具调用链正确。这个指标专门抓「碰巧答对」的样本,是结果分之外的第二道闸。Trajectory Match Score(轨迹匹配分):实际执行路径与最优路径的编辑距离,除以最优路径长度。衡量的是「绕了多少冤枉路」——两个 Agent 任务成功率一样,绕路多的那个成本高、时延长、失败面大。
测试集构造也有明确原则:不能只放理想问题,要覆盖模糊意图、缺参数、权限不足、工具超时、知识冲突、用户改口这些异常场景。每条样本标注「期望行为」而非「期望答案」:权限不足时正确行为是拒绝并解释,不是努力绕过。线上坏例(事故、投诉)转为回归样本,防止问题回潮。
04 平台矩阵:四层分工一张图
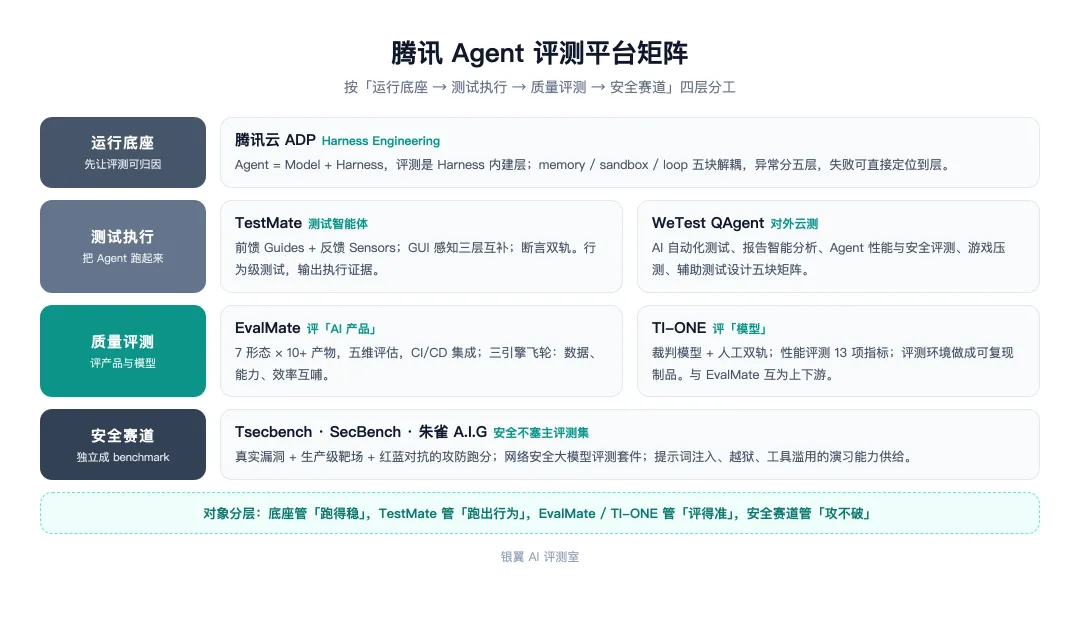
看单点之前先看全景。腾讯的 Agent 评测能力不是一款产品,而是一组按层分工的平台:底座管「跑得稳」,测试执行管「跑出行为」,质量评测管「评得准」,安全赛道管「攻不破」。
▲ 平台矩阵四层:运行底座 → 测试执行 → 质量评测 → 安全赛道
矩阵里有两条容易被忽略的分工线。其一是评测对象的分工:EvalMate 评「AI 产品」(行为链加多模态产物),TI-ONE 评「模型」(训练阶段的功能与性能),互为上下游;其二是安全独立成赛道:Tsecbench 用真实漏洞加红蓝对抗做攻防跑分,SecBench 专测安全大模型,都不塞在主评测集里走过场。
接下来下钻矩阵里方法论密度最高的一块:EvalMate。
05 EvalMate 之一:能力四件套
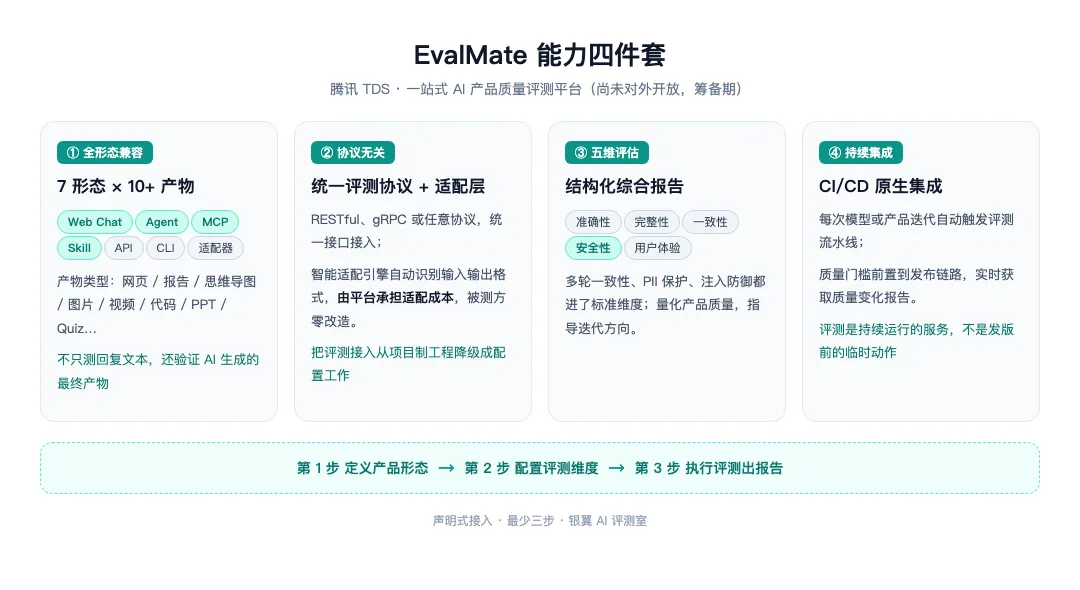
EvalMate 是腾讯端服务(TDS)产品联盟出品的一站式 AI 产品质量评测平台,和 Bugly、Kuikly、TDesign 同属一个联盟。截至 2026 年 9 月官网仍标注「尚未对外开放」,主要服务腾讯内部业务。看它怎么设计,比看它开没开放更有价值。
▲ EvalMate 能力四件套:全形态、协议无关、五维评估、持续集成
第一个设计决策值得单独说:评测对象是「AI 产品」而不是「模型」。7 种产品形态覆盖 Web Chat、Agent 多轮交互、MCP 工具调用、Skill、API、CLI、适配器应用;10+ 种产物类型覆盖网页、数据分析报告、思维导图、图片、视频、代码、PPT。理由很朴素:Agent 的输出是行为链加多模态产物,不是单条文本。没有产物类型感知能力的评测平台,评不了真正的 Agent 应用。
第二个设计决策是协议无关:不绑定 RESTful 还是 gRPC,统一评测协议加智能适配引擎,由平台承担适配成本。这把「评测接入」从项目制工程降级成了配置工作,被测方零改造。接入成本决定用户是否愿意持续使用,这一条是平台化的关键。
06 EvalMate 之二:三引擎质量飞轮
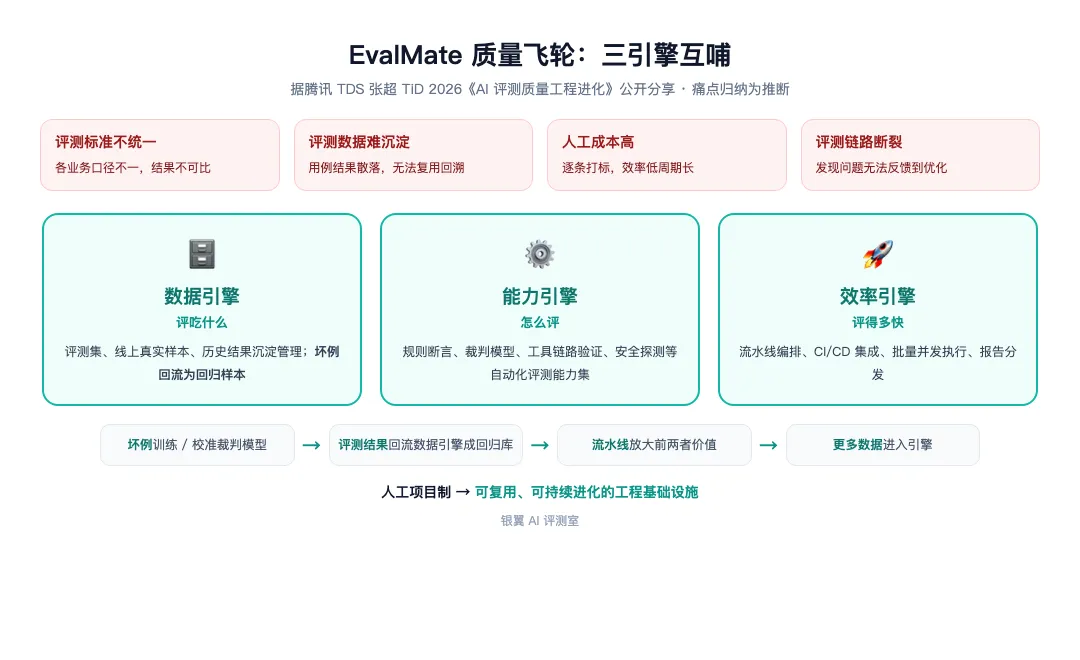
EvalMate 的工程理念是一条完整主线:四大痛点、四阶段演进、三引擎互哺、质量飞轮。官方没有逐条公布痛点全文,结合产品能力归纳如下:
▲ 三引擎互哺:数据管「评什么」,能力管「怎么评」,效率管「评得多快」
数据引擎:评测集、线上真实样本、历史评测结果的沉淀管理,坏例回流为回归样本。解决「评测数据难沉淀」。能力引擎:规则断言、裁判模型、工具链路验证、安全探测,自动化评测能力集。解决「人工成本高」。效率引擎:流水线编排、CI/CD 集成、批量并发执行、报告分发。解决「评测链路断裂」。
关键在互哺关系:数据引擎产出的坏例训练和校准能力引擎的裁判模型;能力引擎的评测结果回流数据引擎,形成更丰富的回归库;效率引擎让全链路规模化运转,放大前两者的价值。循环起来就是「数据 → 能力 → 效率 → 更多数据」的飞轮。
这个设计的落点是定位转变:EvalMate 不把自己当「评测工具」,而是「AI 质量保障的基础设施」。评测从每次项目临时做,变成持续运行的服务;评测资产(用例、结果、裁判模型)可复用可积累。
07 EvalMate 之三:TestMate 测试智能体
EvalMate 不是孤岛,TDS 联盟里有一个直接供给「执行证据」的协同产品:测试智能体 TestMate。它把 Harness Engineering 理解成一套控制系统:
前馈控制(Guides):知识、规则、提示词、代码风格、质量策略、任务规范,在智能体执行前限定目标和行为边界;反馈控制(Sensors):单元测试、接口测试、行为测试、运行状态、线上信号,在执行后提供验证结果和证据。 反馈再分两轨:确定性反馈管明确规则和固定步骤,推理型反馈管复杂语义和不完整信息。
四个工程细节最见功力:
双输入模式:目标式输入只给抽象任务目标,智能体自行规划,用于探索性测试;规格化输入通过 BDD、测试契约描述前置条件和预期,按规格执行,用于常规回归。探索空间和生产可控性分开保留。GUI 感知三层互补:优先读 Web DOM、Android 可访问树等结构化信息;不足时视觉小模型补充环境描述;复杂语义判断再上调多模态大模型。便宜的先上,贵的兜底,成本结构清晰。断言双轨:确定性规则和大模型语义判断按断言类型选择,同时保留执行步骤、状态、失败原因和验证证据。机械判据优先,语义判断兜底。落地节奏:先用种子用例验证基础能力,再扩展同类任务,依次补偿用例可执行性、治理稳定性、优化效率,全程用 Token 消耗、单次成本、成功率、失败分布做观测。
还有一条与之配套的「用例生成自进化」路线:AI 生成测试用例的真正难点不在生成,在于真实工程中持续可用、越用越好,从规则约束到自动化被拆成六个演进阶段。这条线与 EvalMate 数据引擎里「评测集自动扩充」是同一个方向。
08 发布门禁:可量化的 Pre-Launch 清单
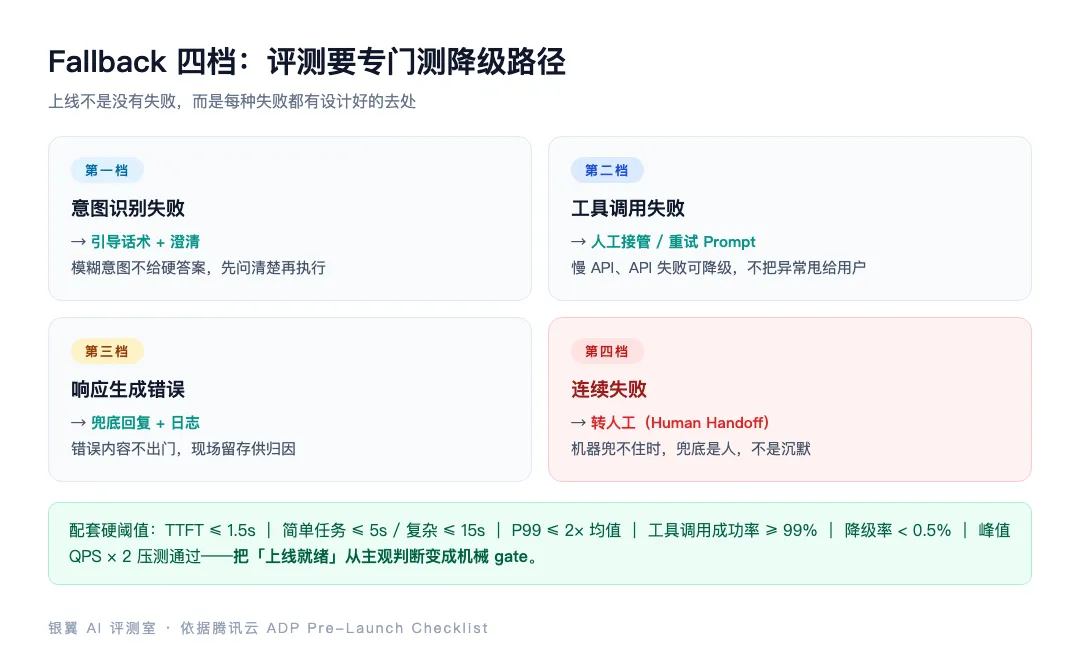
腾讯云 ADP 公开的 Agent 上线前检查清单,给出了一组可直接照搬的阈值:
▲ Fallback 四档:上线不是没有失败,而是每种失败都有设计好的去处
功能侧同样机械可查:50+ 真实用户短语测意图覆盖、历史聊天记录测边缘 case、组合问题测多意图拆分、故障注入测超时降级。这份清单的工程价值在于把「上线就绪」从主观判断转成可机械执行的 gate。
09 六维度量标准与 Skill 安全闭环
腾讯参与编制的《云上 Agent 基准度量模型》从六个维度度量云上 Agent:功能性(任务成功率、意图识别准确率)、安全性(注入防御率、工具滥用率、隐私数据输出率)、可靠性(记忆串扰率、行为可追溯率)、用户体验(满意度、转人工率)、性能效率(TTFT、P99)、成本效益(Token 消耗、单任务成本)。两个机制设计值得一提:双重授权按业务影响分级设人工确认,人类批准依赖度分层把「哪些环节必须人管」变成可度量的指标。首批通过认证的是腾讯 WorkBuddy、CloudQ、AndonQ、MigraQ 四款产品。
Skill 治理做成三段闭环:注册阶段异步安全扫描(Skill 描述、Prompt、脚本、依赖、工具声明),执行阶段实时检测工具调用和网络文件访问并高危拦截,输出阶段天御安全实时审核。本质是把传统应用安全的「构建 → 部署 → 运行」三段式平移到 Skill 生态。
10 工程启示(10 条)
1. 评测内建 Harness:与 tracing/replay 共享轨迹,否则长任务不可归因;2. 链路六环节独立门禁:意图/工具/参数/证据/状态/表达各设阈值;3. Tool Head Accuracy 与轨迹编辑距离:抓「碰巧答对」和「绕冤枉路」,结果分之外的第二道闸;4. 期望行为替代期望答案:权限不足的正确行为是拒绝,写进用例的是行为不是答案;5. 三引擎飞轮起步模板:先攒评测集(数据),再加规则断言+裁判模型(能力),最后接 CI/CD(效率),顺序别反;6. 感知与断言分层上调:结构化信息优先,小模型补位,大模型兜底,断言机械优先;7. 发布门禁阈值化:TTFT ≤1.5s、工具成功率 ≥99%、降级率 <0.5%,照抄可用;8. Skill 三段安全闭环:注册扫描 → 执行拦截 → 输出审核;9. 安全评测独立成 benchmark:不要塞在主评测集里走过场;10. 批量对比是刚需:模型/Prompt/版本切换必须内建 A/B 对比,评测集从线上坏例持续回流。
▲ 为什么 Agent 评测必须看过程,而不只看回答
参考资料:腾讯云 ADP《Harness Engineering 如何驱动云端智能体》(2026-07)|ADP Pre-Launch Checklist / Enterprise Agent Security Governance|TDS EvalMate 官网(tds.qq.com/evalmate)|TDS 张超 TiD 2026《AI 评测质量工程进化》|腾讯 PCG 张晔 TiD 2026《构建 AI Coding 的质量反馈闭环:测试智能体的工程化实践》|WeTest《打造全新 QAgent》(2025-10)|TI-ONE 自动评测与性能评测文档|《云上 Agent 基准度量模型》(信通院,2026-07)|Tsecbench / SecBench / 朱雀 A.I.G 安全演习
—— END ——