十大品牌
当前位置:
首页
>
排行榜
>具身智能如何评测?为什么一次成功演示不算答案
具身智能如何评测?为什么一次成功演示不算答案
更新时间 2026-10-09 00:21:13
具身智能如何评测?为什么一次成功演示不算答案
一段机器人演示里,机械臂识别杯子、完成抓取,再准确放进收纳箱。
动作很流畅,但它能证明机器人已经学会这项任务吗?
不一定。
这可能是几十次测试中最好的一次,也可能依赖固定灯光、固定机位、固定杯子和人工提前摆好的位置。只要换一个杯子、移动收纳箱,或者让任务多执行几步,成功率就可能明显下降。
这正是具身智能评测要解决的问题:不用一段精选视频判断能力,而是用可重复的测试,测量机器人在变化、扰动和物理约束下完成任务的真实水平。
一句话先说清
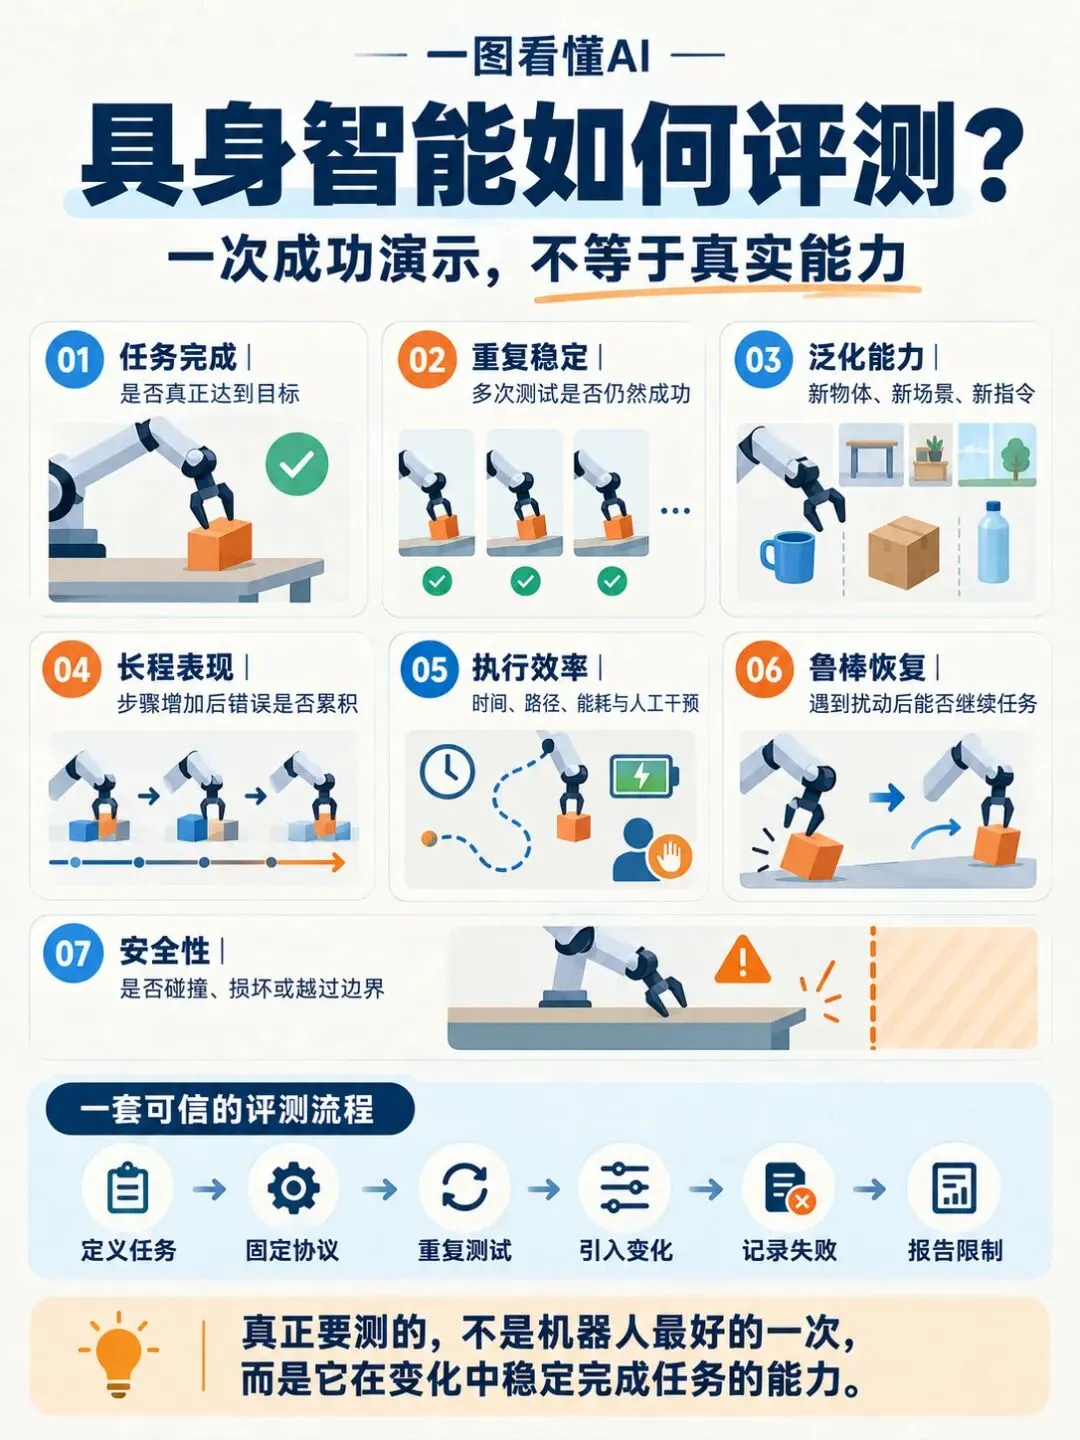
一套可信的具身智能评测,至少要同时回答七个问题:
任务是否完成、结果是否稳定、条件变化后能否泛化、长任务会不会累积错误、执行是否高效、遇到意外能否恢复、整个过程是否安全。
01|演示和评测有什么区别
演示回答的是:“机器人曾经成功过吗?”
评测回答的是:“在事先规定的条件下,它成功多少次,失败在哪里,换一种条件还能不能成功?”
两者最大的区别,是评测必须提前固定规则:测试哪些任务、物体如何摆放、允许使用哪些传感器、能否人工干预、一次运行多长时间,以及怎样判定成功。
如果成功之后才修改标准,或者只公布效果最好的一次,结果就无法比较,也难以复现。
02|第一项指标:任务完成率
最常见的指标是成功率:在多次独立测试中,机器人完整达到目标的比例。
但“成功”必须写得足够具体。
对于“把杯子放进收纳箱”,可以要求:杯子完全进入箱内、保持稳定、夹爪已经释放,并且过程中没有碰倒其他物体。
长任务还可以设置阶段性得分。例如机器人找对杯子、完成抓取、移动到箱体上方,分别获得部分分数。BEHAVIOR挑战就允许按照目标条件的完成程度计算部分进展,而不是只看最终的零或一。
这能帮助研究者定位问题究竟发生在感知、抓取、规划还是控制阶段。
03|为什么不能只测几次
机器人动作会受到摩擦、传感器噪声、物体位置和控制误差影响。同一套策略运行十次,结果也可能不同。
因此,评测不应只给出“成功率90%”,还要说明:
• 测试了多少次;
• 不同任务各自表现如何;
• 是否报告波动范围;
• 失败是否集中在某些物体或位置;
• 是否有人在中途纠正机器人。
测试次数太少时,一两次偶然成功就可能明显抬高分数。多个模型相差几个百分点,也未必代表真实能力存在稳定差异。
04|第二层能力:换条件还能不能做
真正有价值的机器人不能只记住训练场景。
泛化评测通常会改变一个或多个条件:
• 新物体:换杯子的颜色、大小、材质或形状;
• 新场景:改变桌面、房间、背景和光照;
• 新位置:移动目标物体和收纳箱;
• 新指令:用不同语言表达同一个目标;
• 新组合:把学过的技能重新组合成没见过的任务;
• 新身体:把策略迁移到不同机械臂、夹爪或机器人平台。
LIBERO重点研究机器人在持续学习中的知识迁移;RoboCasa365则把任务放进大量厨房环境,用不同场景和任务组合检验通用策略。
如果训练数据与测试环境非常接近,高分可能反映的是“见过相似样本”,而不是学会了可迁移的能力。
05|长任务要看错误如何累积
抓取一次成功,不代表机器人能完成十分钟的整理任务。
长任务由多个步骤组成:寻找物体、接近、抓取、移动、避障、放置、检查结果。假设每一步成功率都是95%,连续完成十个相互依赖的步骤,整体成功概率也会明显下降。
因此,长程评测还应记录:完成了多少步骤、在哪一步首次失败、是否出现状态遗忘,以及前面的微小偏差怎样影响后续动作。
BEHAVIOR-1K包含1000种日常活动,并强调长任务和复杂操作;它的价值就在于把评测从单次抓取扩展到更接近真实生活的完整任务。
06|成功之外,还要测效率和恢复
两台机器人都能完成任务,过程可能完全不同。
一台用20秒完成,另一台需要两分钟;一台走最短路径,另一台反复试探;一台全程自主,另一台需要人工接管三次。
因此还要记录:
• 完成时间和动作步数;
• 运动路径长度与能耗;
• 重试次数和停滞时间;
• 人工干预次数;
• 遇到滑落、遮挡或目标移动后能否恢复。
恢复能力尤其重要。真实环境不会保持静止,机器人能否发现偏差、回到可控状态并继续任务,往往比一次完美轨迹更有价值。
07|完成任务,不代表过程安全
机器人把鸡蛋拿到了指定位置,但途中把它捏裂;把水倒进杯子,却洒到了电脑旁边。按照只看终点的成功标准,这些动作仍可能被算作成功。
安全评测需要额外记录碰撞、接触力、物体损坏、液体泄漏、危险区域侵入和紧急停止等事件。
OopsieVerse把机械、温度和液体造成的损坏转成可测量信号,并在32项家庭任务中区分“容易但危险”和“更慢但安全”的策略。
这说明具身智能的目标不应只是完成任务,而是以可接受的方式完成任务。
08|仿真高分为什么还不够
仿真环境便于控制变量、重复上千次实验,也能低成本测试碰撞和失败。
但真实世界存在材料差异、传感器噪声、相机曝光、执行延迟和难以完整模拟的接触过程。模型在仿真排行榜上领先,并不意味着它在真实机器人上仍然领先。
更完整的评测通常分三层:
1. 在仿真中进行大规模标准测试;
2. 在受控实验室中使用真实硬件复测;
3. 在更接近部署现场的环境中测试长时间稳定性。
三层结果应分别报告,而不是把仿真成绩直接写成真实世界能力。
09|排行榜也可能测错东西
基准测试本身并不天然可靠。
2026年的一项预印本审查了LIBERO、CALVIN、SimplerEnv、RoboCasa和RoboTwin 2.0,提出四类风险:任务可能存在捷径、分数差异缺乏统计显著性、研究长期围绕固定测试集调优,以及训练数据与测试分布过于接近。
这项工作尚属预印本,但它提醒我们:排行榜分数是特定协议下的结果,不是“通用机器人能力”的直接证明。
看榜单时,既要问谁的分数高,也要问测试集是否足够难、是否真正需要语言理解、是否公开训练数据,以及换一批场景后排名会不会改变。
分析机器人演示时,可以这样提问
请区分演示结果和正式评测,并说明:任务成功标准是什么,共测试多少次,是否报告不同任务的分项结果和波动范围;测试是否包含新物体、新位置、新场景和扰动;是否记录时间、重试、人工干预、碰撞与物体损坏;结果来自仿真、实验室还是真实部署。如果缺少测试协议或失败案例,请明确说明无法据此判断通用能力。
最后一句
评测具身智能,不是寻找机器人最好看的一次,而是检验它能否在重复、变化、扰动和安全约束下,持续完成真实任务。
如果这类拆解对你有帮助,可以关注账号;后续会继续用详细文章分析具身智能基准、真实机器人测试与安全评测。
📎 参考资料
[1] BEHAVIOR-1K: A Benchmark for Embodied AI with 1,000 Everyday Activities and Realistic Simulation
https://proceedings.mlr.press/v205/li23a.html
[2] LIBERO: Benchmarking Knowledge Transfer for Lifelong Robot Learning
https://libero-project.github.io/main.html
[3] RoboCasa365: A Comprehensive Simulation Benchmark for Everyday Household Robotics
https://robocasa.ai/assets/robocasa365_iclr26.pdf
[4] OopsieVerse: A Safety Benchmark with Damage-Aware Simulation for Robot Manipulation
https://robin-lab.cs.utexas.edu/oopsieverse/
[5] What Are We Actually Benchmarking in Robot Manipulation?(预印本)
https://arxiv.org/abs/2606.04233
本文来自网友投稿或网络内容, 如有侵犯您的权益请联系我们删除, 联系邮箱:wyl860211@qq.com 。
#豆腐怎么选 #买菜技巧 #生活小妙招#
三大国产墨水屏品牌产品学习笔记
热门文章
黄三色是哪三色颜色的?解析黄三色的具体颜色及其应用
十大平板拖把品牌排行榜_什么牌子的平板拖把好
第一次做ae视频一般多少秒,制作视频的时长建议
十大免费mp3音乐网站_mp3歌曲下载网站哪个好_MP3音乐网站大全
达泊西汀十大品牌排行榜_达泊西汀品牌排名_达泊西汀品牌排行榜
十大必看番号有哪些?你知道哪些是值得一看的热门番号吗?
亚洲尺码和欧洲尺码区别是什么
包机和专机的区别是什么?
随机文章
10个月宝宝每天需要喝多少奶粉?是否有一个标准量?
十大必看番号有哪些?你知道哪些是值得一看的热门番号吗?
宝宝喝奶粉消化不良怎么办?
Is "How do you pronounce 'formula' in English?" a Common Question for New Parents?
米诺地尔十大品牌排行榜_米诺地尔品牌排名_米诺地尔品牌排行榜
wow十大板甲幻化
用120毫升的水放几勺奶粉:你真的知道吗?
MRO工业品十大采购平台-工业品一站式采购平台排行榜
三轮车十大品牌排行榜:三轮车品牌十大排行榜:三轮车什么牌子好:2025