不同的实验数据,统计学方法该如何选择?
- 更新时间 2026-10-09 00:12:06
不同的实验数据,统计学方法该如何选择?数据出来了,第一反应往往是跑个 t 检验看看。两组先比一比,三组还是比一比,p 小于 0.05 就当结论写进图注。 问题是方法选错,图再漂亮结论也立不住。统计方法不是按几组挑一个那么简单,它是一连串判断题,前面答错了后面全歪。 
图源:https://share.google/pzeMSjMjl4VGOIQ0T 一篇讲检验选择的综述(PMC2996580)把这个流程拆成六个问题:你有多少个自变量、自变量和因变量分别是什么测量尺度、观测之间是独立还是配对、你比的是样本和总体还是样本和样本、假设是比较还是看关联。 
落到湿实验里,最核心的其实是三件事。 第一,因变量是什么类型。测的是 OD、粒径、体重、荧光强度这种数值,叫连续变量;算的是阳性率、存活死亡、分型比例,叫分类变量。类型不同,整个检验家族就变了。 第二,你要比几组、是不是同一批对象。两组独立、三组以上、还是同一个动物造模前后配对测,走的是完全不同的路。 第三,连续变量还得看分布。正态就用参数检验,更敏感;明显偏态就把数据换成秩、走非参数。小样本没法靠中心极限定理兜底,正态性得真去验,Shapiro-Wilk 或者看 Q-Q 图、直方图都行;方差齐不齐用 Levene 检验。 CASRAI 的指南甚至建议默认跑 Welch 版 t 检验,因为它不要求方差相等,比死磕方差齐性更稳。 把这三件套进去,常见组合基本就这些,这是核心映射不是全部: 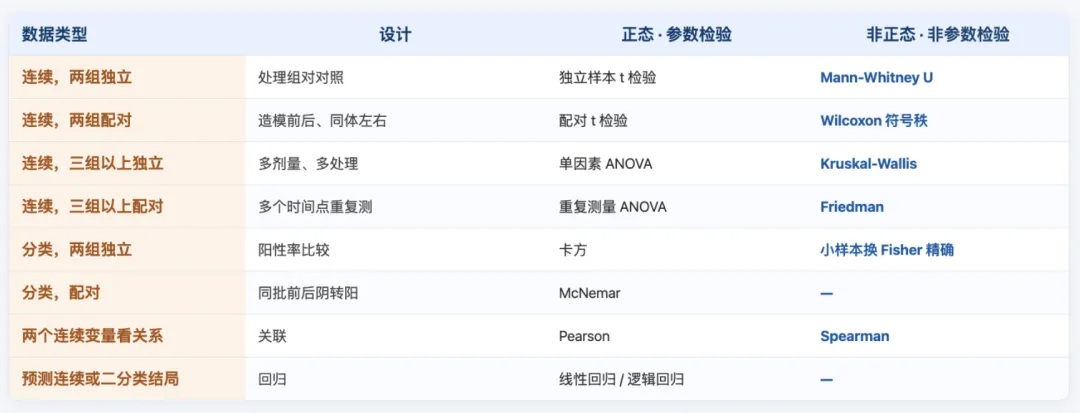
几个容易踩的坑:两组不要用 ANOVA 去比,多此一举还容易算错;两组独立的别拿配对检验硬套;分类变量里只要有格子的期望计数小于 5,卡方就开始不准,得换 Fisher 精确检验。 单因素 ANOVA 只回答一句话,这几组里至少有两组不一样,它不告诉你谁和谁不一样。要定位差异得接着做多重比较,这一步是论文里被审稿人撕得最狠的地方。 逻辑是这样的:如果你比 5 个组,两两比要跑 10 个 t 检验。即使组间真的没差异,每个检验 α=0.05,跑 10 次至少有一个假阳性的概率已经接近 40%,不是 5%。这就是 family-wise error 失控,所以多组比完必须做校正,不能拿一堆裸 t 检验硬上。 校正方法怎么选,得看你的问题。你要比的是每一组和每一组,Tukey HSD 是对的路子,假设方差齐,控制整体假阳性率的同时比所有配对,是这类问题的默认选择。 你只关心每个给药组跟对照组比、不关心给药组之间,用 Dunnett,它比把对照当普通组塞进 Tukey 更灵敏,因为省掉了你根本不关心的配对。 你只提前计划好少数几对,比如就比 3 对,用 Bonferroni 或者 Holm,按比较次数把 α 往下压,但它很保守,比较一多就过于严格、容易放过真差异。 方差不齐,Levene 显著,先换 Welch ANOVA,事后用 Games-Howell,别硬跑 Tukey。 还有两个细节审稿人常揪。一是 ANOVA 显著之后再跑 Tukey 才是标准流程,没显著就做两两比较容易刨出假显著。二是报告要写清楚,用了哪个校正、给的是调整后的 p 还是裸 p,给裸 p 等于白校正,效应量一并给。 非参数这边也有坑,Kruskal-Wallis 之后拿一堆 Mann-Whitney 两两比是不对的,因为每次只给那两组重新排秩,跟原检验的秩不一致,应该用 Dunn's 检验保留原始秩。如果是高通量筛查,比如几百个基因,控制 FDR 的 Benjamini-Hochberg 比死守 family-wise error 更合适,能保住检验力。 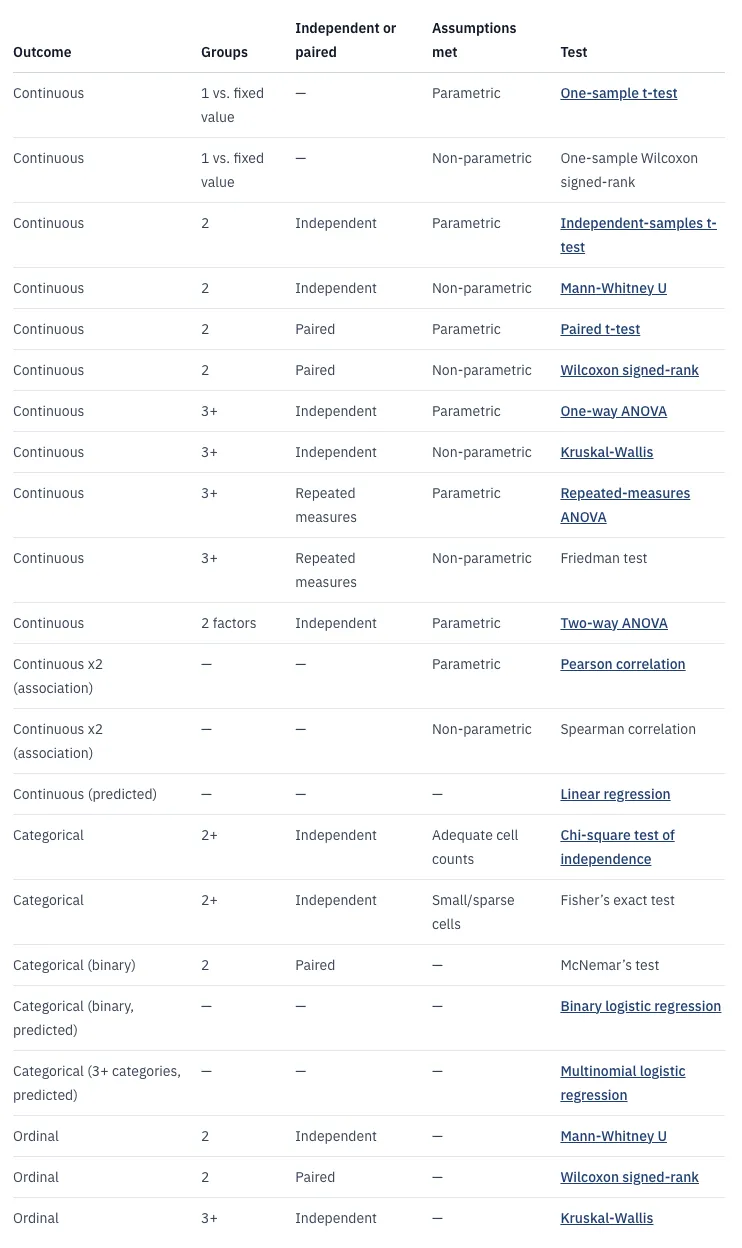
p 值最容易误读。p=0.03 不是有 97% 把握结论成立,它的意思是如果真的没差异,看到这么极端数据的概率是 3%。0.05 这个 cutoff 是 Fisher 当年拍板的,没有天然逻辑,所以 p=0.057 说边缘显著是胡说,要么显著要么不显著。 更麻烦的是反方向,p 大于 0.05 不等于没差异。它可能是真没差异,也可能是你样本太小、根本没能力抓住真实存在的差异,也就是二类错误。这时候该做的是功效分析,看你的设计到底有没有能力检出这个效应,而不是一句无统计学意义就翻篇。 功效分析绕不开四个量,你想检出的效应量、数据的变异也就是标准差、α、功效也就是 1-β,知道三个就能算第四个。 以动物实验为例,有篇专门算强迫游泳实验样本量的研究(DOI 10.1371/journal.pone.0243668)给了很实在的数字:测一个完全未知的新药,想以 80% 功效、α=0.05 检出至少中等的效应,Cohen's d=0.8,每组需要约 26 只;如果有前期证据支持单向假设,能压到约 21 只。而领域里默认的 7 到 10 只,在这套算法下是严重不够的,这也解释了为什么很多人凭直觉觉得够用了,其实实验是 underpowered 的。 实验室动物研究的效应量基准也跟社科不一样。NC3Rs 的实验设计指南里引用 Wahlsten 2011 的说法,小动物实验里小、中、大效应大致该按 d=0.5、1.0、1.5 来理解,而不是社科那套 0.2、0.5、0.8。 没有前期数据、估不出效应量和标准差的时候,还有个省事的办法叫资源方程法,ILAR 指南里写的:做 ANOVA 时让误差自由度 Error DF = N - k,N 是总动物数,k 是组数,落在 10 到 20 之间。 比如 3 组,Error DF=10 至少要 N=13,约 5 只每组;Error DF=20 最多 N=23,约 7 到 8 只每组。低于 10 不够力,高于 20 加动物收益递减。G*Power 是免费算样本量的工具,写基金和过 IACUC 都要用。 另一个常被忽略的点,置信区间比裸 p 诚实。小样本算出来的 CI 很宽,等于在说到底有没有效、效应多大我们其实不确定,这比报一个 p=0.04 但区间横跨零要实在。 把上面串起来,湿实验统计里最高频的硬伤大概这几条。 方法本身不神秘,难的是在拿到数据之前就把比什么、怎么比、n 定多大、要不要校正想清楚。临时抱佛脚选检验,最容易在审稿阶段露馅。 参考资料: [1] Choosing the statistical test. PMC2996580. [2] NC3Rs Experimental Design Assistant. 实验设计、组数与样本量、功效分析与效应量基准. [3] Kafkafi N et al. Effect size, sample size and power of forced swim test assays in mice. PLOS ONE 2021, DOI 10.1371/journal.pone.0243668. [4] Habibzadeh F. Common statistical mistakes in manuscripts submitted to biomedical journals. European Science Editing. [5] CASRAI. How to Choose a Statistical Test 与 Tukey HSD 指南. [6] GraphPad. Statistics Guide.
先把几个问题答完,方法自己会浮出来
多组比较才是翻车重灾区
显著和不显著都没你想的那么绝对
几个最常被审稿人揪出来的错
技术重复当生物学重复。3 个复孔算 n=3、3 张同一次转染的图算 n=3,其实 n=1。重复的类型决定了 n 是什么,这个我们之前专门写过。(为什么“做了三孔”不等于“做了三次”?一文讲透实验里最容易混淆的:技术重复和生物学重复) 不看分布就上参数检验。数据明显偏态还跑 t 检验,小样本下会把本不存在的差异说成显著。 多组比完不校正。上面说过,10 次裸 t 检验 40% 假阳性。 拿 p 当效应量。p 小不代表差异大,大样本下再小的差异也能显著。反过来,统计显著不等于有生物学意义,有篇编辑来信举的例子,两组血清胆固醇 189 对 187 mg/dL,p=0.031 显著,但这种差值临床上有没有意义要打问号,多半是样本量堆出来的。 事后补功效分析。结果出不来才去算我功效多少,这基本没意义,功效分析是设计阶段该做的。 相关当因果。Pearson 的 r 再高也只能写相关,写促进或抑制得有机制或干预证据撑着。 看见显著就收工,没看检验假设、没报效应量和 CI。
本文来自网友投稿或网络内容,
如有侵犯您的权益请联系我们删除,
联系邮箱:wyl860211@qq.com 。
