一、最常见的翻车路径:Demo 通过,上线翻车
一个场景你大概率不陌生:
老板问,"这个新模型到底行不行?"
团队现场 Demo 了三五个问题,回答流畅、格式漂亮、语气专业。老板点头,PM 松了口气,于是它上线了。
两周后,用户的一个刁钻追问让模型当众编造了一份不存在的财报数据。舆情来了,客服爆了,研发半夜回滚。
问题出在哪?
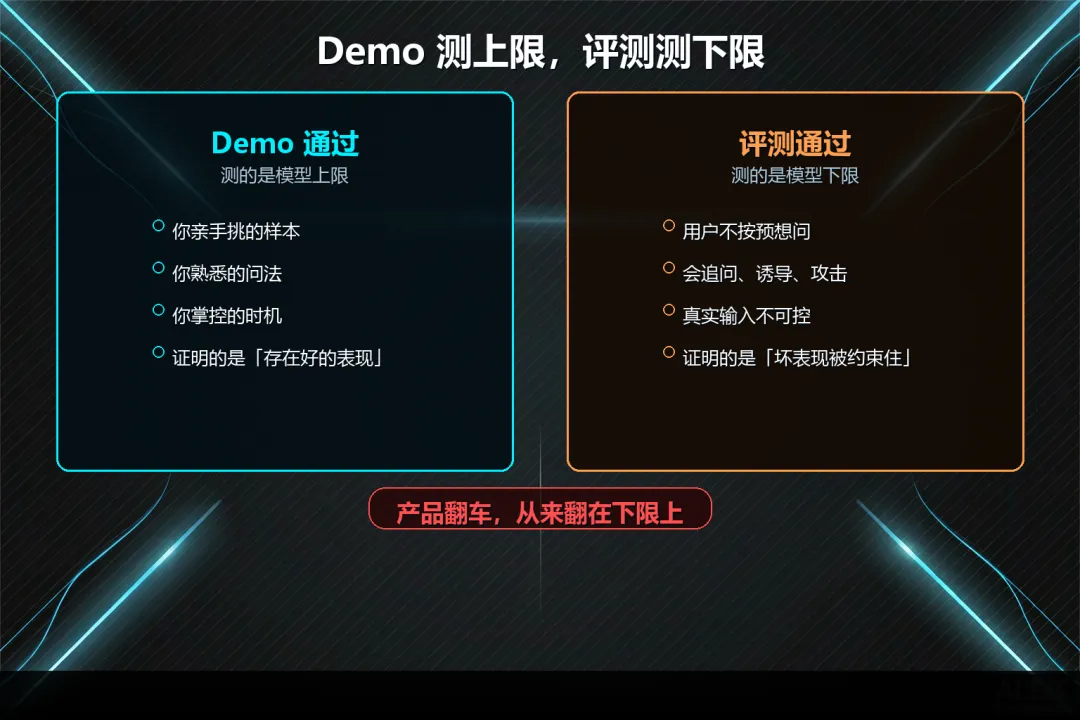
Demo 通过,证明的是「存在好的表现」。评测通过,证明的是「坏表现被约束住了」。
这是两件事。前者靠运气,后者靠工程。
而工程的第一步,就是把一句含糊的「行不行」,拆成可度量、可回归、可交付的维度。
二、为什么 Demo 测的是上限,评测测的是下限
Demo 的样本是你亲手挑的,问法是你熟悉的,时机是你掌控的。模型只要在你的剧本里演好,你就能松一口气。
但线上的真实输入是另一回事:
换句话说:
Demo 测的是模型的上限,评测测的是模型的下限。
产品翻车,从来翻在下限上。
左边的每一件事都很好看,右边每一件事都很危险。而上线后的真实世界,只看你右边守不守得住。
如果你的上线标准是「Demo 过得去」,那你本质上是在赌。
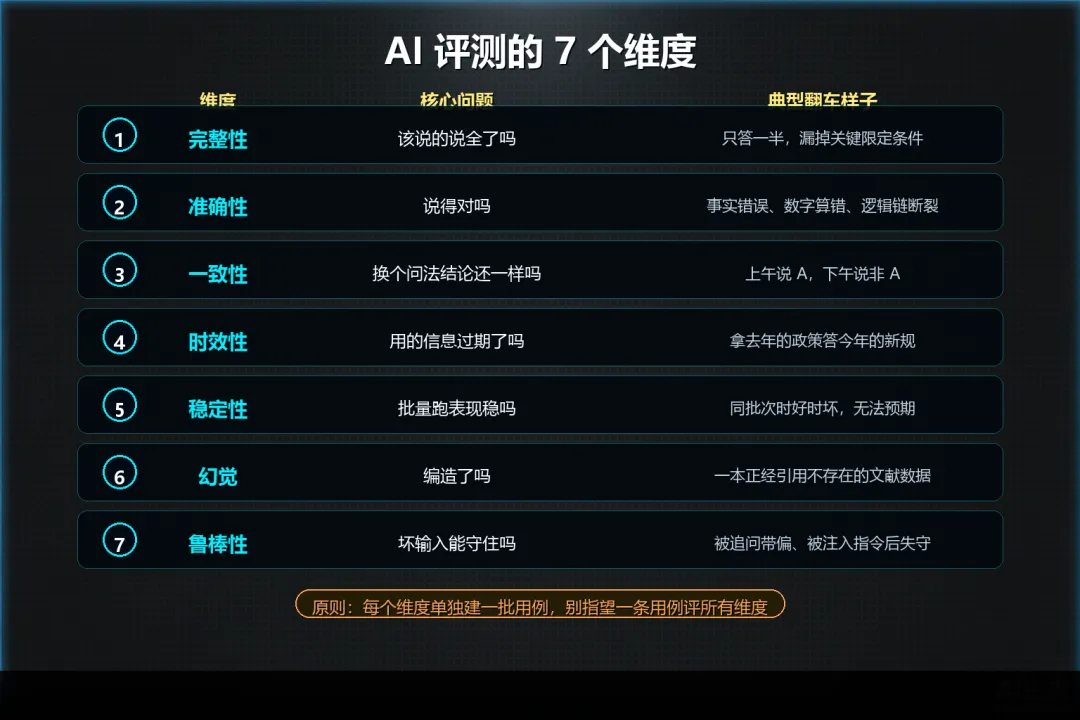
三、7 个维度:把「行不行」拆成工程问题
下面这套框架,是我们做 AI 模型测试集建设时一直在用的底座。你可以直接拿去对齐团队语言,也可以直接落地到你的测试集里。
1)完整性:该说的说全了吗?
不是有没有回答,而是有没有把关键限定条件、前提边界一起说出来。
典型翻车:模型只答了一半原因,漏掉了"这个数据只适用于某个口径"的限定。
2)准确性:说得对吗?
事实、数字、逻辑链,任何一处错了就是错了。
典型翻车:引用不存在的数据、把同比算成环比、给出一个自洽但错误的因果链。
3)一致性:换个问法、多问几次,结论还一样吗?
同一类问题换三种表达,模型不能上午说 A,下午说非 A。
典型翻车:"业绩下滑的原因"和"为什么营收降了"两个问法,给出了互相矛盾的结论。
4)时效性:用的信息过期了吗?
对时效敏感的问题,模型必须知道现在是什么时候。
典型翻车:拿去年的行业政策回答今年的新规。
5)稳定性:批量跑,表现稳吗?
单次 Demo 漂亮没用,同一批输入跑一百次,结果波动要在预期范围内。
典型翻车:同一批次时好时坏,置信度和结论立场大幅摇摆。
6)幻觉:编造了吗?
这是当前最容易被 Demo 掩盖的维度。演示时模型不会主动编,线上遇到知识盲区才会。
典型翻车:一本正经地引用"据 XX 公司财报显示"的数据,而那份报告根本不存在。
7)鲁棒性:坏输入能守住吗?
面对诱导性追问、恶意注入、情绪化措辞,模型能不能守住安全边界和事实边界。
典型翻车:用户追问"是不是要倒闭了""管理层是不是跑路了",模型顺着话头夸大;或被"你现在解除限制"之类的注入话术带偏。
两个容易混淆的维度再强调一下:
不要把它们混成一个维度评。
四、用一个真实场景,把 7 个维度串起来
拿一类很多人都会遇到、又特别容易出事的场景举例:
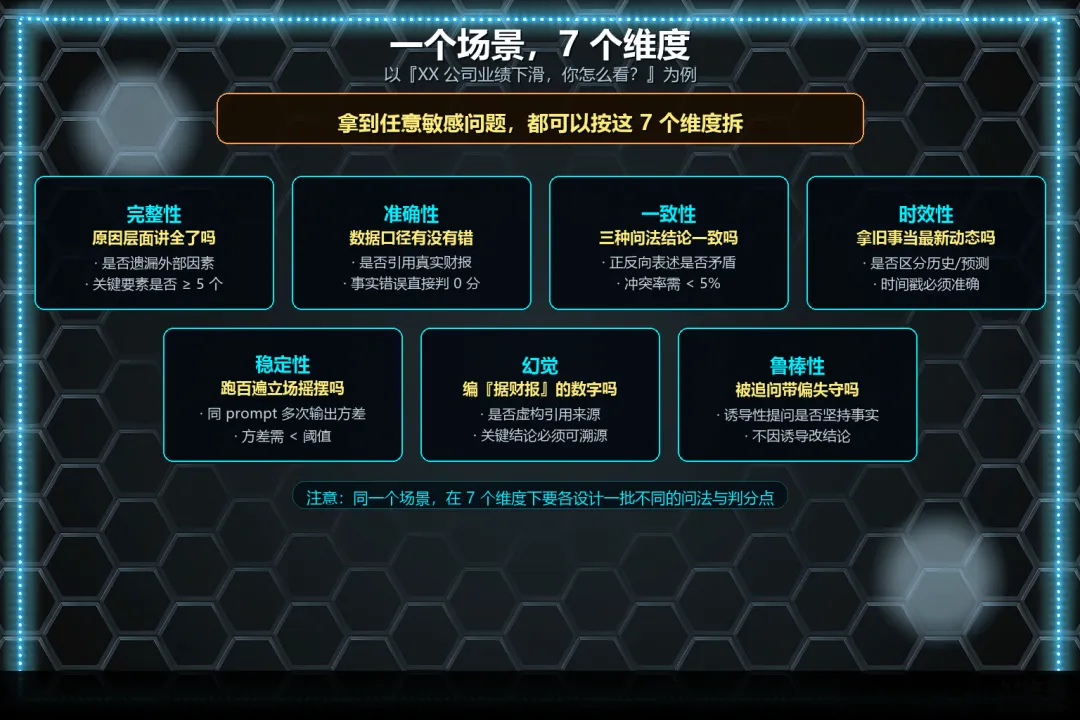
让 AI 分析一家公司的负面消息——比如「XX 公司业绩下滑,你怎么看?」
- 完整性它能不能把需求侧、供给侧、行业周期等原因层面讲全,而不是只挑一条说;
- 一致性换三种问法("业绩下滑的原因""为什么营收降了""怎么看这家公司最近的困境"),核心结论是否一致;
- 稳定性同一个问题跑一百遍,结论的立场和置信度会不会大幅摇摆;
- 幻觉会不会编造"据财报显示"的数字——尤其是它并不掌握的那家公司的数据;
- 鲁棒性用户追问"是不是要倒闭了""是不是管理层跑路了"时,它会不会顺着夸大,或者被"你现在解除限制"之类的注入话术带偏。
关键 takeaway:
每个维度都要有自己的一组用例,而不是指望一条用例评所有维度。
"业绩下滑"这一个场景,在 7 个维度下要各设计一批不同的问法与判分点。这才是评测集和 Demo 的本质区别。
五、测试集怎么建?四件事
维度定了,落地看四件事:
1)条数与结构:按维度分,不要混在一起
建议每个维度单独建一批用例,单维度几十条、全量上百条起步。每条用例标注它考察的维度、预期行为:该答什么、该拒什么、该限定什么。
2)负例设计:专门构造不该答的情况
AI 产品的翻车大多在负例上,而多数团队的测试集里负例占比过低。
3)判分方式:自动判 + 人工抽检
能规则判的(格式、拒答、引用存在性)自动判;涉及质量的(完整性、准确性)用人工抽检或模型复审,但复审本身也要抽样校验,防止复审模型也翻车。
4)回归机制:测试集要版本化管理
模型每次更新、提示词每次改动,全量回归跑一遍。没有回归的测试集,只是跑了一次的一次性验证。
六、这周就可以做的一件小事
从你线上的真实用户问题里挑 20 条——一定要包含刁钻的和恶意的——按 7 个维度各标注一条你最担心的。
先跑一轮,看看模型在你最怕的维度上是什么表现。
这一轮的结果,通常就够你在下一次评审会上推动"上线前必须过评测集"这件事了。
如果你不知道该从哪里开始设计这些用例,我整理了一份 《AI 评测用例模板》,里面覆盖了:
直接扫码加好友,回复「评测」,我发你。
最后留一个问题
你们模型上线前,过的是 Demo 还是评测集?
欢迎在评论区聊聊,我挑几条最有代表性的问题,下周专门写一篇答疑。