第12篇已经解决了第一层问题:同一个人的多次随访不是彼此独立,不能把每一行都当成一个新的独立样本。接下来真正进入纵向模型时,最常见的两个名字就是GEE和混合效应模型。
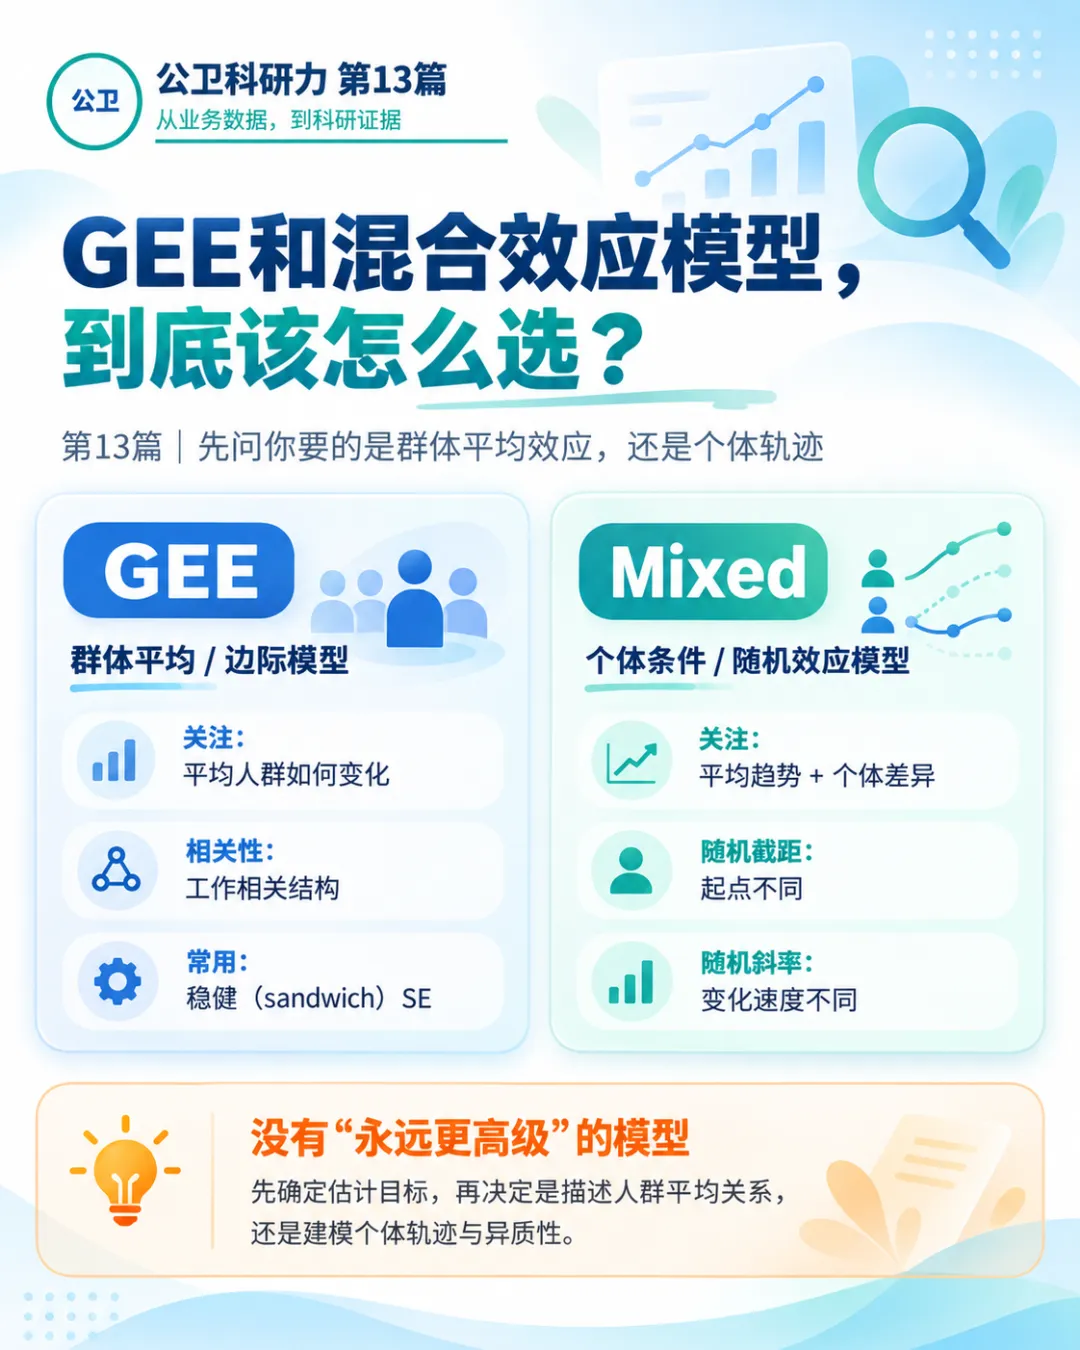
很多初学者会继续问:“哪个更高级?”这个问题本身就不对。GEE和混合效应模型都能处理重复测量,但它们对数据分布和相关性的建模方式不同,更重要的是,它们经常对应不同的估计目标。先问你究竟想描述“整个人群平均怎样变化”,还是想同时理解“不同个体怎样偏离平均轨迹”。
▌一、GEE:重点是总体平均关系
广义估计方程(generalized estimating equations,GEE)由Liang和Zeger系统提出。它把每个个体看作一个cluster,直接对结局的边际均值建立回归模型,同时用工作相关结构描述同一个体内重复观测之间的大致相关模式。
GEE最典型的解释是population-averaged或marginal effect。例如研究某种干预与反复测量的病毒抑制状态之间的关系,GEE更自然地回答:“在目标人群层面,接受该干预的人平均而言结局有多大不同?”它并不需要为每个人都估计一套独特的截距或斜率。
常见工作相关结构包括independence、exchangeable、AR(1)和unstructured。所谓“working”非常重要:它主要帮助描述同一cluster内的相关性。经典GEE配合稳健sandwich方差,在一定条件下即使相关结构指定得不完全正确,回归参数仍可获得稳健推断;但这并不意味着小样本、严重缺失或任意模型设定都自动安全。
▌二、混合效应模型:把个体差异本身放进模型
混合效应模型(mixed-effects model)除了固定效应,还引入随机效应。最容易理解的是随机截距:每个人可以有自己的起点;随机斜率则允许每个人随时间变化的速度不同。Laird和Ware早期的随机效应纵向模型正是这一类方法的重要基础。
因此混合模型不仅能给出总体的固定时间趋势,还能估计个体间异质性,并在模型假设下得到个体条件预测。对于想研究“哪些人恢复得更快”“同一个人相对于自己的基线怎样变化”等问题,这种结构往往更贴近科学问题。
▌三、最容易混淆的地方:population-averaged和subject-specific不是一句话的两种说法
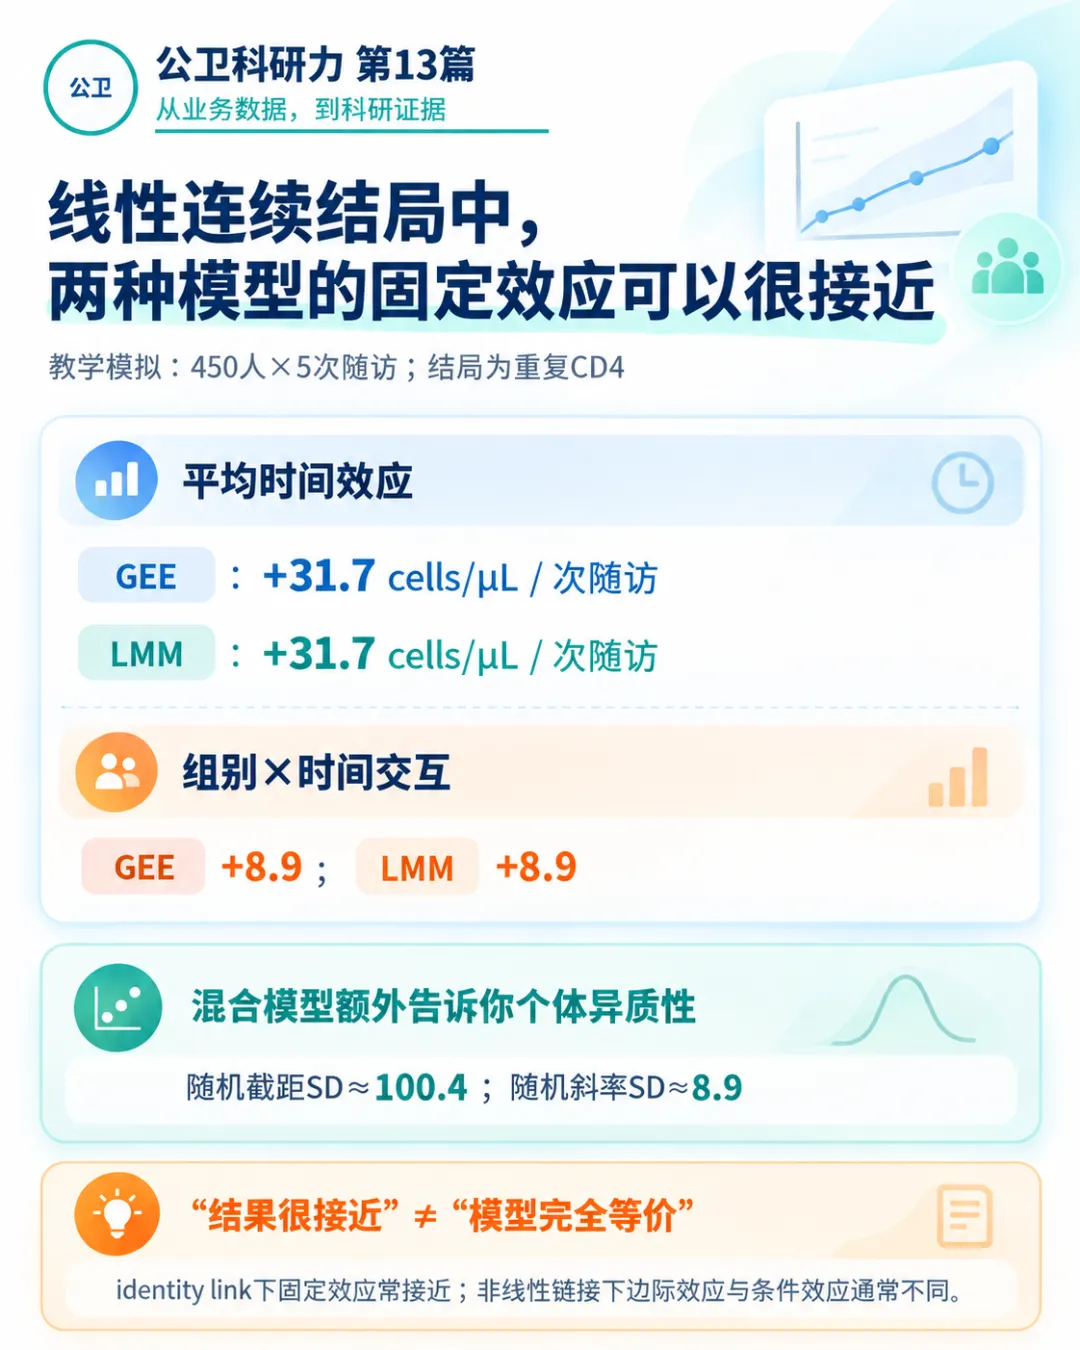
在线性结局使用identity link时,GEE和线性混合模型的固定效应可以非常接近,甚至几乎一样。原因是边际均值与条件均值在这个简单链接下具有特殊关系。因此,如果只拿一个连续结局示例比较回归系数,很容易误以为两种方法“完全等价”。
但到了二分类、计数等非线性结局,差别会明显得多。GEE logistic模型的回归参数是边际的、群体平均层面的log odds变化;带随机效应的logistic混合模型参数则是给定随机效应后的条件效应。两者的OR通常不能直接当成同一个效应量比较,subject-specific OR往往会离1更远。
因此,不要写成“GEE OR=1.8,混合模型OR=2.2,所以后者效应更强”。两者可能回答的是不同层面的科学问题。 |
▌四、一个连续结局模拟:为什么两种结果可以几乎重合
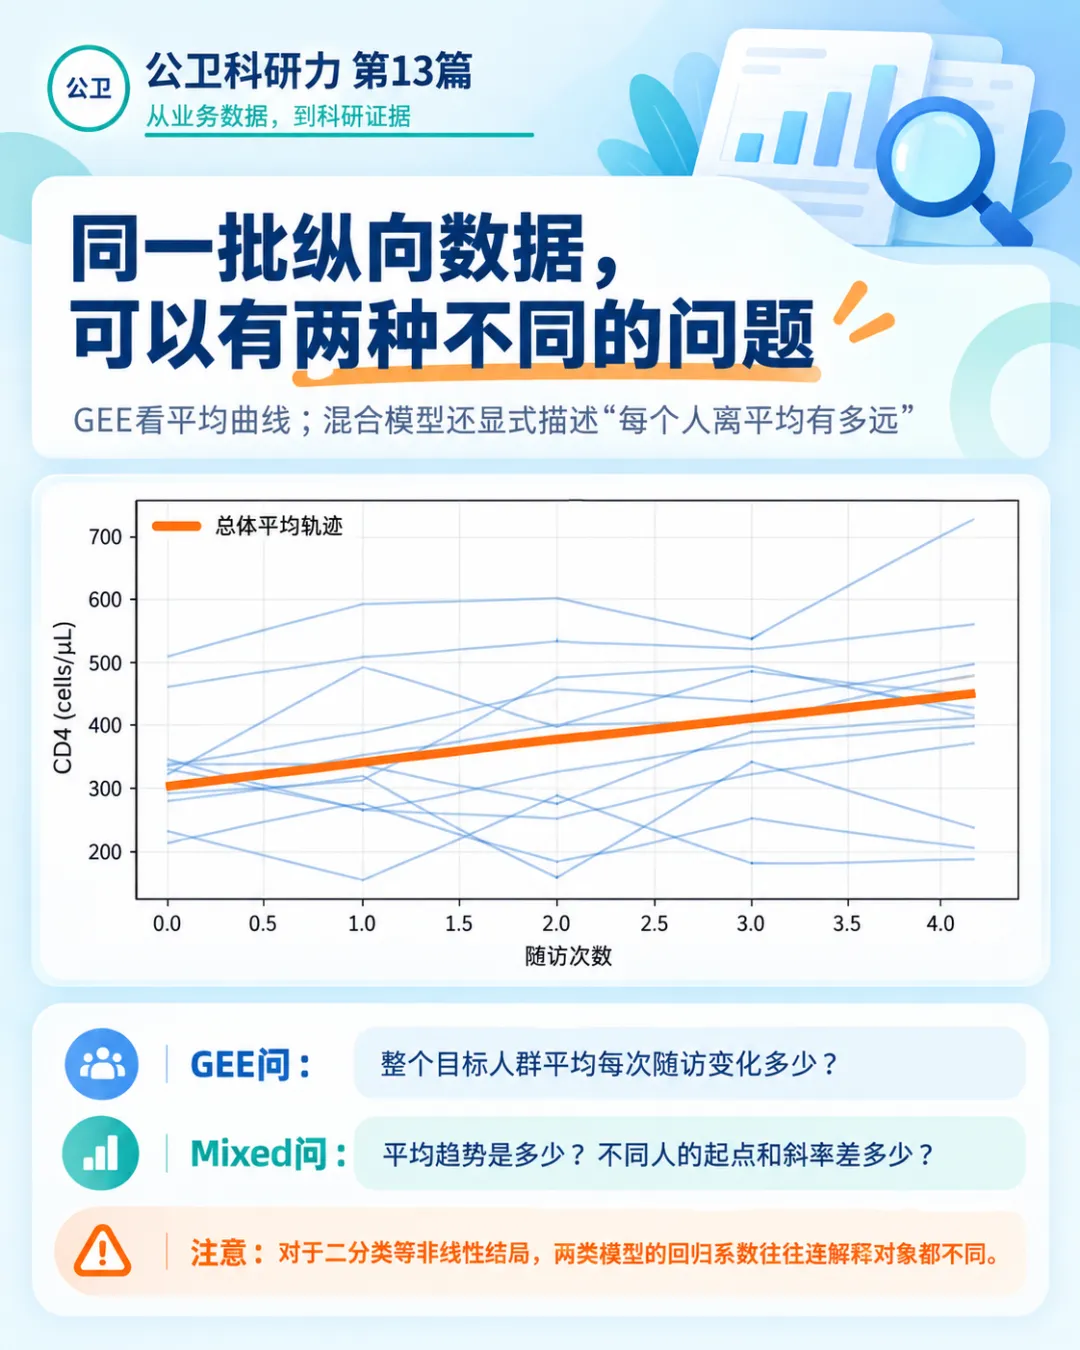
我们模拟450人、每人5次CD4随访。总体上CD4随时间上升,同时不同人具有不同的基础水平和不同的变化速度。模型中还加入组别×时间交互,用于表示两组恢复速度不同。
GEE估计平均时间效应约为每次随访+31.7 cells/μL,组别×时间交互约+8.9;随机截距+随机斜率的线性混合模型给出的固定效应几乎相同。但混合模型进一步估计出随机截距SD约100.4、随机斜率SD约8.9,这部分正是个体异质性信息。
▌五、随机截距和随机斜率不是越多越好
看到纵向数据就机械写“(1+time|id)”同样不严谨。随机效应结构需要研究设计和数据支持。若每个人只有很少观测、时间点分布极不规则,或随机截距与随机斜率模型出现奇异拟合(singular fit)和收敛问题,就要重新检查模型是否过度复杂。
另一方面,只用随机截距也不是永远足够。如果个体变化速度明显不同,而模型强迫所有人共享同一条斜率,固定效应、标准误和相关结构都可能被不恰当地简化。建模前先画spaghetti plot和个体轨迹,通常比直接堆随机项更有价值。
▌六、缺失数据时,两类模型的默认假设也不完全一样
第10篇已经讲过缺失机制。这里需要补上一点:标准GEE在非完整纵向数据下并不会因为“用了稳健标准误”就自动解决缺失偏倚,经典GEE的有效性对缺失机制有额外要求;在MAR场景下往往需要加权GEE等扩展。似然型混合效应模型在模型正确且满足相应MAR假设时,可以利用不平衡的已观测数据。
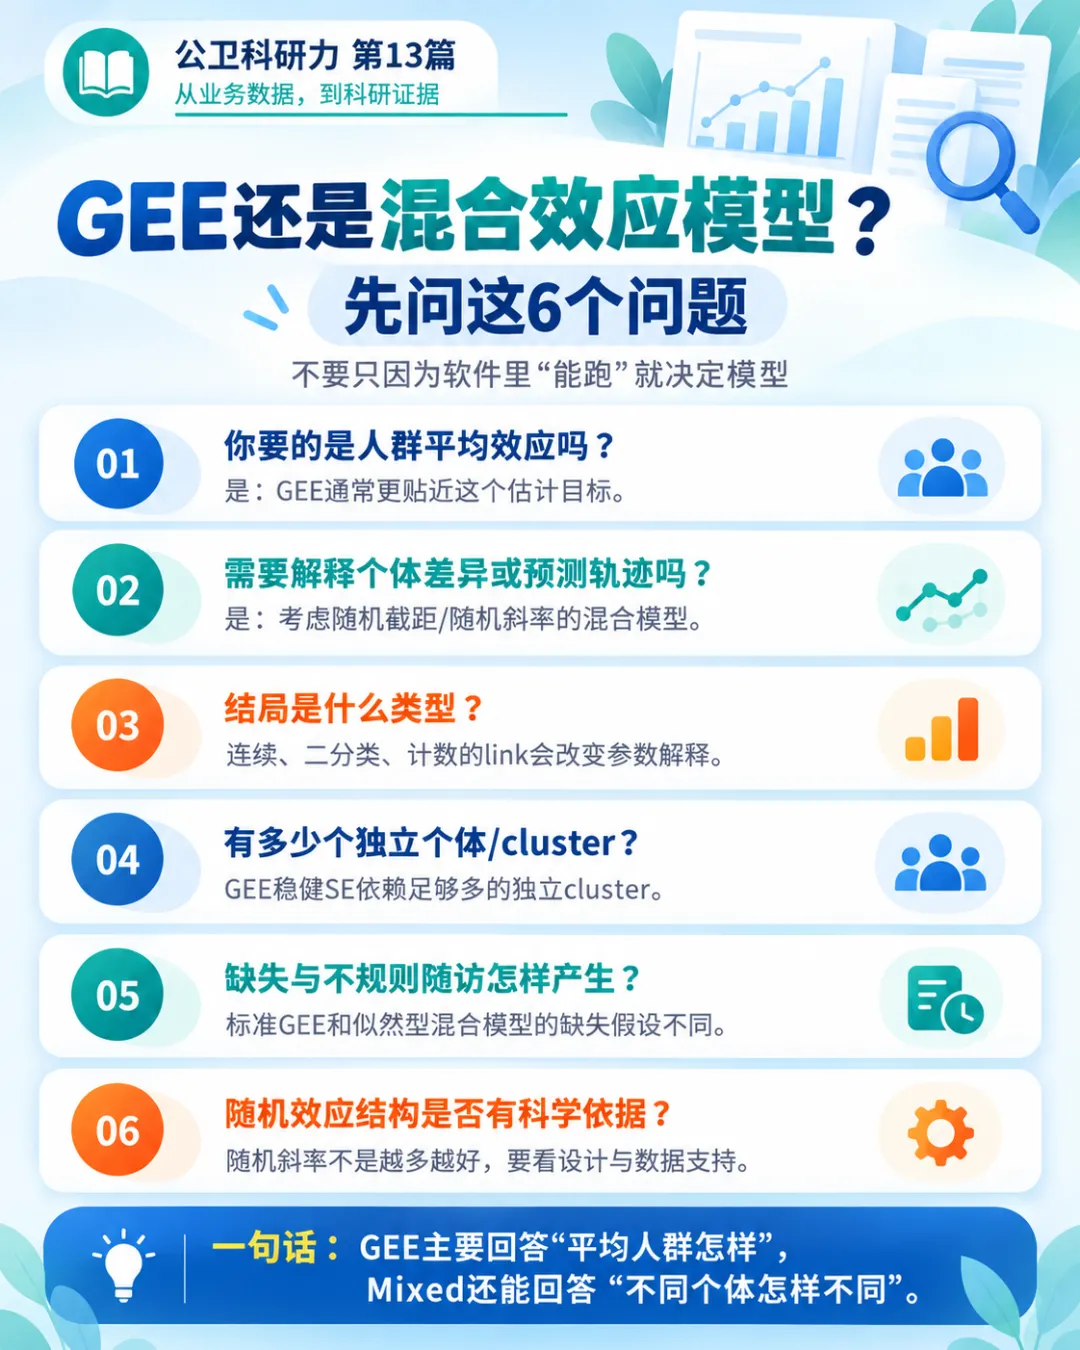
所以“有缺失就选Mixed”“没有缺失就选GEE”同样过度简化。缺失机制、估计目标、模型分布和相关结构应一起考虑。
▌七、实际做疾控纵向研究时,可以这样选
如果你的核心问题是人群平均政策效应、平均暴露关联或平均随访变化,且个体数量充足,GEE通常是很自然的选择。如果你关注个体轨迹、个体间异质性、随机斜率,或需要条件预测,混合效应模型更贴近目标。
无论选哪一种,都应明确cluster id、时间定义、结局分布、link、相关或随机效应结构,并报告模型假设与诊断。模型的名称不能替代研究设计。
▌本篇配套资料
本篇配套的450人×5次随访模拟数据与R代码已整理完成。关注“公卫科研力”并私信回复“第13篇”,即可获取。代码会复现个体轨迹、GEE、随机截距+随机斜率线性混合模型,以及总体趋势与个体条件预测。
▌参考与延伸阅读
1. Liang KY, Zeger SL. Longitudinal data analysis using generalized linear models. Biometrika. 1986;73(1):13-22. doi:10.1093/biomet/73.1.13.
2. Zeger SL, Liang KY. Longitudinal data analysis for discrete and continuous outcomes. Biometrics. 1986;42(1):121-130. PMID:3719049.
3. Laird NM, Ware JH. Random-effects models for longitudinal data. Biometrics. 1982;38(4):963-974. doi:10.2307/2529876.
4. Hu FB, Goldberg J, Hedeker D, Flay BR, Pentz MA. Comparison of population-averaged and subject-specific approaches for analyzing repeated binary outcomes. Am J Epidemiol. 1998;147(7):694-703. doi:10.1093/oxfordjournals.aje.a009511.
5. Schober P, Vetter TR. Repeated Measures Designs and Analysis of Longitudinal Data: If at First You Do Not Succeed—Try, Try Again. Anesth Analg. 2018;127(2):569-575. doi:10.1213/ANE.0000000000003511.
6. Diggle PJ, Heagerty P, Liang KY, Zeger SL. Analysis of Longitudinal Data. 2nd ed. Oxford University Press; 2002.