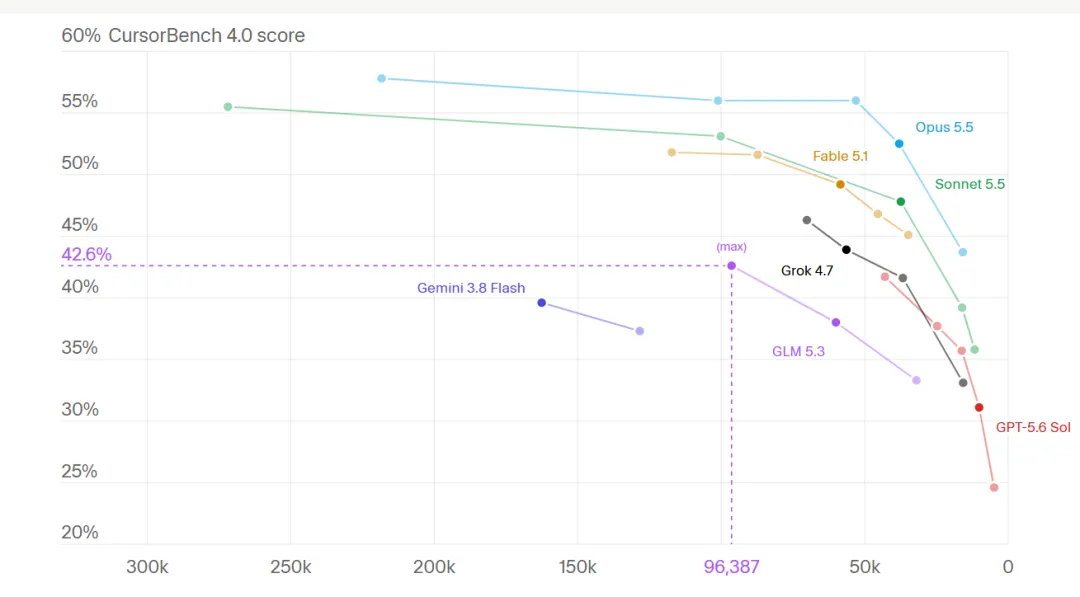
近日,海外AI编程工具Cursor宣布上线智谱两款模型,并且在Cursor自研的编程评测CursorBench4.0中,拿到了开放权重模型的最高分——42.6%(在它之上的所有模型都来自闭源模型)。
开放权重最高分:GLM-5.3 在 CursorBench 4.0 中的位置
图片来源:cursor官网
这不是一次普通的跑分。它来自海外主流开发者工具的真实工作流,考的是程序员日常工作中遇到的真实问题。一个中国模型,在最贴近实战的第三方评测中,进入了全球第一梯队。
而这,正在为一条清晰的商业化路径铺路。
第一部分:这场“考试”到底有多特殊
要理解这件事的分量,得先理解CursorBench的特殊之处。
我们平时看到的大模型评测,大多是学术数据集跑分——模型在标准化题目上答对多少道,就得多分。但这类评测有个致命缺陷,题目是公开的,模型可能在训练时已经“见过”了。就像一个考生提前背了答案,考了高分,但真实工作能力未必强。
CursorBench走了另一条路。
它的题目不是人工出的,而是通过一个叫“CursorBlame”的工具反向提取的:Cursor回溯程序员已经提交的真实代码,反向定位当初生成这段代码的用户提问,自动构建“真实提问→最终代码”的配对样本。
换句话说,考题全是程序员在真实工作中遇到的真实问题,任务描述也刻意保留了日常工作中那种模糊、信息不充分的感觉。不是让你做教材上的练习题,而是把你扔进一个真实的项目组,看你三天内能交付什么。
在这个“考场”上,智谱拿到了42.6%,在所有可下载权重的模型中排名第一。排在它前面的,是Fable、Opus这些闭源旗舰模型。差距还在,但在最贴近真实开发场景的第三方评测中,一个中国模型进入了全球第一梯队。
这种经过实战检验的模型能力,既是商业化落地的基础,也是模型走向海外市场的重要底气。
第二部分:真正值得关注的,不仅有分数,还有商业化路径
CursorBench的分数本身不产生一分钱收入。但它是一个信号——智谱的商业化路径正在变得清晰。
具体来说,有几个关键进展:
第一,云厂商合作落地。据企业管理层披露,公司已与多家国内外头部云服务商签署收入分成协议,相关收入预计自10月开始确认。与此同时,公司将2026年末 ARR 指引由24亿美元上调至30亿美元;高盛也在研报中将其2026年底ARR预测上调至32亿美元,上调逻辑来自Token需求增长,以及新商业合作有望带来高利润率增量收入。管理层上调业绩指引,高盛同步上调预测,二者对增长的判断方向保持一致。
第二,Co‑Work 商业化进展超预期。GLM‑5.3发布后一个月内,Co‑Work 行业签约订单金额突破 10 亿元人民币。CursorBench 评测可以侧面印证模型产品能力;云厂商合作落地、大额行业订单,则是商业化推进的直接体现,有望逐步转化为可量化的收入增长。
上面这些云厂商合作、行业订单,体现的是智谱整体商业化的进展。而模型实战能力得到验证之后,海外市场如何破局,就成了另一个值得观察的问题。
第三部分:出海的两条路
其海外拓展,更多以 B 端基座模式向外输出,市场上可以观察到两类典型落地路径。
第一条路:嵌入开发者工具生态。Cursor 是海外主流 AI 编程工具,开发者可配置 API 接入 GLM‑5.3 系列完成编码工作。社区已有开发者探讨,用 Codex 搭配 GLM‑5.3‑Flash 来提升性价比。开发者工具用户本身有付费习惯,模型切换门槛不高,是大模型出海的重要场景。
第二条路:服务新兴市场企业,作为高性价比补充选项。尼日利亚保险科技平台 Curacel 将 GLM‑5.3 纳入多模型业务体系。在客户分类、智能客服等高吞吐场景下,该模型能够以更低成本取得接近海外模型的业务效果,和原有模型形成搭配使用。

第四部分:三个值得记住的产业判断
判断一:评测体系走向多元,现实业务评测参考价值显著提升。以往行业主要依靠参数量、公开学术数据集来衡量大模型水平。学术公开评测仍是横向基准,但来自下游工具厂商的私有业务评测,已经成为检验实战能力的重要补充。同时它也受限于数据集不公开,仅适合套件内对比。中国大模型出海,应当兼顾公开榜单与海外业务侧私有评测,综合评估模型真实水平。
CursorBench 是 Cursor 在 2026 年 3 月推出的私有评测套件,借助 Cursor Blame 回溯真实提交的代码,反向定位对应的用户提问,构建“真实提问→最终代码”的配对样本。数据集不对外公开。我们讨论的 42.6% 分数,来自 2026 年 9 月更新的 CursorBench 4.0。
判断二:产业评价标准,正在从“看技术故事”转向“看可验证收入”。这次CursorBench高分是催化剂,但底层驱动是ARR指引上调、云厂商新商业协议、Co-Work订单落地。技术跑分只是引爆关注度,真正决定产业位置的,是收入兑现。即便技术评测亮眼,如果收入无法兑现,产业价值仍然会被质疑。反过来,即便评测分数不是第一,只要商业化路径清晰,同样会获得产业认可。
判断三:“开放权重”不等于“开源”,出海要厘清概念。智谱GLM-5.3的权重可以公开下载和部署,普通开发者可以自由使用、修改、分发、微调甚至出售,但大型MaaS服务商需要先提交审查。开放权重≠开源。在海外,许可证、权重、源代码三者的法律定义差异巨大。中国大模型出海,如果概念混用,容易引发知识产权争议。
这次测评结果表面看是一次技术突破。但更深层的变化是中国开放权重模型在编程Agent这个关键赛道,第一次在海外主流开发者工具的真实场景评测中,证明了自己具备与国际第一梯队竞争的能力。
技术分数给了产业信心,但最终决定中国大模型出海高度的,仍是收入兑现和生态落地。编程能力是切口,商业兑现才是下半场。