关注 霍格沃兹软件测试开发 公众号,回复「资料」, 领取人工智能测试开发技术合集
摘要: 做大模型测评时,我们习惯检查回答正确性、相关性、幻觉率,再用 LLM-as-a-Judge 打个分。但进入 Agent 阶段以后,只看最终回答已经越来越不够用了。因为 Agent 不只是“说”,它还会选工具、传参数、连续执行多步操作,甚至真正改变业务状态。最近 NVIDIA 在 Agent Evaluation 中把评测进一步拆到了工具调用、执行过程和最终任务状态。对测试工程师来说,最值得带走的不是某个新框架,而是下面这 4 种可以直接加入测试体系的方法。
前段时间做大模型测评,很多团队的评测集长这样:
用户提一个问题。
模型生成回答。
然后检查:
回答对不对? 有没有幻觉? 和参考答案接不接近? 有没有违反安全规则?
再进一步,可以让另一个大模型充当 Judge,按照相关性、正确性、有用性给它打个 1~5 分。
这一套放到 RAG、客服机器人、知识问答里,基本说得通。
但如果今天测的不是一个聊天机器人,而是一个 Agent,问题就开始变了。
比如用户说:
帮我把刚才买错的那个会员套餐取消掉。
Agent 接下来可能需要:
识别用户 → 查询订单 → 判断订单类型 → 找到对应工具 → 传入订单号 → 执行取消 → 检查结果 → 再告诉用户处理完成。
这时候,如果最后一句:
“已经帮您取消成功。”
说得非常自然,LLM-as-a-Judge 甚至给了 5 分。
这个 Agent 就算测试通过了吗?
不一定。
它可能查询错了订单。
可能工具选对了,参数传错了。
可能本来应该先验证身份,却直接执行了取消。
甚至还有一种更麻烦的情况:
工具调用失败了,但最后仍然告诉用户“已经处理成功”。
到了这里你会发现:
过去的大模型测评主要在判断“它说得对不对”;Agent 测评开始需要判断“它到底做对了没有”。
这也是最近 Agent Evaluation 越来越值得测试工程师关注的原因。
NVIDIA 在 2026 年 9 月发布的一篇 Agent Evaluation 技术文章中,就把重点放到了从 Tool Calls 一直追踪到 Task Completion:不仅评估单次函数调用,还要评估执行轨迹,以及任务结束以后环境的真实状态。
对于测试工程师来说,可以先不用把事情搞得特别复杂。
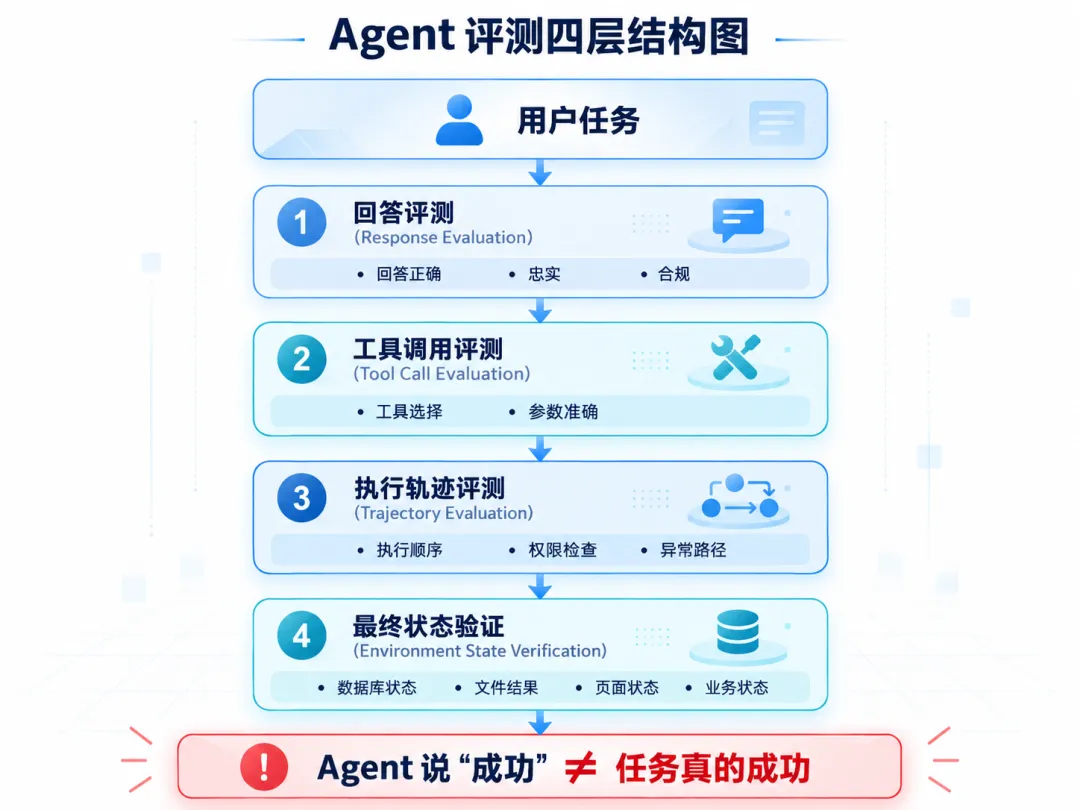
一套 Agent 测评,至少可以从下面 4 层开始。
方法一:先测回答,但别只看“像不像正确答案”
回答质量当然还得测。
只不过到了 Agent 阶段,它只是第一层。
比如客服 Agent 查询完物流后回答:
您的订单已经签收,可以申请7天无理由退货。
这一层仍然可以继续检查:
这类问题最适合继续使用 LLM-as-a-Judge。
NVIDIA 的 NeMo Evaluator 就支持按照自定义评分标准,让另一个模型去判断模型输出,例如正确性、帮助性等维度;而 NeMo Guardrails 的评测体系中,也可以定义 Policy,再检查输出是否符合规则。
例如可以把退款规则写成:
policy = """1. 不得承诺知识库中不存在的退款期限2. 定制商品不得描述为支持无理由退款3. 无法确认订单状态时必须提示进一步查询"""
再让 Judge 判断当前回答是否违反其中任何一条。
这一层解决的核心问题仍然是:
Agent最后说出来的话,是否可信。
但测试到这里不能结束。
因为下一层开始,才真正出现 Agent 和普通 Chatbot 的区别。
方法二:工具调用评测——它到底调对工具了吗?
假设我们有三个工具:
get_order()cancel_order()refund_order()
用户说:
我刚下错单了,帮我取消。
一个 Agent 最后回复:
好的,已经帮您取消。
听起来完全正常。
但 Trace 里面实际发生的是:
refund_order(order_id="A1024")
而不是:
cancel_order(order_id="A1024")
如果测试系统只检查最终回答,这条用例甚至有可能通过。
所以 Agent 测评第二层必须开始检查 Tool Call。
最基础的测试其实并不复杂:
deftest_cancel_order(agent_result):assert agent_result.tool.name == "cancel_order"assert agent_result.tool.arguments["order_id"] == "A1024"
但真正业务里的断言应该比这个更多。
至少包括:
工具选择是否正确
该查询的时候不能直接修改。
该取消的时候不能退款。
参数是否正确
订单号不能错。
用户 ID 不能串。
退款金额不能由模型自己生成。
是否调用了不存在的工具
这在 Agent 系统里同样需要防。
工具是否被重复调用
例如:
refund_order()refund_order()
如果业务接口本身没有做好幂等,问题可能直接变成一次生产事故。
所以第二种方法解决的是:
Agent有没有选对“动作”。
如果过去自动化测试习惯盯接口输入输出,那么到了 Agent 阶段,可以把 Tool Call 看成一种新的“可测接口”。
人工智能技术学习交流群
伙伴们,对AI测试、大模型评测、质量保障感兴趣吗?我们建了一个 「人工智能测试开发交流群」,专门用来探讨相关技术、分享资料、互通有无。无论你是正在实践还是好奇探索,都欢迎扫码加入,一起抱团成长!期待与你交流!👇
方法三:过程评测——每一步都对,顺序也可能错
接下来会出现一个更隐蔽的问题。
假设下面三个调用全部正确:
get_order()verify_user()refund_order()
工具没选错。
参数也没错。
是不是就能通过?
还是不一定。
正确业务流程可能应该是:
verify_user()↓get_order()↓refund_order()
但 Agent 实际执行:
get_order()↓refund_order()↓verify_user()
三个工具都调用正确。
但身份校验发生在退款之后。
这就是 Agent 测试里非常值得关注的一层:
Trajectory Evaluation,也就是执行轨迹评测。
NVIDIA 最近谈 Agent Evaluation 时,把 Step-Level Process Scoring 和最终结果评测明确区分开来:前者关注多步链路到底在哪里出现了错误,后者判断任务最后有没有真正完成。
测试时可以把关键业务约束直接写成断言:
trace = ["verify_user","get_order","refund_order"]assert trace.index("verify_user") < trace.index("refund_order")
甚至进一步定义行为规则:
rules = {"refund_order": {"must_after": ["verify_user","get_order" ] }}
以后 Agent 的 Trace 一旦违反规则,直接判失败。
这一层特别适合测什么?
权限
普通客服 Agent 有没有调用管理员工具?
前置条件
没有查询订单,能不能直接退款?
行为顺序
验证身份必须发生在修改订单之前。
重复操作
同一笔订单有没有连续执行两次退款?
异常路径
订单不存在以后,是停止执行还是继续“猜”一个订单?
这时候测试关注点已经从:
返回结果是什么?
变成:
Agent为什么会得到这个结果?
这也是 Agent 测试和传统大模型测评真正开始拉开差距的地方。
方法四:别相信它说“成功”,直接验证最终状态
最后这一层,我认为是 Agent 测评里最值得测试工程师关注的。
我们继续看刚才的案例。
用户要求:
帮我取消订单 A1024。
Agent Trace 看起来也完全正常:
verify_user()↓get_order("A1024")↓cancel_order("A1024")
最后回答:
订单已经取消成功。
如果前三层都通过,是不是可以结束了?
最好再做一步。
直接查系统:
order = db.get_order("A1024")assert order.status == "cancelled"
这就是:
Environment State Verification。
不要让模型告诉测试系统:
“我完成了。”
而是让真实环境证明:
它确实完成了。
NVIDIA 最近的 Agent Evaluation 方法里特别强调了这一点:对于可以在可执行环境里验证的任务,检查最终环境状态通常比只拿参考答案比较、或者完全依赖 LLM-as-a-Judge 更可靠。
这件事其实特别符合测试工程师的直觉。
比如一个文件操作 Agent。
任务:
创建 report.csv,并写入今天的销售数据。
不要评估:
AI有没有回答“文件已经生成”。
直接测:
assert os.path.exists("report.csv")
再测:
df = pd.read_csv("report.csv")assert len(df) > 0assert"sales"in df.columns
再比如数据库 Agent:
把用户 A 的联系方式改成新号码。
不要只看工具返回:
{"success": true}
最后再查一次数据库。
甚至浏览器 Agent 也一样。
用户任务:
把商品加入购物车。
最终验证不要只是:
Agent: 商品已成功加入购物车
而是检查:
assert cart.item_count == 1assert cart.items[0].sku == target_sku
你会发现:
这种评测方式已经越来越像测试工程师熟悉的自动化测试了。
这也是为什么 Agent 测试可能会成为测试开发一个很有意思的新方向。
把4种方法串起来,其实就是一套Agent测试链路
用户任务 ↓ ① Response Evaluation 回答正确 / 忠实 / 合规 ↓ ② Tool Call Evaluation 工具选择 / 参数准确 ↓ ③ Trajectory Evaluation 执行顺序 / 权限 / 异常路径 ↓ ④ Environment State Verification 数据库 / 文件 / 页面 / 业务状态
如果把前面四种方法放在一起,就会得到这样一条链路:
可以把它简单理解成四句话:
它说对了吗?
它做对了吗?
它做事的过程对吗?
事情最后真的做成了吗?
这四个问题,基本就是 Agent Evaluation 和传统“大模型回答评分”之间最大的区别。
真正上线时,还应该多做一步:把它变成回归门禁
如果只是本地运行几个 Case,这套东西价值还没有完全发挥出来。
真正测试开发要做的,是把它接进回归。
例如准备 200 个 Agent 场景:
正常退款重复退款订单不存在跨用户订单用户身份校验失败工具超时接口返回500参数缺失模型拒绝调用工具调用错误工具……
然后每次修改:
都重新跑一遍。
最终 CI 里看的也不应该只有一个“准确率”。
而可以变成:
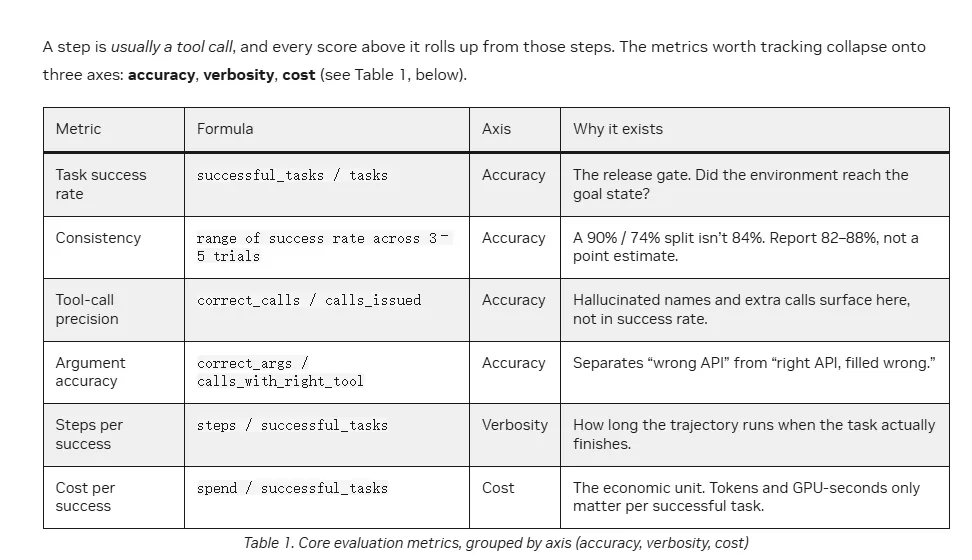
Response Pass Rate 96.2%Tool Call Accuracy 98.5%Trajectory Pass Rate 94.7%Task Success Rate 92.3%Policy Compliance 99.1%
例如设置:
assert task_success_rate >= 0.95assert tool_accuracy >= 0.98assert policy_compliance >= 0.99
任何一项跌破阈值:
BLOCK RELEASE
这才开始真正变成一套可持续运行的 Agent 测试体系。
NVIDIA 的 Guardrails Evaluation 目前也已经不仅关注合规率,还会统计 LLM 调用次数、Token 消耗、调用动作以及整体延迟,因为安全和成功率提高以后,最终还需要看付出了多少资源和延迟成本。
所以更成熟以后,还可以继续加:
成功率稳定性P95延迟Token成本工具调用次数
Agent 测评最后不会只有一个分数。
而更像今天我们熟悉的质量看板。
最后
以前做大模型测评,我们最容易问:
这个回答有几分?
到了 Agent 阶段,这个问题已经明显不够了。
因为 Agent 最大的变化,不是回答变长了。
而是它开始真正执行动作。
一旦 AI 能查数据库、调用接口、修改订单、操作浏览器、执行代码,测试对象自然也会从:
输出内容
慢慢扩展到:
工具 → 行为 → 状态。
所以现在如果让我给 Agent Evaluation 做一个最简单的测试模型,我会先从这四层开始:
回答评测。
工具调用评测。
执行轨迹评测。
最终状态验证。
其中前三层解决的是:
Agent执行得像不像正确流程。
最后一层解决的是:
它究竟有没有真的把事情做成。
这可能也是 Agent 测评接下来最值得测试工程师关注的变化。
毕竟在生产环境里,我们最终需要证明的,从来不是:
“AI觉得自己成功了。”
而是:
“系统里的事情,真的被它做对了。”
智能化测试-测试用例生成公益训练营,从行业大模型特性讲起,带你搞懂AI测试的全链路:大模型能力评测、智能体Harness工程、Skill技能体系、CLI与MCP工具体系、RAG知识图谱——最后直接上手打造一个能自动生成测试用例的智能体。
关于我们
霍格沃兹测试开发学社,隶属于 测吧(北京)科技有限公司,是一个面向软件测试爱好者的技术交流社区。
学社围绕现代软件测试工程体系展开,内容涵盖软件测试入门、自动化测试、性能测试、接口测试、测试开发、全栈测试,以及人工智能测试与 AI 在测试工程中的应用实践。
我们关注测试工程能力的系统化建设,包括 Python 自动化测试、Java 自动化测试、Web 与 App 自动化、持续集成与质量体系建设,同时探索 AI 驱动的测试设计、用例生成、自动化执行与质量分析方法,沉淀可复用、可落地的测试开发工程经验。
在技术社区与工程实践之外,学社还参与测试工程人才培养体系建设,面向高校提供测试实训平台与实践支持,组织开展 “火焰杯” 软件测试相关技术赛事,并探索以能力为导向的人才培养模式,包括高校学员先学习、就业后付款的实践路径。
同时,学社结合真实行业需求,为在职测试工程师与高潜学员提供名企大厂 1v1 私教服务,用于个性化能力提升与工程实践指导。