客服工单系统里,agent 一口气走完九次工具调用,格式全对、没有报错,最后汇报「工单已解决」。事后查库才发现,流程要求把这张工单留在 hold 状态,它写成了 solved。口头完成和真实完成之间隔着多远?微软和 Hugging Face 联合开源的 ThinkingBox 基准给了一个可以引用的数字:在它统计的失败里,三分之二的轨迹看上去毫无破绽。
判卷的是数据库,不是对话
ThinkingBox 收录 507 个有状态业务工作流,覆盖零售、车险、旅行、数字银行、咨询五个域,每个任务让模型独立跑 20 次。评分不读模型的自述,而是对数据库终态和副作用做可执行检查——工单状态、订单字段、账户变动,写对才算对。报告同时给三个口径:pass@1 回答「通常表现怎样」,pass@20 回答「有没有能力做到」,20 次全对回答「是不是每次都做到」。
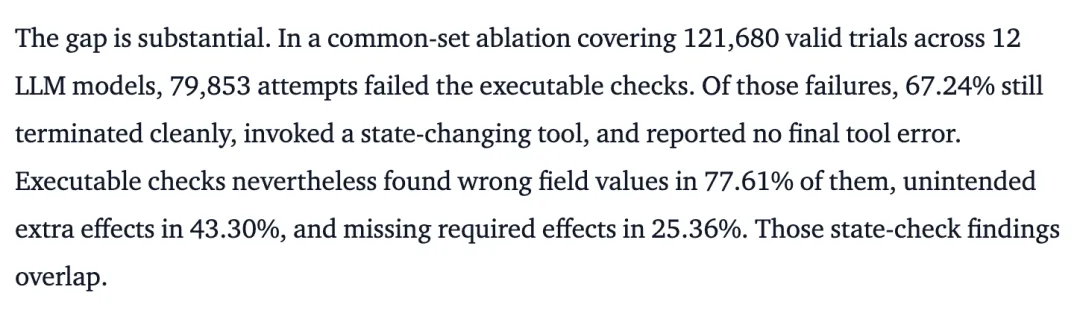
▲ ThinkingBox 官方博客(2026-10-06 读取):121,680 次有效尝试中 79,853 次未过可执行检查;失败里 67.24% 轨迹干净无报错,77.61% 错在字段值,43.30% 带多余副作用,25.36% 漏掉必需动作。
三分之二的失败,看着都像成功
这批尝试覆盖 12 个模型。其中 67.24% 的失败轨迹干净终止、调用了状态变更工具、也没有任何报错——如果拿「跑完没报错」当完成标准,这些全部会被计成成功。拆开失败原因,字段值写错占 77.61%,是最普遍的形态;多余副作用占四成多,漏掉必需动作约占四分之一。开头那个把 hold 写成 solved 的工单就是基准里的真实样本,九次调用格式全对,错在一个字段值。官方把约八成失败归因于工具使用与错误恢复,而不是知识不会。
单次分数会骗人
总榜第一名 Claude Opus 5.5 的 pass@1 约六成七,20 次全对的任务却不到一半,和上一代 Opus 5 完全持平——标题分涨了,可靠性没涨。开源阵营最强的 Kimi-K3 更分裂:二十次里至少做对一次的任务接近全部,能每次都做对的只剩一成三;它在零售域还超过了所有闭源模型。会做和每次都做,是两种要分开计价的能力。
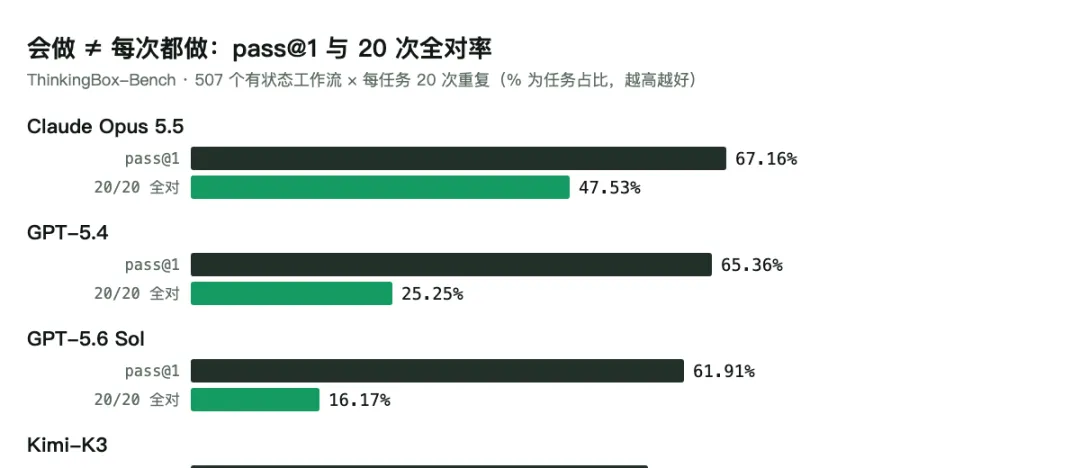
▲ 数据转录自 ThinkingBox 博客总表(2026-10-06 读取):pass@1 与 20 次全对率,Opus 5.5 为 67.16%/47.53%,GPT-5.4 65.36%/25.25%,GPT-5.6 Sol 61.91%/16.17%,Kimi-K3 57.37%/13.41%。
和既有评测比
SWE-bench Verified 拿代码 diff 判卷,判定很硬,但只覆盖写代码这一件事;tau-bench 一类有状态客服评测思路相近,任务规模小得多;LLM-as-judge 便宜灵活,可它评的是模型的「说法」,遇到开头那种状态写错,评不出任何问题。ThinkingBox 站在中间:判定权交给数据库,再用 20 次重复把「做到了」和「每次都做到」拆成两列。生产环境真正付钱的,恰恰是这两列之间的差值。
今天做什么
做有状态 agent 的团队,可以把验收标准从「最后一句话说了什么」换成「落库终态加副作用断言」:任务结束先查库,字段、状态、变更记录都对一遍。评测侧,同一任务多跑几次看方差,别只看均值;选模型时把「每次都对」单独算一列再报价。基准与运行环境都已开源,拿自己业务的数据库快照搭一套同样的判卷逻辑,比换更大的模型更能压住这类事故。
参考:ThinkingBox 官方博客(huggingface.co/blog/microsoft/thinkingbox,2026-10-06 读取);论文 arXiv:2608.19741;仓库 github.com/microsoft/thinkingbox
