上一期讲了三种协作模式,其中竞争模式很多人感兴趣——几个Agent跑同一个任务,选最好的那个。
听起来很美,但真做起来你会发现一个问题:怎么选?
三个Agent各写了一段代码,你说哪个最好?两个Agent各写了一份方案,你说哪个更靠谱?如果选不出来,竞争模式就白做了。
竞争模式的核心难点不是"跑几个",而是"怎么选"。
一、什么时候值得用竞争模式?
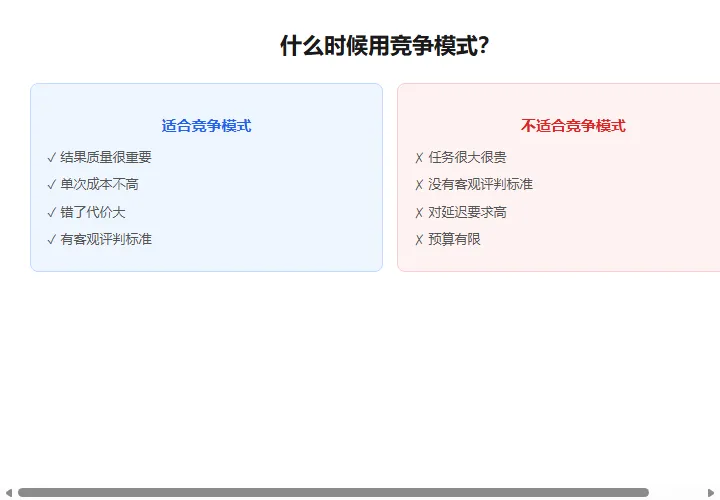
先别急着上竞争模式。不是所有任务都值得跑多个候选。
值得跑:结果质量很重要、单次调用成本不高、错了代价很大、有客观或半客观的评判标准。比如写一段代码(能跑测试)、写一段文案(有人看点击率)、做一个方案(有明确的评估维度)。
不值得跑:任务很大很贵(跑一次就要几毛钱token,跑三次就一块多)、没有评判标准(纯主观审美)、对延迟要求很高(用户等不起三个Agent的时间)、预算有限。
二、三种评判方式
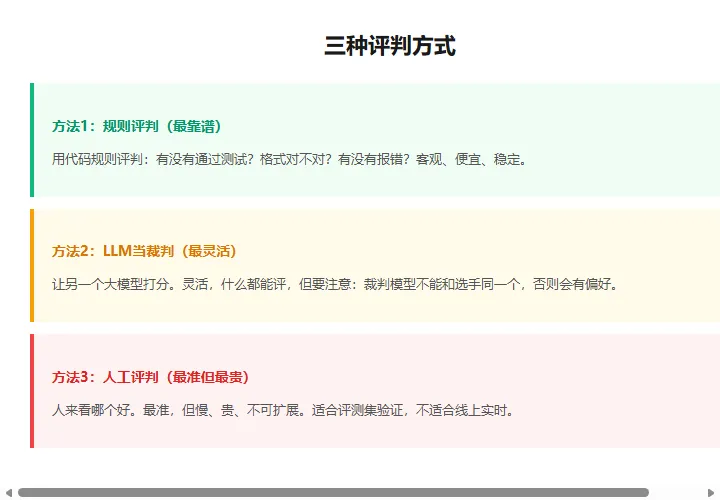
选最好的那个,本质是一个评判问题。有三种方式,从靠谱到不靠谱排列:
方式1:规则评判(最靠谱)
用代码规则来评判。比如:代码能不能通过单元测试?格式对不对?有没有报错?输出符不符合JSON Schema?
这种方式最靠谱——客观、便宜、稳定。因为它不依赖模型,是确定性的判断。
如果你的任务能用规则评判,一定要用规则。比如代码生成任务,直接跑测试用例,通过的得分高,不通过的得分低。这比任何LLM裁判都准。
方式2:LLM当裁判(最灵活)
很多任务没法用规则评判——比如文案好不好、方案合不合理、代码注释清不清楚。这时候就得让另一个大模型来打分。
LLM当裁判的好处是灵活——什么任务都能评。坏处是:它本身就不靠谱,有很多坑。
方式3:人工评判(最准但最贵)
人来看哪个好。这当然最准,但慢、贵、不可扩展。适合什么场景?适合做评测集——你人工标注一批标准答案,用来评估你的系统好不好。不适合线上实时评判。
三、LLM当裁判的三个坑
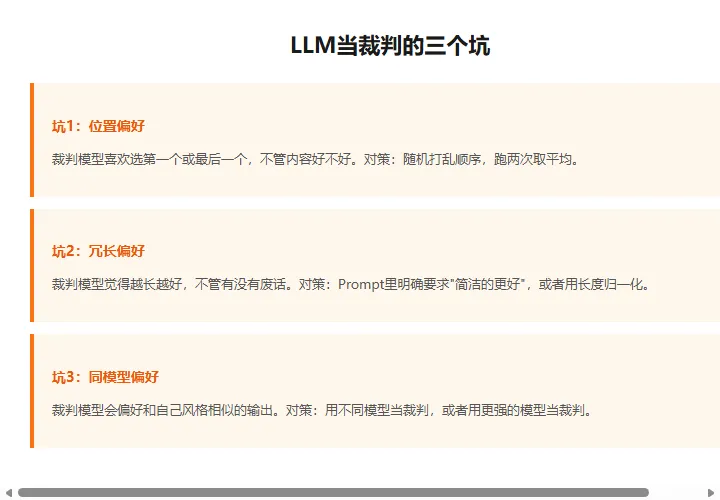
坑1:位置偏好
研究发现,大模型当裁判的时候,会有明显的位置偏好——它倾向于选第一个或者最后一个选项,不管内容到底好不好。
怎么解决?两个办法:第一,把候选的顺序随机打乱,跑两次,取两次的平均结果;第二,不要让裁判模型看到顺序,而是用编号A/B/C来代替。
坑2:冗长偏好
裁判模型会觉得越长越好。同样质量的两段输出,它会给长的那段打更高的分,哪怕长的那段全是废话。
怎么解决?在评判Prompt里明确写:"简洁精炼的输出更好,不要因为长就给高分"。或者用长度做归一化——得分除以字数。
坑3:同模型偏好
如果选手Agent和裁判Agent用的是同一个模型,裁判会偏好和自己风格相似的输出。比如你用GPT-4写代码,又用GPT-4当裁判,它会觉得和自己写法一样的代码更好。
怎么解决?用不同的模型当裁判。选手用GPT-4,裁判就用Claude或者Gemini。或者用更强的模型当裁判,让它跳出自己的偏好。
四、成本权衡:跑几个最合适?
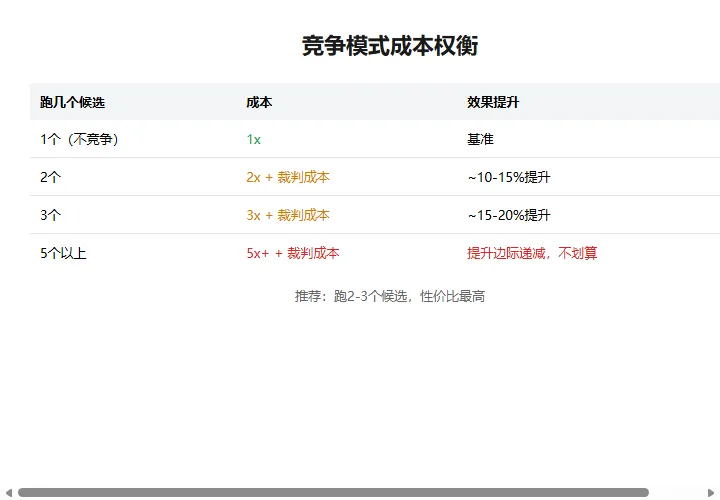
很多人一听竞争模式,就想跑5个、10个候选。没必要。
实测下来,跑1个到跑2个,效果提升最大,大概10-15%。跑2个到跑3个,提升开始递减,大概再涨5%。跑3个以上,边际收益就很小了,但成本是线性上涨的。
所以推荐:跑2-3个候选,性价比最高。再多加,钱花得多,效果提升微乎其微。
还有一个技巧:选手可以用便宜模型,裁判用贵模型。比如选手用GPT-4o-mini跑三个候选,裁判用GPT-4o来选。这样总成本可控,效果也有保障。
结尾
总结一下竞争模式进阶的关键点:
什么时候用:质量要求高、单次成本低、有评判标准。
怎么选:优先规则评判,其次LLM裁判,最后人工评判。
LLM裁判的坑:位置偏好、冗长偏好、同模型偏好,都有对应的解决办法。
跑几个:2-3个最合适,再多不划算。
下一期我们聊流水线模式——串行太慢,并行太乱,中间加个缓冲层怎么设计?