论文题目(英文):Benchmarking biomedical foundation models
作者:第一作者 Julio Saez-Rodriguez;通讯作者 Gustavo Stolovitzky
期刊名称:Nature Methods
DOI:10.1038/s41592-026-03182-y
发表时间:在线发表 2026年9月4日;卷期日期 Nature Methods 23(2026年9月),1724–1733
一句话贡献
本文把生物医学基础模型(foundation model,FM)的评测从“在几个下游任务上得分更高”提升为一个科学方法问题:需要独立、受控、跨分布、可复现的基准,覆盖任务、数据、指标、微调、透明度和临床风险,并由跨领域社区共同维护“活的”评测生态。
1 为什么 FM 的评测比普通算法更难
FM 通常在广泛、异质的数据上以自监督或无监督方式预训练,再通过微调、提示或少样本学习适配多个任务。其参数规模、训练数据和计算量很大,模型还可能出现训练目标没有明确要求的涌现能力。与一个只解决单一分类问题的算法相比,FM 更像一层会被许多应用重复调用的 AI 基础设施,因此它的偏差、数据泄漏和不可重复性会被整个生态放大。
传统生物医学任务可以把训练集、验证集和测试集分开,用实验或临床结果验证预测。高通量组学带来数据洪流后,数据重复使用、分布漂移和模型选择会造成低重复性。CASP 将蛋白结构预测变成独立的社区实验,DREAM 把系统生物学问题变成竞赛,ImageNet、OpenProblems、Polaris 和 OpenADMET 则将这种模式扩展到图像、单细胞和药物研发。关键不是排行榜本身,而是开发者不能自己选择数据和评价自己。
2 引言逻辑:从“模型能做什么”转向“我们能知道它学到了什么”
2.1 先定义 FM,再指出定义本身不稳
作者追溯“foundation model”一词由 Stanford CRFM 在2021年提出,强调 foundation 而非 foundational:它是建立在数据和计算上的不完美工程基础,不是像物理定律一样的基本理论。表1归纳五类典型特征:预训练、广泛数据、可迁移性、规模与计算,以及涌现能力;再加上被大量应用复用形成的“同质化基础设施”。
2.2 传统基准为何仍然重要
竞赛的基本流程是:定义任务,提供整理好的训练数据,让参与者在隐藏的验证/测试数据上提交预测,再用预先规定的指标评分。数据和评分一旦公开,还可以形成持续排行榜。隐藏测试避免自评陷阱,要求提交代码支持复现和集成学习;CASP14 证明这类独立证据能确认 AlphaFold2 在许多单蛋白结构上接近实验精度。
2.3 但有限任务不能代表 FM 的“整片疆域”
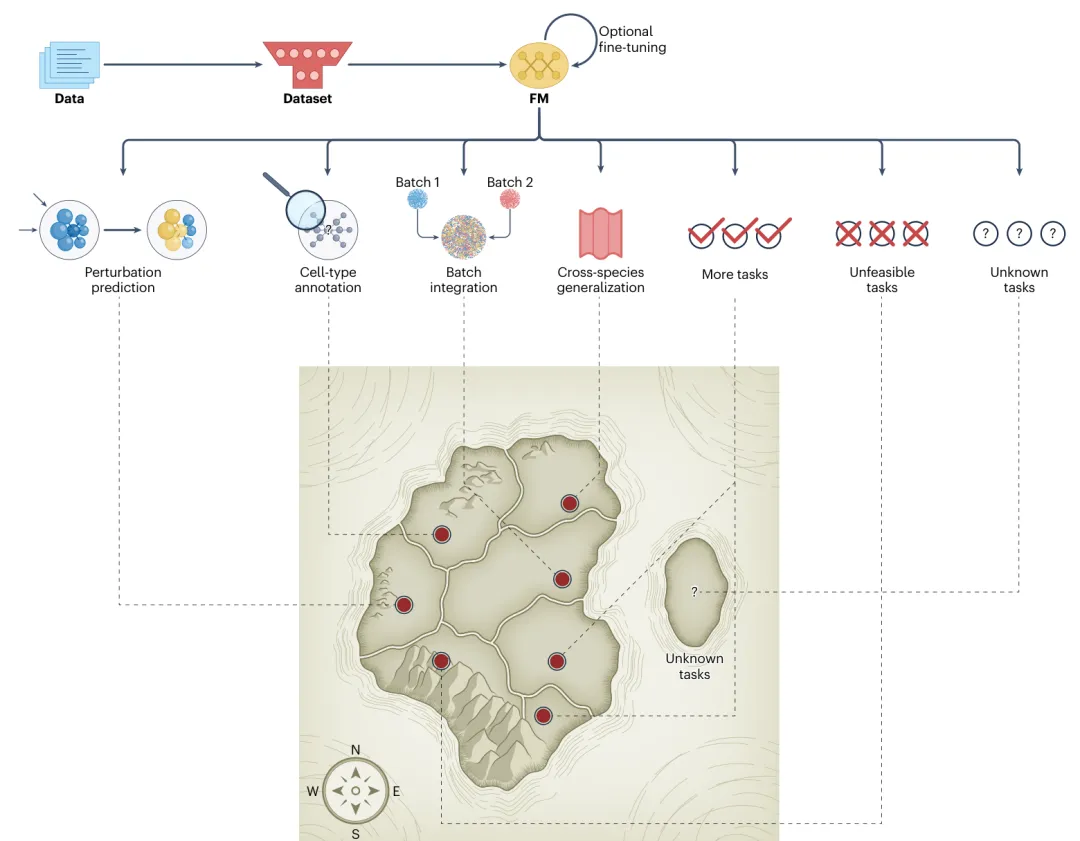
FM 的表示空间远大于任何一组标注任务。某个模型在细胞类型注释上高分,可能只是其归纳偏置恰好适合该任务,而非掌握了可迁移的生物机制。将模型只在几个任务上评估,类似用一座山谷推断整张地图。作者因此把问题提升为认识论问题:FM 是理解生物规律的模型,还是训练数据统计模式的压缩和重组?
3 图1:标准任务评测的边界
图1把数据、FM 和若干已知任务画成岛屿。细胞类型注释、批次整合、跨物种泛化和扰动预测各自只覆盖表示空间的一小块;把所有可能任务都列出来在计算和理解上不可行,模型甚至可能拥有研究者尚未想到的“未知任务”能力。图下方“复杂度像 Borges 的地图”这一比喻,强调穷尽式基准不是可行方案。
图1 Figure 1:用标准任务评测基础模型的局限
图1 的直接启示是,评测必须做任务组合和权重设计。不能用一个平均分掩盖任务间的 Pareto 前沿,也不能把高分当作普遍能力的证明。
4 以单细胞基础模型为例:六个评测维度
4.1 训练和测试数据:异质性与真正的留出
单细胞 FM 应在不同技术(液滴、板式)、物种、器官、疾病和扰动条件上测试,因为样品处理会改变细胞组成,单细胞转录组又只是细胞状态的部分且有噪声。理想的分子机制真值(例如转录因子结合后激活某基因)目前无法系统取得,因此扰动数据尤其宝贵:它检验模型是否编码了基因调控逻辑,并能否在分布外预测细胞响应。
公共基准并不能完全阻止模型隐式调参。要估计真实泛化,需要在开发期间锁定的分布迁移数据上评测,必要时采用受控访问的“活基准”,防止测试集被反复训练。
4.2 微调、表示与计算预算
学习率、冻结层和训练轮数会显著改变结果。模型作者应给出超参数范围、训练策略和评测协议,基准还应报告资源和训练时间。无限制调参既昂贵又偏爱需要大量搜索的模型,因此应同时提供固定微调预算下的比较。零样本表示可以揭示预训练结构;探针模型可以测试表示中可恢复的信息;但探针太弱会低估表示,太强又会掩盖表示缺陷。
一个重要反例是:用 scGPT 的冻结嵌入训练随机森林,在扰动预测上可能超过直接微调 scGPT。故评测不能默认“端到端微调一定最好”,而应并列零样本、参数高效微调、全量微调和经典模型基线。
4.3 任务多样性与指标
单细胞 FM 已被用于批次校正、细胞类型注释、数据整合、插补、多组学对齐和扰动响应预测。任务越多,越能接近通用性,但不同任务的指标不能随意平均。扰动预测尚无公认的生物学合理指标;轮廓系数等嵌入指标在几何假设不满足时会虚高;某些整合指标甚至可以被“作弊”。这是 Goodhart 定律在生物医学评测中的表现:指标一旦成为目标,就可能不再代表真正现象。
严谨基准应同时提供简单基线、任务专用模型、零模型和反映不可约技术/生物变异的上限。还应做消融,确认哪些数据子集和模型模块贡献了结果,并报告任务间 Pareto 前沿,而不是只给一个综合排名。
4.4 多领域、多模态和智能体
AlphaFold3、CAPTAIN、Nicheformer、Cell2Sentence-Scale 和 BioMedGPT 等模型把结构、RNA、表面蛋白、空间转录组、文本和病理图像放进同一系统。输入模态越多,数据制作、标注和专家评判越复杂。对嵌入 LLM 的智能体,早期小错误会沿多步工作流放大,输出还会因轨迹而非确定地变化。基准可以给中间步骤部分得分,但 LLM 评审者会引入偏见和循环性;同时要评估工具、记忆、提示、是否有人在回路中,以及可信、协作和目标一致性。
4.5 透明度与可重复性
必须报告架构、预训练数据、目标函数、软件环境、失败点、消融、分布外测试和微调策略,否则无法知道测试集是否和训练语料重叠,也无法判断高分来自泛化还是公开基准过拟合。临床数据可能不能公开,完全重复不一定可行,但仍可通过受控访问让独立研究者探测模型行为,并完整记录数据来源和版本。选择性报告强结果、隐藏失败运行,会系统性高估能力。
5 其他领域的特殊风险
电子病历 FM 的早期基准包括 EHRSHOT,FoMoH 增加了大队列和亚组分析,EHR-Bench 和 MIMIC 进一步评测结构化、文本和多模态推理;但单机构、时间漂移和工作流整合仍未充分覆盖。数字病理容易出现机构分布偏差和“Clever Hans”捷径。药物发现只在巨大化学空间的一个小子集评测,外推能力因此存疑。临床部署还必须报告校准,而不是只报告 AUROC/AUPRC;一个区分度高但校准差的模型仍可能误导患者。
6 表3:把常见评测缺口改写成可执行要求
7 规模、隐私和基础设施约束
高维生成任务的提交文件可能每天达到数百 GB;Cell2Sentence Gemma-2 有270亿参数,智能体还增加推理计算和测试时预算。基准平台需要可扩展的指标计算、存储和访问控制。基因组数据的隐私风险高于转录组和单细胞数据,合成组学数据可以近似真实统计结构,用于隐私保护评测,但不能默认合成数据保留所有生物机制。
临床 FM 应在未见队列、遗传多样人群和时间漂移下评估校准、稳健性与公平,而不是只在内部测试集上追求区分度。模型大小和算力也应成为报告字段,因为一个只在超级计算集群上可运行的模型与一个普通医院能部署的模型,实际价值不同。
8 社区治理:从许多竞赛走向 BEACON
作者认为当前基准工作已经很多,却彼此不协调。OpenProblems 和 Chan Zuckerberg Initiative 的 living benchmark 展示了持续更新的可能性;新成立的 BEACON(Benchmarking, Evaluation and assessment CONsortium)以 CASP、DREAM、CACHE、OpenADMET、Sage Bionetworks 和 Structural Genomics Consortium 等为创始成员,目标是共享举办挑战的基础设施、汇总跨领域经验,并围绕缺少真值、文献事实冲突、虚拟细胞和单患者“n-of-1”科学开发方法。
这种联盟不应取消各领域的独立性,而是提供共同的任务词汇、数据治理、评分校准和模型仓库。社区需要一起回答:哪些任务足以代表用户真正关心的能力,任务权重如何确定,哪些测试数据必须在开发时不可见,模型结果怎样与实验验证连接。
9 认识论问题:模型是在理解现实,还是在复制影子
物理理论以少量稳定方程压缩大量现象,预测失败会促使理论被修正;FM 则以数十亿参数压缩数据分布,参数本身通常没有直接解释。换一批训练样本,参数可以变化而预测精度不变。因此 FM 的差异更像统计预测模型的误差分布,而不是物理定律的真伪二元判定。
这不意味着只要有用就无需理解。作者的立场是同时“计算”和追问模型能从生物学中学习多少:一方面在实用任务上严谨测量性能,另一方面建立任务地图、独立实验和分布外测试,判断模型是否超越训练数据的表面相关。最终评测的对象不是一个排行榜数字,而是模型在数据变化、任务变化和真实工作流中的行为边界。
10 最强证据、适用场景与局限
本文的核心证据来自多个具体尺度:FM 的参数可达数十亿至数万亿;Cell2Sentence Gemma-2 达270亿参数;大规模虚拟细胞挑战的预测提交可每天产生数百 GB;传统社区已有超过800个挑战、覆盖25个以上平台;EHR 基准从 EHRSHOT、FoMoH 到 EHR-Bench 逐步加入少样本、临床现实和推理。这些数字说明,评测已从“小数据集上比较几个模型”变成需要联盟基础设施的系统工程。
适用场景包括单细胞基础模型选型、病理和电子病历模型外部验证、DNA/蛋白语言模型的分布外评估、药物模型的化学空间外推,以及带工具调用的生物医学智能体审查。局限在于,本文是方法论观点而非统一实验证据;“任务地图”尚未建立,很多任务没有可靠真值或统一指标;受控数据和大规模算力会限制小型团队参与;跨领域权重和指标仍需社区协商。
11 总结:高分只是起点
可靠的生物医学 FM 基准至少要同时回答六个问题:模型是否在真正独立的分布变化上泛化,零样本和微调分别贡献多少,指标是否具有生物学意义,训练数据和失败运行是否透明,计算与隐私成本是否可接受,结果是否能在临床或实验工作流中保持校准和安全。实现这些要求需要隐藏且持续更新的测试数据、统一元数据、强基线、消融和跨领域社区。只有这样,基础模型才可能从“在排行榜上表现好”升级为“在科学上值得信任、在现实中能够部署”。