最近只要讨论 Agent选型很快就会变成一场名词混战:“我们用 Claude Code 还是 LangGraph?”“Pi 很轻,能不能替掉框架?”“既然接了 E2B,是不是就不用自己做 Agent 了?” 这些问题很难回答,因为问题本身把不同层的东西放在了一起。
Claude Code 首先是一个可直接使用的产品,LangGraph 是运行和编排 Agent 的框架,Pi 是可嵌入的循环内核,E2B 是隔离代码执行的沙箱。拿它们做一张“谁更强”的横评表,就像拿浏览器、React、Linux 进程和 GPU 做横评:每一个都重要,但它们解决的不是同一个问题。
真正有用的问法不是“哪个 Agent 框架最好”,而是三句话:
把这三句话想明白,今天看似拥挤的 Agent 生态会有一张清楚的六层地图。
一、先聊聊Agent 到底是怎么跑起来的
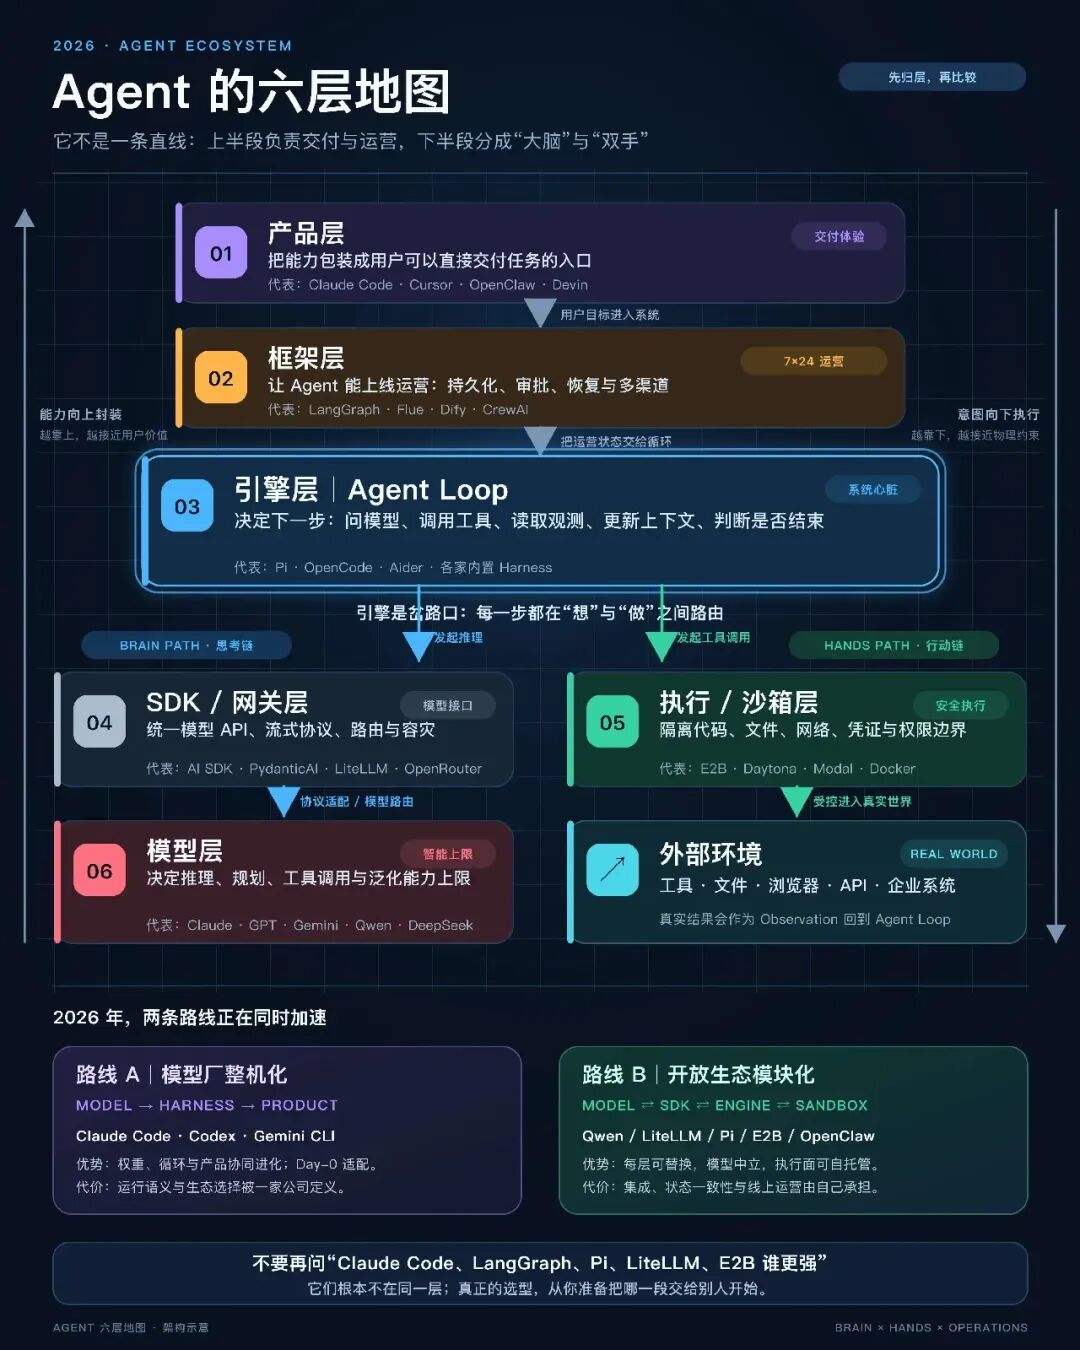
- 决策主链:用户目标 → 产品 → 框架 / 编排运行时 → 引擎 / Harness → 模型 SDK → 模型
- 执行侧链:引擎或框架发出 Tool Call → 沙箱 → 文件、浏览器、数据库与外部 API
这张图中的六层
第一层,产品:用户怎么把任务交给它。 Claude Code、Codex 这类产品已经替用户选好了模型、循环、工具和交互方式。用户买到的是“能干什么”,而不是一组零件。
第二层,框架:一个 Agent 怎么被长期运营。 LangGraph、Flue 等框架用于状态持久化、断点恢复、人工审批、定时唤醒、子 Agent、渠道接入、部署和可观测。判断一个东西是不是框架要看是不是有状态管理。
- 开发期 Framework 提供 Agent、Tool、Handoff、Role 等表达原语;
- 运行期 Orchestration Runtime 才承诺 Checkpoint、队列、定时、人工中断、幂等与故障恢复。
- OpenAI Agents SDK、ADK、CrewAI 更偏前者,LangGraph 与 Flue 更靠近后者
框架层会先于其他层消失。模型足够强,harness 就会被模型厂内置——Claude Code 们就是证据;接口足够标准,SDK 层一行代码切换模型;编排终将趋同成 YAML 配置。最后能收钱的只剩两端:最底下的算力,和最外侧的沙箱;中间的"框架",不过是部署脚本的另一种拼写。
第三层,引擎:循环本身怎么运行。 它负责整理上下文、把工具描述交给模型、解析工具调用、执行后把结果送回模型,并决定何时结束。Pi的核心价值就在这里:提供一个足够小、可以嵌入其他产品的模型接口与 Agent Loop。引擎更像 Agent 的Runtime,它的最小对象是一轮 Turn 或一个 Session;模型通常决定循环里的下一动作。Pi Agent Core 是最干净的例子。
第四层,SDK 与网关:怎么稳定地调用不同模型。 AI SDK、LiteLLM、OpenRouter 处理的是模型接口、流式输出、重试、路由、限流和成本记录。它们让上层少关心每家 API 的差异,但不替你拥有完整任务状态。
第五层,执行与沙箱:模型获准对世界做什么。 E2B、MicroVM、Daytona、Docker 或企业自己的 Kubernetes,负责隔离代码、文件系统、网络、凭证和资源配额。沙箱是“手”的安全边界。一个模型能写出再漂亮的 shell 命令,也不等于应该让它直接运行在生产主机上。
第六层,模型:系统能力的上限在哪里。 Claude、GPT、Gemini、Qwen、DeepSeek 等模型决定理解、规划、代码和工具使用的能力上限,但模型本身并不天然拥有持久状态,也没有真实世界的权限。
为什么大家总会把这些层混在一起?因为同一家公司、同一个项目经常跨层。Claude Code 既是产品,也包含自己的 Harness;一个框架可能顺手提供模型 SDK;一个沙箱平台也可能附带 Agent 模板。
分层是在问:这个组件的主要责任是什么? 理解六层最简单的办法,是做“消融实验”:
- 删除框架层,整个业务实例下一步进入哪个节点,如何持久化、审批、补偿和恢复?
- 删除引擎层,在当前节点里,模型下一步调用哪个工具,何时停止这一轮自主循环?
这也解释了为什么“Claude Code 和 LangGraph 谁更强”没有答案。
拿“修复仓库里失败的测试”走一遍,会比背名词更清楚:
1. Claude Code 或 OpenCode 接受任务、显示计划和 Diff、向用户申请权限——这是产品层;2. 如果公司规定“测试通过后必须由 Reviewer 批准才能开 PR”,并要求服务重启后继续,这个 Job、审批节点和 Checkpoint 属于框架层;3. 在“修复代码”节点内部,Agent 反复搜索文件、读代码、修改、运行测试,直到模型给出 Final Answer——这是引擎层;4. 每次把 Messages、Tools 和参数发给 Claude、GPT 或本地模型,是 SDK 层;5. 模型决定先 grep 还是先跑测试,是模型层;6. grep、pytest 和文件改写实际在 Docker 或 E2B 中运行,网络和凭证能否访问由沙箱层决定。
二、模型厂为什么开始“整机化”
过去模型厂主要卖 API。应用公司自己写 Prompt、接工具、存状态、处理失败。现在这条边界正在移动:模型厂不满足于只提供“大脑”,开始把 Harness、执行环境、渠道和产品体验一起打包。
OpenAI 的dots
是从产品层向下整合的典型:always-on Agent、自带云电脑和浏览器、连接数千个应用,并能出现在 ChatGPT、Slack 和 Teams 中。用户在给一个数字同事分配任务、权限和工作量。
Anthropic 的 Managed Agents
从引擎层向外做平台。它没有把所有东西塞进同一个容器,而是把系统拆成三个可以独立替换的对象:
- Brain:Claude 与 Harness,负责推理和选择动作;
- Session:追加写入的事件日志,负责保存完整过程。
在这套结构里,Harness 不需要知道“手”到底是一台容器、一部手机,还是客户的执行器。它只面对一个极小的接口:
execute(name, input) -> observation
Anthropic 披露,解耦以后,首 Token 延迟的 p50 下降约 60%,p95 下降超过 90%——没有用到沙箱的会话不再为沙箱启动付费。
后续的发展一定有下面的趋势:
第一,模型能力越来越依赖 Harness。 模型会不会在上下文快满时主动收尾,会不会正确恢复一次失败的工具调用,会不会在长任务中维护计划,都不只由权重决定,也由循环格式、工具反馈、上下文压缩和训练时轨迹决定。模型与 Harness 协同训练以后,“官方运行时”天然更容易拿到新模型的 Day-0 能力。
第二,产品承诺变成“完成一件事”。 卖 API 时,模型厂只对单次输出负责;卖 Agent 时,它必须同时对状态丢失、重复执行、越权、凭证泄露和失败恢复负责。谁对结果负责,谁就会想控制更多层。
第三,计费单位从 Token 向任务迁移。 当用户购买的是一个持续工作的数字员工,Token 只剩内部成本。商业竞争会转向任务成功率、响应时间、人工接管次数,以及一次失败要付出多少恢复成本。
三、实际怎么选?
沙箱层:传统 Infra生意
这层生意最像传统 Infra:保证隔离、速度和成本;选型还要同时看兼容性、隔离与安全。
- 进程级(Nsjail、seccomp):毫秒级启动、密度最高,但共享宿主内核;适合可信短任务,不是强多租户边界。
- 容器(Docker):镜像生态和 POSIX 兼容性最好;同样共享内核,安全高度依赖配置质量。
- gVisor:用用户态内核拦截 syscall,攻击面小于容器;部分系统调用和 I/O 会变慢或不兼容,是安全与性能的折中。
- microVM(Firecracker、Kata):任务拥有独立 Guest Kernel,隔离接近 VM,仍可百毫秒级启动。Firecracker 追求极简高密度,Kata 强调用容器接口管理 VM;E2B 采用这一路线。
- 完整 VM(QEMU):隔离和兼容性最完整,但启动、内存成本最高,适合长驻、高风险或强合规任务。
- WASM:启动最快、密度极高,靠能力模型限制文件和网络;短板是 POSIX、原生依赖与 GPU 生态,难以承载任意软件。
没有“最安全又最快”的统一答案:内部可信任务用容器;公网陌生代码优先 gVisor 或 microVM;强合规、长驻负载再上完整 VM;极短且能力受限的函数适合 WASM。
模型厂:押注 Harness 内置
这一派卖的是模型与runtime共同优化后的整机:上下文怎么压缩、工具怎样描述、失败如何重试、权限在哪里中断,都由同一家公司决定。
- Claude Code:Harness 闭源,但产品封装最完整。原生提供会话恢复、MCP、工具权限与非交互模式,也能通过 Bedrock、Vertex AI 或企业网关调用 Claude。优势是新模型能力能快速落到产品;代价是循环、上下文策略和模型选择主要由 Anthropic 定义。
- Codex dots:Harness 采用 Apache-2.0 开源,本地运行,沙箱、审批和
AGENTS.md 等控制面可以检查、修改和复用;同时,Codex 系列模型会针对长程编码任务优化。它比 Claude Code 更透明,但最顺滑的模型能力仍掌握在 OpenAI 手中。 - Google Antigravity:Gemini CLI 曾承担终端入口,2026 年个人用户开始迁移至 Antigravity CLI;新的 Antigravity SDK 又把同一套官方 Harness 提供给开发者自托管。它说明官方整机迭代最快,产品边界和生命周期也最受厂商战略影响。
这条路线适合追求“开箱即用和模型上限”的团队。风险是任务历史、权限规则、Skills 和评测数据逐渐围绕某家 Harness 生长:模型可以替换,runtime与生产习惯却很难迁移。
开源引擎:循环内核最重要
这一层竞争的是“模型—工具—观测—状态”做成最容易嵌入的公共内核。横向比较应看扩展性、封装度。
Pi、OpenCode、Crush、Aider 并不是四个同类项目。** 更准确的说法是:Pi 以可嵌入内核为中心,另外三个以可直接使用的 Coding Harness 为中心
- Pi:给想造 Agent 产品的人。 它把统一多模型 API、Agent Core、Coding Agent 与 TUI 拆成独立包;真正的核心契约是“Messages + Tools + Model → Event Stream / Final Result”。你可以在 Tool Call 前后加权限、换上下文压缩策略。它的优势是“可以作为零件”,但官方明确不内置沙箱:权限隔离、持久化和部署需要上层补齐。
- OpenCode:更接近完整终端产品,基于 AI SDK 接入 75 家以上 Provider 和本地模型,并提供细粒度工具权限。模型迁移方便、体验完整,但产品面更厚,不如 Pi 适合作为最小runtime嵌入。
- Crush:Go 实现,突出多模型、LSP、MCP、Skills、Hooks 与跨平台 TUI,适合希望把代码智能和终端体验一起拿走的团队;代价是抽象更有主张,许可也没有 Pi 的 MIT 那么宽松。
- Aider:最像 Git 原生的结对编程器。Repo Map 用依赖图压缩仓库上下文,每次修改可以自动提交和撤销;它在“改代码”上非常成熟,却不是面向任意业务 Agent 的通用循环内核。
要嵌入自己的产品,优先看 Pi;要多模型终端体验,看 OpenCode 或 Crush;要围绕 Git 做可审计编辑,Aider 更直接。
框架层:Demo 到持续运营的路径
框架层关注任务能否跨重启、跨审批、跨渠道继续运行。横向比较要看状态恢复和管理、人审&部署、可观测与团队语言栈。
- LangGraph:低层编排 Runtime,把确定性代码节点和模型决策放进同一张图,强项是持久执行、Checkpoint、Human-in-the-loop 与状态修改。它适合复杂审批、长任务和强审计场景;代价是状态图与恢复语义都要工程团队显式设计。
- Flue:走 TypeScript 路线,底层复用 Pi,用 Hooks 描述模型、生命周期和持久状态,再用 Durable Stream 处理崩溃恢复,并接入沙箱、子 Agent、MCP 与聊天渠道。它对 TS 全栈团队更自然;风险是生态仍年轻,对 Pi 和自身运行时语义依赖较深。
- Dify / Coze:把模型、知识库、插件、条件分支与代码节点放进可视化画布,适合业务团队快速搭建客服、知识助手和固定流程。短板不是功能少,而是流程复杂以后,自动化测试、代码审查和跨项目复用会越来越困难。
- n8n:本质是自动化平台,优势是触发器、凭证、SaaS 连接器、执行记录、失败重试与人工审批;AI Agent 只是工作流中的一个节点。它适合“让 AI 接入现有业务系统”,不适合让开放式 Agent Loop 成为系统的主控制器。
LangGraph 让代码拥有顶层控制权,Flue 让长期 Agent 拥有顶层控制权,Dify / Coze 让画布拥有顶层控制权,n8n 让业务集成拥有顶层控制权。 功能可以互相补,控制权的默认归属却很难改,这才是选型时最该看的差别。
结语
亲爱的朋友,下次再有人问改怎么选框架、或者你用的什么框架,你应该就知道要怎么和他聊了吧。
