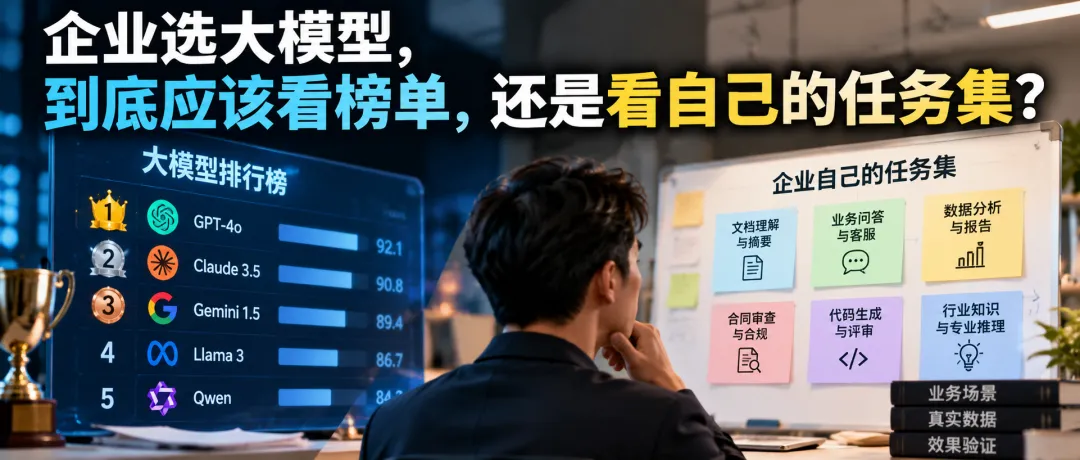
最近一两年,企业选大模型这件事越来越像“看榜单”。谁的参数更大、谁的Benchmark更高、谁在某个评测里排第一,往往很快就会变成讨论焦点。
但真正进入企业项目以后,不应先问“哪个模型最强”,反而应先问一句:你准备让它做什么?
因为榜单回答的是一个通用问题:模型在公开测试集上表现怎么样;而企业真正关心的是另一个问题:在我的文档、我的数据、我的流程和我的风险边界里,它到底好不好用。
我的建议:公开榜单适合做“候选池”,企业自己的任务集才应该决定最终选型。 |
一、榜单有用,但它解决不了企业真正的选型问题
我并不反对看榜单。恰恰相反,榜单很适合做第一轮筛选:你可以快速知道哪些模型在推理、代码、长文本、多模态、中文理解等方向处于什么水平,也可以排除明显不匹配的候选。
问题出在很多企业把“筛选工具”当成了“最终答案”。
公开榜单通常基于标准化测试集,追求的是可比较性;企业场景却天然不标准。一个制造企业关心设备故障问答,一个能源企业关心经营指标,一个集团总部关心制度知识,一个客服中心关心实时对话。即便都叫“问答”,背后的任务结构也完全不同。
所以我更愿意把榜单理解成“高考成绩”,而不是“岗位试用期”。高考能告诉你基本能力,但一个人到底能不能把具体岗位做好,还是要回到真实任务。
二、企业真正应该建立的,不是“模型排行榜”,而是自己的任务集
所谓“企业任务集”,不用一开始就做得很复杂。它本质上是一组能够代表真实业务工作的测试任务。
如果你做知识问答,就用真实制度、合同、技术文档里的问题;如果你做智能问数,就用真实指标、复杂口径和追问链;如果你做Agent,就测工具调用、异常处理和流程闭环;如果你做代码生成,就测你自己的技术栈和代码规范。
任务类型 | 企业自己的测试样本 | 真正要看的指标 |
业务文档理解 | 制度、合同、方案、技术文档 | 能否理解真实语义并引用正确依据 |
知识问答 | 高频问题、跨文档问题、冲突知识 | 准确率、可追溯、拒答边界 |
数据分析 | 指标解释、趋势分析、异常定位 | 口径一致、计算正确、解释可信 |
代码/脚本 | 企业技术栈、接口、SQL | 正确性、可运行性、修改成本 |
流程执行 | 调用系统、填写表单、生成结果 | 成功率、权限、安全和异常兜底 |
这一步最大的价值,是把“模型厉不厉害”这个抽象讨论,变成“它在我的任务里到底能不能用”的工程问题。
三、真正容易把企业带偏的,是只看一个总分
很多模型评测最终会收敛成一个分数,甚至一个排名。但企业选型最怕的,恰恰就是“总分思维”。
因为企业任务的风险不一样。一个内部资料摘要错一次,可能只是影响效率;一个经营指标算错、一个合规问答答错、一个Agent误执行系统操作,后果完全不同。
所以企业任务集最好不是简单求平均分,而是带权重、带底线。
评价维度 | 示例权重 | 关注点 |
准确性 | 35% | 核心业务结果是否正确 |
稳定性 | 20% | 同类问题多次运行是否一致 |
时延 | 15% | 是否满足业务交互要求 |
成本 | 10% | 单位任务成本是否可接受 |
可解释/可追溯 | 10% | 结果能否定位到来源或计算过程 |
安全与可控 | 10% | 权限、拒答、工具调用边界是否可靠 |
这里的权重不是固定答案。真正关键的是:先定义你的业务最怕什么,再决定模型该怎么比。
四、我更推荐“三轮选型”,而不是一上来做大规模POC
第一轮,看公开信息,快速形成3—5个候选。榜单、官方能力、价格、上下文长度、部署方式、国产化适配,这些都可以在这一轮解决。
第二轮,用企业任务集做桌面评测。哪怕只有50—100条高质量样本,也比拿几道演示问题轮流问一遍更有价值。
第三轮,只让最后1—2个候选进入真实场景试运行。把真实数据、真实用户、真实接口和真实约束放进去,再看稳定性、成本和业务接受度。
这样做的好处是,企业不会因为“某个模型在榜单上第一”就过早锁定技术路线,也不会因为POC做得太重,把选型本身做成一个小项目。
五、还有一个经常被忽略的问题:模型不是一次选定,三年不变
企业选模型最容易陷入“招标式思维”:这次选出一个最好的,以后长期就用它。
但大模型迭代速度太快,模型能力、价格、上下文窗口、工具调用能力都在快速变化。今天最合适的模型,半年后未必仍然最优。
因此,任务集真正重要的地方,不只是帮你“选一次”,而是给企业建立一套持续评测机制。以后新模型来了,不需要重新争论,只要跑一遍自己的任务集,就知道值不值得换。
结尾
企业真正需要的,不是追逐每一期排行榜,而是建立自己的评测基准。因为只有当模型回到真实业务里,性能、成本、稳定性和风险才有意义。
以后再有人问“哪个大模型最好”,我会更愿意反问一句:对你的任务来说,什么叫“最好”?
关注「凯哥谈企业 AI」
用真实项目经验,聊透企业AI怎么选、怎么建、怎么落地。