不说话的 AI 怎么选?Jev 开源生态全景与决策模型选型指南
一个不会写句子、只返回概率的模型,为什么在发布十天内催生了上百个开源项目?当"开源版 Jev"满天飞时,真正该看的不是 Star 数,而是它到底开源了什么、技术路线差在哪、你的场景能不能用。
01 摘要
2026 年 9 月 15 日,TypeSafe AI 发布了 Jev——一个被称为"System One Model"的决策模型。它不生成文字,只接收一段程序状态和一组带类型的问题,返回选择、概率或评分。输入定价 0.042 美元/百万 token,输出免费,延迟 70–500 毫秒。
短短一周内,社区出现了约 30 个开源复现项目,两周后这个数字膨胀到 160+。但把它们都叫"开源版 Jev"会掩盖最关键的区别:有的重新训练了模型权重,有的只改了推理方式,有的只是套了个兼容接口的应用层。
本文按"到底开源了什么 → 技术路线区别 → 落地怎么选"的逻辑,梳理 Laya、Kev、decider、Nimble 四个开放权重模型,SemIf、AnyJev 等推理层方案,BERT/GLiClass 等已有替代技术的边界,以及应用层集成项目。文末附选型决策树和行动清单。
02 Jev 到底是什么:一个"不说话"的决策层
从"生成答案"到"返回决定"
传统大语言模型的工作方式是:你给一段提示,它一个 token 一个 token 地生成回答。哪怕你只需要一个"是/否",它也可能先写一段推理,最后才给出结论。
Jev 走了另一条路。你给它当前程序状态(state)和一组带类型的问题,它直接返回程序可以消费的结构化结果。TypeSafe 把训练方法称为 RLCD(Reinforcement Learning for Calibrated Decisions,面向校准决策的强化学习),目标不是让人类喜欢回答,而是让模型报告的概率和实际正确率对齐。
用一句话概括:LLM 擅长"生成一段答案给人看",Jev 强调"直接给程序一个可以执行的决定"。
三类决策原语
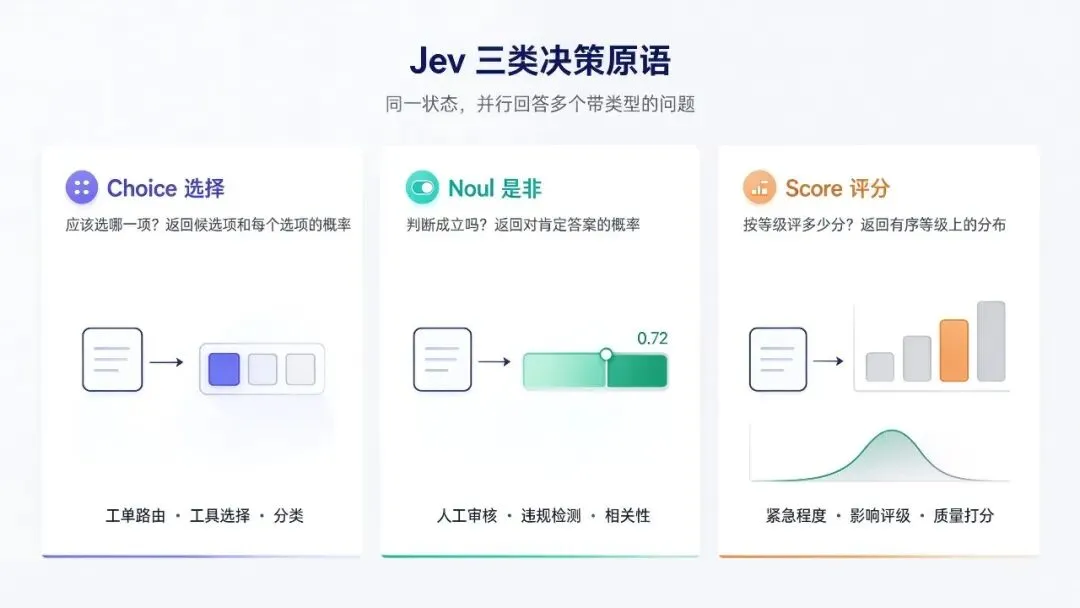
Jev 的接口只有三种原语,但覆盖了软件流程中绝大多数"小判断":
图1:Jev 三类决策原语示意。来源:根据 TypeSafe 官方文档与 DAIR.AI 教程整理,自制。
关键不在于"模型终于会输出 JSON 了",而在于把有限选项的语义判断做成了一种可组合的接口。官方强调同一状态下的多个问题可以并行回答——但这并不能直接证明内部用了哪种架构,也不代表所有问题只经过一次物理前向计算。
价格和速度为什么有冲击力
官方称输入价比 Claude Fable 5.1 低 238 倍。一个典型分类调用约 300 输入 token,成本约 0.0000126 美元——1 美元可以跑约 8 万次。
但有一个容易忽略的细节:Opper 的独立测试发现,Jev 对每个请求会计收约 257 个固定额外 token(大概率是内部提示词)。一条短消息加一个问题,Jev 计 280 token,而兼容的 Kev 只计 23 token。短请求场景下,这个固定开销会让实际成本差距比标价更大。
必须划清的边界
• Jev 没有开源。 截至本文核验时,官方发布页、文档和代码仓库中均未提供模型权重和完整训练配方的公开下载。适配器、Skill 等代码公开,不等于模型本身开源。
• 类型安全 ≠ 判断正确。 模型没有返回候选集之外的内容,不代表它选中了正确候选。
• 0.9 的置信度 ≠ 九成正确率。 不同实现的 confidence 未必是同一种统计量。Noul 的概率本身就是主要输出,并没有另一个独立的 confidence 字段。
• Jev 不是完整 Agent 框架。 它不负责规划、记忆或工具执行,更接近工作流里的一个"决策部件"。
03 "开源 Jev"的迷雾:先分清四类东西
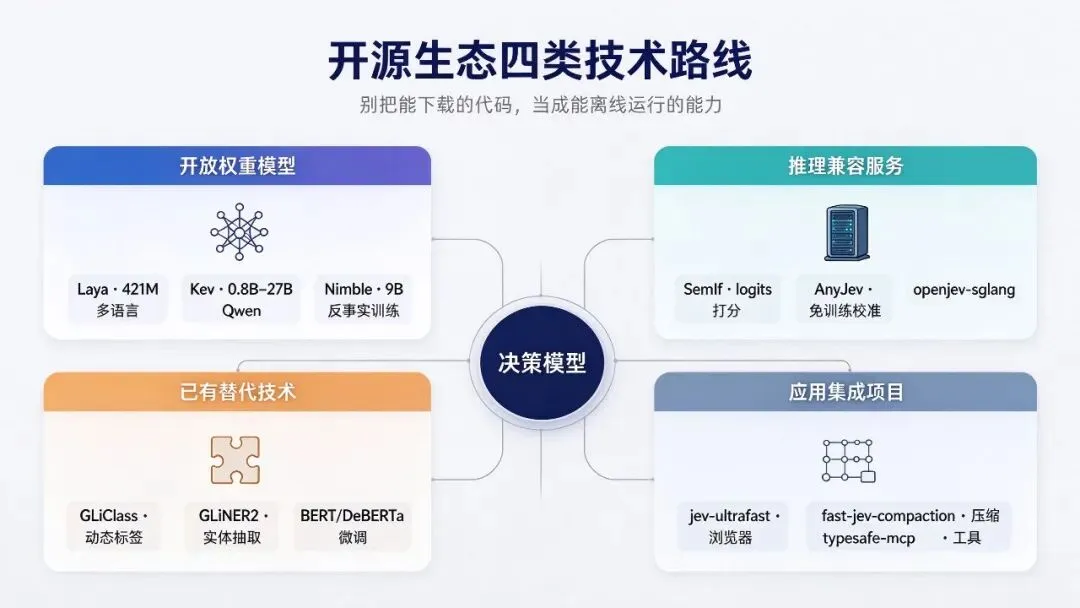
把所有相关项目放在一起比较,就像把"开源操作系统"和"开源桌面壁纸"混为一谈。先建立分类,后面的项目才看得懂。
图2:Jev 开源生态四类技术路线分类。来源:根据各项目仓库与公开资料整理。
| | | |
|---|
| 开放权重决策模型 | | | |
| 开源推理与兼容服务 | | SemIf、Simple Jev、openjev-sglang、AnyJev | |
| 已有替代技术 | | GLiClass、GLiNER2、DeBERTa、ModernBERT、XGrammar | |
| 决策能力的应用集成 | | jev-ultrafast、fast-jev-compaction、typesafe-mcp | |
这四类并不完全互斥。一个推理服务器可以同时支持原始 LLM 和已训练的决策模型;一个 MCP 项目也可以从 Jev 切换到本地后端。分类的目的,是避免把"代码能下载"误读成"整套能力都能离线运行"。
04 开放权重模型:四大家族深度拆解
4.1 Laya:小尺寸编码器路线,多语言是亮点
Laya 由 ConvAI Innovations 发布,Apache 2.0 许可,最大的特点是没有把方案绑定在几 B 参数的生成式模型上,而是走编码器路线。
项目方自测数据显示,在单张 T4 上,laya 处理 50 个问题/调用的 p50 延迟为 771ms,多语言版为 337ms。在公开数据集上,laya 在 AG News 上达到 0.947(Jev 公布值 0.910),在 DAIR Emotion 上 0.573(Jev 0.480),在 typed-decisions 上 0.766(Jev 0.727)。
但这些数字需要谨慎解读: - 这是项目方自测,Jev 数值引用第三方公开结果,并非同一环境下的同步测试。 - 定向微调模型的成绩不能视作基础模型的通用能力。 - "覆盖 100+ 语言"不等于"中文复杂业务表现已充分验证"。中文长文档、否定关系、跨句条件、专业术语和类别边界,仍需单独评测。
Laya 的另一个价值是公开了微调入口。对已有工单、内容分类或审核标签的团队来说,比起追逐通用榜单,更值得验证的是:用自己的决策样本微调后,是否能在保留测试集上减少错误,并让拒答阈值更可靠。
4.2 Kev:从模型、微调到本地服务的完整路线
Kev 由 Jared Palmer 开发,基于 Qwen3.5/Qwen3.8 系列底座,模型族包含 0.8B、4B、9B 和 27B,提供训练、评测与服务代码,Apache 2.0 许可。据报道,4B 模型的训练成本约 95 美元 H100 机时。
对工程团队的吸引力在于衔接完整:有开放权重,有校准温度,有本地服务,还能将 TypeSafe Python SDK 直接指向 Kev 后端。已经采用类似接口的应用,可以在接口层做替换试验。
独立对比测试怎么说? Opper 在 2026 年 9 月 25 日发布了 Kev 4B 与 Jev 的头对头测试,使用 362 条两个模型都不可能见过的新数据(新 arXiv 论文、Stack Exchange 问题、GitHub issues):
| | | | |
|---|
| | | | |
| Stack Exchange 站点(6 选项,n=120) | | | | |
| | | | |
结论:准确率在 2 个百分点以内(属于样本噪声范围),但校准差距明显。 Jev 报告的概率更贴近实际正确率,Kev 在 Stack Exchange 和 GitHub 任务上的置信度漂移较大。
速度方面,通过 Opper 端点,Kev 中位约 220ms,Jev 约 275ms——大部分时间是网络往返而非模型推理。
还有一个细节:Kev 官方结果表中每个单元格的两个数字分别是 development / test。例如新来源数据上 Kev-27B 为 0.848 / 0.896,Jev 为 0.857 / -(无 test 结果)。不能拿 Kev 的 0.896 和 Jev 的 0.857 直接比较然后宣称"开源超过闭源"——对齐比较的是开发集上的 0.848 和 0.857,且双方训练数据并非受控一致。
4.3 decider:版本得失比速度更值得看
Mapika 的 decider 同样采用 Qwen 路线,decider-2b 提供本地推理和 System One 风格接口。
它的模型卡比较有价值的地方是写出了训练阶段与版本差异: - v10 包含强化学习阶段; - v11 加入更难样本上的监督微调、旧分布回放,以及按答案类型区分的温度校准。
但"新版本"不等于"全任务升级"。模型卡明确说明,v11 在部分难判断和文档任务上改善,也在部分日常任务和游戏任务上回退,甚至版本发布准则中未满足的条件也有披露。
这直接影响生产选型:应该固定模型修订、推理包版本和校准参数,而不是长期追着 latest 跑。 某个任务上的改进,不应成为跳过自身回归测试的理由。
4.4 Nimble:反事实样本 + 开放配方
Bespoke Labs 的 Nimble 公开了 9B 模型(基于 Qwen3.5,LoRA 训练),以及完整的训练数据和配方。项目的核心思路是反事实样本:修改输入中的关键事实,让正确答案随之变化,推动模型根据证据而非表面词汇作答。
例如规则是"只有 Mira 可以授权账户 42 的退款"。样本 A 中授权人是 Mira → 答案 true;样本 B 中授权人是 Noah → 答案 false。通过这种配对,模型学会关注真正决定答案的事实。
在 324 条留出样本上,Nimble-9B 达到 90.1%,Jev 1.13.0 为 93.2%,差距约 3 个百分点。相比其底座 Qwen3.5-9B 的 66.4%,提升了 24 个百分点;甚至超过了 3 倍大小的 Qwen3.8-27B(84.9%)。
工程细节上,Nimble 的 Apple/MLX 路线与 CUDA 服务路线对共享上下文和逐字段打分的处理不同。评估时最好同时固定权重版本、后端、输入长度和字段数量,否则"同一个项目"的两个速度数字可能没有可比性。
4.5 还有哪些值得留意
| | |
|---|
| | |
| Verdict / openJev-verdict-2.0 | | 仓库涉及多个模型,通用 151M 权重与 Verdict 2 专用模型不能混为一谈 |
| | |
| | 与其他同名 OpenJev 项目不是一回事,核对具体权重与输入形式 |
这里不做跨项目"准确率排行榜",因为这些模型的测试任务、数据划分、版本与硬件差异很大。数字可以提供线索,但不能自动形成排名。
05 不训练也能用:推理层改造路线
不是每个团队都需要从头训练一个新模型。已经部署了开放模型,可以先尝试把生成式调用改成候选打分。
SemIf:让已有模型直接给选项打分
SemIf(当前仓库名 SemIf-OpenJev,MIT 许可)的核心思路是:使用已有模型,对候选答案对应的 logits 打分,再由服务端构造结构化结果,而不是让模型逐字生成一段答案。
多个问题共享状态时,相关实现会复用共享前缀(KV cache),减少重复处理。它探索的是"怎样更经济地使用已有模型",不是公开了 Jev 的内部权重。
值得更新的一点:SemIf 已加入针对具体工作负载的温度校准实验,因此"它完全没有校准机制"已不准确。但在某个验证集上校准过,不代表可以把同一个温度和阈值照搬到所有任务。
概率从哪来:一个简化公式
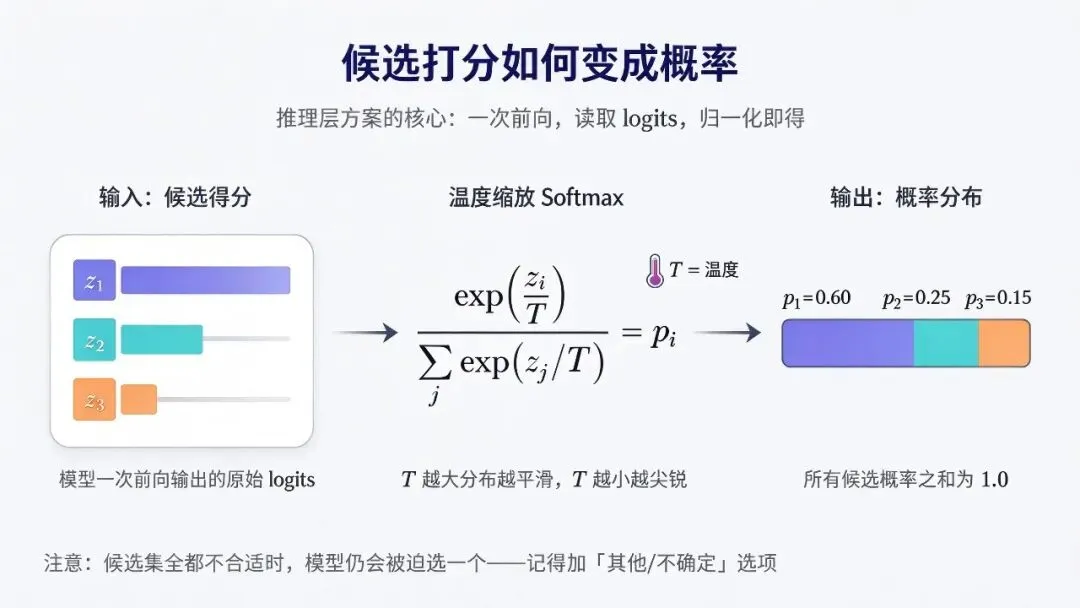
对于候选-logit 实现,可以用温度缩放的 softmax 理解概率来源:
图3:候选 logits 经温度缩放 softmax 归一化为概率分布。来源:根据 SemIf 等项目的实现原理整理。
公式表达为:
pᵢ = (exp(zᵢ / T)) / (Σⱼ exp(zⱼ / T))其中 zᵢ 是候选得分,T 是温度。这个式子描述的是在给定候选集合内如何归一化分数,不是对所有项目内部机制的统一描述。
它解释了两个重要问题:
1. 候选集合全都不合适时,模型仍可能被迫从中选一个。 是否包含"其他/信息不足"选项,需要主动设计。
2. 分布很尖锐不等于答案很正确。 候选 ID 如何编码、是否对应单个 token、顺序是否影响答案,都需要测试。
Nokia AnyJev:免训练的校准层
2026 年 9 月 23 日,诺基亚贝尔实验室发布了 AnyJev(Apache 2.0,PyPI 可安装),这是一个无需训练的 Python 库,可以把任意开放 LLM 转换为校准过的决策模型。
它的价值在于:不需要微调,直接在推理层修正选项顺序偏差、调整概率校准,并原生兼容 Hugging Face 和 vLLM 等推理引擎。对于已经有部署好的开放模型、不想再投入训练资源的团队,这是一个低门槛的切入点。
其他推理层项目
| | |
|---|
| 用兼容开放模型读取候选 logits、复用共享前缀,由服务端构造响应 | 不因输出格式相似就具有 Jev 的准确率和校准能力 |
| 基于 SGLang 的开放模型、prefill-only 决策接口 | |
| 基于 DiffusionGemma 等路线的兼容服务 | 不应与 SemIf 或其他同名项目混淆,也不是 TypeSafe 官方项目 |
这条路线适合快速建立基线、复用已有模型资源。它省掉的是部分生成和重复计算,不是省掉任务验证。
06 老技术新战场:BERT、GLiClass 等替代方案的边界
可以替代其中不少工作,但需要对齐任务,而不是只对齐产品名字。
| | |
|---|
| BERT/ModernBERT + 任务微调 | | 基础模型通常还需训练任务头,不是下载后就天然具备通用决策接口 |
| DeBERTa 零样本分类 | | 常将文本与候选假设组成 NLI 对,候选数量影响计算量,可批处理优化 |
| GLiClass | 动态标签、多标签分类,不想对每个标签分别做 NLI | 本身就是开放分类路线,不需要借 Jev 的名字才成立 |
| GLiNER2 | | 返回内容可来自文本中的实体与结构,而非仅在有限候选中选择 |
| LLM + XGrammar | | 约束合法输出,不自动保证语义正确,也不等于获得校准过的决策概率 |
一个实际判断框架:
• 已经积累了大量中文工单标签? 把成熟分类模型纳入基线,不要因为"Jev 很火"就推倒重来。
• 问题描述、候选项和评分标准经常变化? 且一次要对同一状态作多个不同判断 → Jev 风格的统一接口更值得评估。
• 需要从文本中抽取实体再分类? GLiNER2 可能比纯候选选择更直接。
• 需要生成解释或开放文本? 决策模型不适合,还是得用 LLM。
真正要比较的是任务适配能力、错误成本和自动化覆盖率,不是"传统模型"和"新模型"哪个名字更先进。
07 应用层:决策模型如何嵌入真实工作流
这一层的代码最容易被误认为"Jev 开源了"。实际上,很多项目开源的是工作流,底层仍需要调用模型服务。
| | |
|---|
| browser-use/jev-ultrafast | | 应用开源不等于模型本地化;动作还要经过页面状态与合法性校验 |
| | 更接近选择式压缩,不是对所有历史内容重新摘要;默认依赖 Jev |
| | 已支持自定义后端,可连接兼容的本地模型(如 Laya) |
| | 工具名叫"审核"或"门控",不代表可代替权限控制和确定性校验 |
| | 可借鉴局部决策设计,不应理解为自动替代整个 GraphRAG 流程 |
对 RAG、DeepResearch 或科研助手,可以借鉴的思路是:把流程中的"小判断"单独拿出来。
• 检索结果是否值得保留?
• 当前证据够不够支持某个结论?
• 下一轮应该查文献、查网页,还是回到用户补充条件?
这是可测试的系统设计建议,不是上述项目已经在这些科研任务上完成验证的结论。涉及专业事实、引用支撑和高影响动作时,决策结果仍需与证据校验、权限约束和人工复核配合。
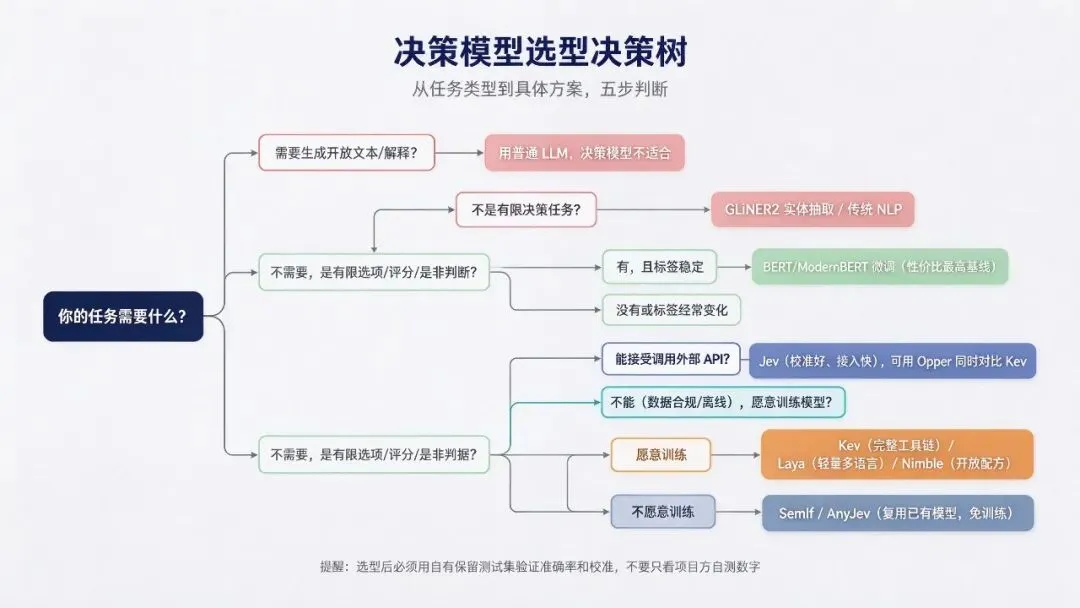
08 选型决策树:你的场景该用什么
图4:决策模型选型决策树。来源:根据全文各技术路线整理。
几个反直觉的提醒:
1. 不要用项目方自测的准确率做选型依据。 用你自己的保留测试集,在相同硬件上跑对比。
2. 校准比准确率更值得关注。 一个 90% 准确但置信度乱报的模型,在自动化流程中比 85% 准确但校准良好的模型更危险。
3. 固定版本,不要追 latest。 decider 的版本回退、Nimble 的后端差异都说明:生产环境必须锁定权重版本、推理包和校准参数。
4. 短请求注意固定 token 开销。 Jev 每请求约 257 额外 token,在短文本高频调用场景下会显著放大成本。
5. "其他/信息不足"选项必须主动设计。 候选-logit 方法在所有选项都不合适时仍会被迫选一个。
09 总结与行动清单
核心结论
Jev 的真正贡献不是"又一个分类器",而是把 LLM 已有的语义理解能力封装成软件可以低成本、高频、稳定调用的一层智能决策接口。分类只是它能完成的一种决策形式,路由、评分、判断、筛选、验证、工作流分支都在其覆盖范围内。
开源生态的爆发说明这个需求是真实的——但 160+ 项目中,绝大多数是接口兼容或应用层包装,真正重新训练了决策模型的只有少数几个。选型时最重要的不是 Star 数,而是问清楚:它到底开源了什么?我的任务验证过了吗?校准可靠吗?
行动清单
1. 盘点你系统中的"小判断"节点。 哪些地方现在用 if-else、正则或 LLM 生成后解析?这些是决策模型的候选切入点。
2. 建立自有评测集。 至少 200 条标注样本,覆盖正常、边界和困难案例,作为所有模型对比的统一基准。
3. 先跑低成本基线。 用 BERT 微调或 SemIf/AnyJev 建立基线,再决定是否值得投入训练或调用 Jev API。
4. 对比时同时看准确率和校准。 不要只看 top-1 正确率,画可靠性图(reliability diagram),看置信度和实际正确率的偏差。
5. 设计兜底机制。 低置信度时升级人工审核,候选集外设置"其他/不确定"选项,高影响动作加确定性校验。
6. 固定生产版本。 锁定权重版本、推理框架版本、温度参数,建立回归测试后再升级。
参考文献
[1] 一文梳理 Jev 开源生态:Laya、Kev、SemIf 与开源替代方案. ChallengeHub. 2026-09-26. 本地 PDF(无公开 URL).
[2] TypeSafe AI 官方网站. https://typesafe.com. 访问日期:2026-09-26.
[3] Jev and TypeSafe AI: Inside the First System One Model and RLCD Training. Analytics Made Simple. https://analyticsmadesimple.com/tutorials/jev-typesafe-ai-system-one-model-rlcd-tutorial/. 访问日期:2026-09-26.
[4] Jev vs. Kev: an open-source Jev alternative, tested side by side. Opper. 2026-09-25. https://opper.ai/blog/jev-vs-kev-open-decision-model. 访问日期:2026-09-26.
[5] Laya — an open 421M decision model that replies in 33 milliseconds. AI/TLDR. https://ai-tldr.dev/releases/convai-laya/. 访问日期:2026-09-26.
[6] Laya is a 421M open-weights answer to Jev. DEV Community. https://dev.to/techaiwire/laya-is-a-421m-open-weights-answer-to-jev-4n97. 访问日期:2026-09-26.
[7] Kev: Tiny Jev-like family of decision models built on top of Qwen3.5. Prismix. https://prismix.dev/news/67d17b89a42e. 访问日期:2026-09-26.
[8] Jared Palmer ports Kev to Qwen3.5 for roughly $95 in H100 time. RuntimeWire. https://runtimewire.com/article/jared-palmer-kev-qwen35-decision-models. 访问日期:2026-09-26.
[9] Introducing Bespoke Nimble: an open data, open model, open recipe for an open Jev. Bespoke Labs. https://huggingface.co/bespokelabs/Bespoke-Nimble-9B. 访问日期:2026-09-26.
[10] Bespoke Labs' Nimble Beats a 27B Model at Classification Using Just 9B. AlphaSignal. https://alphasignal.ai/news/bespoke-labs-nimble-beats-a-27b-model-at-classification-using-just-9b. 访问日期:2026-09-26.
[11] SemIf-OpenJev 项目仓库. https://github.com/TheoLeeCJ/SemIf-OpenJev. 访问日期:2026-09-26.
[12] Nokia Open-Sources AnyJev: A Training-Free Layer That Turns Any Open LLM Into a Calibrated Decision Model. MarkTechPost. 2026-09-23. https://www.marktechpost.com/2026/09/23/nokia-open-sources-anyjev-a-training-free-layer-that-turns-any-open-llm-into-a-calibrated-decision-model/. 访问日期:2026-09-26.
[13] What Is RLCD? The Secret Behind Jev. Di Zhang. 2026-09-21. https://di-zhang-llm.github.io/blog/what-is-rlcd-the-secret-behind-jev/. 访问日期:2026-09-26.
[14] Jev AI Pricing Explained: $42 Per Billion Tokens, Free Output. MindStudio. https://www.mindstudio.ai/blog/jev-pricing-cost-per-token. 访问日期:2026-09-26.
[15] 输出token永久免费,Jev爆火后,开源版也跟着火了. 36氪. 2026-09-20. https://36kr.com/p/3991444838857731. 访问日期:2026-09-26.
[16] The decision-primitive moat lasted 72 hours: open Jev clones arrive. cere-bro. 2026-09-19. https://bayesiansapien.github.io/cere-bro/ai-routing/2026-09-19-jev-open-clones-commoditization/. 访问日期:2026-09-26.
[17] Benchmarking Jev: what a decision model can (and can't) do in an agent harness. DEV Community. https://dev.to/aitejiu/benchmarking-jev-what-a-decision-model-can-and-cant-do-in-an-agent-harness-20po. 访问日期:2026-09-26.
[18] Beyond Autoregression: Running JEV and Open "System 1" Decision Models on Google Cloud. DEV Community. https://dev.to/francisco_riveros/beyond-autoregression-running-jev-and-open-system-1-decision-models-on-google-cloud-23kp. 访问日期:2026-09-26.