AgentBench:评测 LLM 作为智能体的能力
- 更新时间 2026-10-01 22:44:57
原文:AgentBench: Evaluating LLMs' Abilities as Agents
作者:Xiao Liu、Hao Yu、Hanchen Zhang(共同一作,清华大学)等 21 人|清华大学、俄亥俄州立大学、UC Berkeley
出处:ICLR 2024(第十二届国际学习表征会议)|arXiv:2308.03688
代码与评测集:https://github.com/THUDM/AgentBench
摘要
大语言模型(Large Language Model, LLM)作为智能体的潜力近期已得到广泛认可。因此,迫切需要在交互环境的具有挑战性的任务上,对 LLM 作为智能体的能力进行定量评测。我们提出 AgentBench——一个由 8 个不同环境组成的多维度基准,用于评估"LLM 作为智能体"(LLM-as-Agent)的推理与决策能力。我们对 29 个 API 模型与开源(OSS)模型的大规模测试表明:尽管顶级商业 LLM 在复杂环境中展现出很强的智能体能力,但它们与许多参数量不超过 70B 的开源竞争者之间存在显著的性能差距。我们识别了各环境与各 LLM 中失败的典型原因,指出糟糕的长期推理、决策与指令遵循能力是开发可用 LLM 智能体的主要障碍。改进指令遵循、用高质量多轮对齐数据训练可以提升智能体性能。此外,与现有假设不同,在代码上训练对不同智能体任务呈现出矛盾的影响。AgentBench 的数据集、环境与一体化评测包已发布于 https://github.com/THUDM/AgentBench。
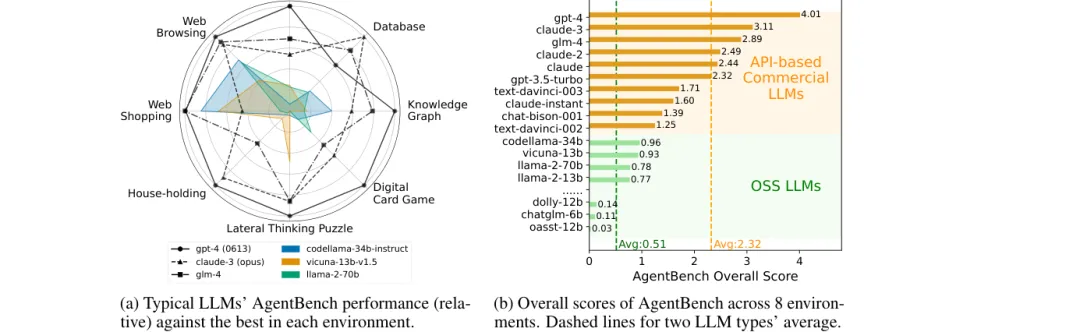
图 1:各 LLM 在 AgentBench 上的概览。左:(a) 典型 LLM 在 8 个环境中相对于各环境最优模型的表现(相对值雷达图);右:(b) 跨 8 个环境的 AgentBench 总分,虚线为两类 LLM 的平均值。虽然 LLM 开始显现其"作为智能体"的胜任力,但模型之间的差距以及通往实际可用性的距离依然显著。
1 引言
能够在特定环境中进行决策与执行动作的智能体与自治实体(Searle, 1970; Maes, 1994; Wooldridge & Jennings, 1995)历来是人工智能(AI)的核心概念。尽管深度学习算法在计算机视觉与自然语言处理(NLP)中取得了长足进步,但其在开发高效、实际可用的辅助智能体方面的潜力仍在很大程度上未被发掘。
大语言模型(LLM)的出现(Brown et al., 2020; Chowdhery et al., 2022; Touvron et al., 2023),例如 GPT-4(OpenAI, 2023),为这一领域带来了大量新机会。通过大规模的对齐训练(Ouyang et al., 2022; Wei et al., 2022a; Sanh et al., 2022),LLM 不仅掌握了传统 NLP 任务,还展现出理解人类意图与执行指令的出色能力。这催生了各种基于 LLM 的自主目标完成应用(如 AutoGPT(Richards, 2023)、BabyAGI(Nakajima, 2023)、AgentGPT(age, 2023)),以及置于社交与游戏情境中的 LLM 智能体(Park et al., 2023; Wang et al., 2023b; Zhu et al., 2023),引发了广泛的公众关注与讨论。
尽管有这些进展,缺乏一个系统、标准的"LLM 作为智能体"评测基准构成了关键挑战。历史上,基于文本的游戏环境(Osborne et al., 2022; Côté et al., 2019; Hausknecht et al., 2020; Urbanek et al., 2019)曾被用于语言智能体评测,但它们往往受限于封闭、离散的动作空间,且主要聚焦于模型的常识落地(commonsense grounding)。更近一些,具身智能体方面的工作(Reed et al., 2022; Huang et al., 2022; Ahn et al., 2022; Li et al., 2022a)采用了基于游戏(Küttler et al., 2020; Fan et al., 2022)、GUI(Shi et al., 2017; Toyama et al., 2021)与室内场景(Shen et al., 2021; Srivastava et al., 2022)的复杂多模态模拟器。然而,这些模拟器尽管复杂,却并不能准确反映 LLM 的实际用例,而且其多模态特性也为紧急评测现有纯文本 LLM 制造了障碍。最后,现有的多数智能体基准只聚焦单一环境,无法提供 LLM 跨多样应用场景的综合概览。
为应对这些挑战,我们提出 AgentBench——一个设计用于在多种不同环境中评测"LLM 作为智能体"的多维度基准。AgentBench 包含八个不同的环境(参见图 4,其中五个为首次创建),可归为三种落地类型:
• 代码(Code):操作系统(Operating System)、数据库(Database)、知识图谱(Knowledge Graph)(Anonymous, 2023)
• 游戏(Game):数字卡牌游戏(Digital Card Game)、横向思维谜题(Lateral Thinking Puzzles)、家务(House-Holding)(Shridhar et al., 2020b)
• 网络(Web):网络购物(Web Shopping)(Yao et al., 2022)、网页浏览(Web Browsing)(Deng et al., 2023)
所有数据集,无论是新创建的还是改编自现有资源的,都经过精心设计与重新表述,以模拟纯文本 LLM 可作为自治智能体运作的交互环境。由此,AgentBench 系统性地评测 LLM 的核心能力,包括指令遵循(Ouyang et al., 2022)、编码(Chen et al., 2021)、知识获取(Joshi et al., 2017; Talmor et al., 2019)、逻辑推理(Srivastava et al., 2023)与常识落地(Shridhar et al., 2020a)。它同时是 LLM 评测与智能体评测的理想试验台。
此外,我们开发了一个统一评测工具包,使 LLM 能够在多样化的自定义智能体任务上运行,从而对 29 个不同 LLM(含 API 模型与开源模型)在 AgentBench 上的"作为智能体"能力进行了全面基准测试。结果表明,GPT-4 等顶级模型有能力处理广泛的现实任务,显示出打造强大、可持续学习智能体的潜力。但我们也注意到这些顶级模型与开源竞争者之间存在显著性能差距。尽管开源 LLM 近期取得成功并在若干基准上颇具竞争力(Li et al., 2023; Chen et al., 2021; Cobbe et al., 2021),它们在具有挑战性的 AgentBench 任务上的表现明显落后。这凸显出进一步提升开源 LLM 学习能力的必要性。
我们识别了不同环境与 LLM 中部分智能体任务的失败原因,揭示出现有 LLM 长期推理、决策与指令遵循能力的不足。不同 LLM 之间的比较表明,恰当的代码训练引入策略有助于提升"LLM 作为智能体"的能力。基于高质量数据(例如由 gpt-4 生成的数据)的对齐训练也有助于改进 LLM 智能体。概括而言,我们的贡献如下:
• 我们提出将 LLM 作为智能体进行评测的概念,并给出 AgentBench——一个用于标准化该评测的综合性基准。它基于真实场景定义了 3 大类共 8 个不同的环境,为 LLM 的广泛能力提供了实用的试验台。
• 我们使用 AgentBench 对 29 个不同 LLM 进行了彻底评测,揭示了领先 API 商业模型与许多参数量不超过 70B 的开源模型之间的显著性能差距。我们还定量分析了现有 LLM 智能体失败的原因,并指出改进方向,例如改进指令遵循、提升对齐数据质量等。此外,我们表明代码训练可能是一把双刃剑:它改善部分智能体任务,却损害另一些任务。
• 为促进"LLM 作为智能体"评测,我们推出了一个基于服务器-客户端(Server-Client)架构的一体化工具包,遵循模块化与可扩展的设计原则。这使得任何 LLM 都可以便捷地通过 HTTP 协议完成自定义模型评测。配合配套的数据集与环境,该工具包现已向更广泛的研究社区开放。
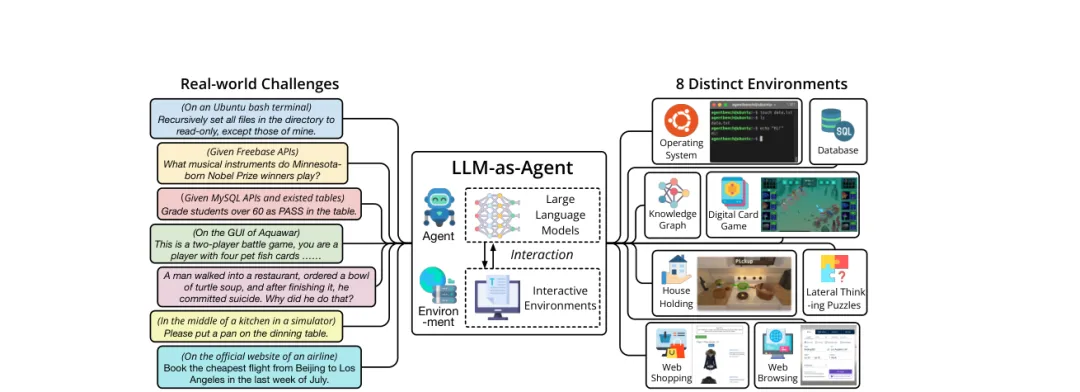
图 2:AgentBench 是首个在广泛现实挑战与 8 个不同环境上系统评测"LLM 作为智能体"的基准。本版共测试了 29 个 LLM。左侧为现实挑战示例(操作系统终端指令、Freebase API 问答、MySQL 表操作、Aquawar 游戏对局、海龟汤谜题、模拟厨房家务、订机票等),右侧为 8 个环境:操作系统、数据库、知识图谱、数字卡牌游戏、横向思维谜题、家务、网络购物、网页浏览。
2 LLM 作为智能体:定义与预备知识
本节我们对"评测 LLM 作为智能体"的相关术语进行形式化,并给出在智能体评测语境下使用 LLM 所需的预备知识。
定义:LLM 作为智能体的交互式评测。 "LLM 作为智能体"的交互式评测可以视为一个部分可观测马尔可夫决策过程 (S, A, T, R, U, O),包含状态空间 S、动作空间 A、转移函数 T : S × A → S、奖励赋予函数 R、任务指令空间 U 与观测空间 O。我们将 LLM 智能体记作 M。
思维链(Chain-of-Thought, CoT)与其他推理策略。 由于"LLM 作为智能体"要求 LLM 具备较强的推理能力,CoT(Wei et al., 2022b)——在相关评测中与动作结合使用已成为事实上的策略(Yao et al., 2023b)——也被 AgentBench 采用。尽管后续提出了许多改进策略,如引入集成(Wang et al., 2023c)、反思(Shinn et al., 2023)与搜索(Yao et al., 2023a),我们在 AgentBench 中使用最原始的 CoT 来评测 LLM。它不需要多次尝试、重复生成或复杂策略,是人们部署 LLM 智能体最简单、最廉价、最常见的方式。
结束原因(Finish Reasons)的典型类型。 尽管 LLM 能力不俗,我们在 AgentBench 中表明,即使最强的 gpt-4 也不够格成为一名实际可用的智能体。我们将 LLM 智能体在 AgentBench 任务上的结束原因识别并归纳为五种典型类型:
•上下文超限(Context Limit Exceeded, CLE):交互历史的长度超出 LLM 的最大上下文长度(仅发生在上下文长度为 2,048 的 text-davinci-002 与 text-davinci-003 上)。
•无效格式(Invalid Format, IF):智能体未遵循格式指令。
•无效动作(Invalid Action, IA):智能体遵循了格式指令,但其选择的动作无效。
•任务轮数超限(Task Limit Exceeded, TLE):智能体在达到预设最大交互轮数后仍未解决问题,或连续多轮开始重复生成。
•完成(Complete):任务正常结束。
其中 IF 与 IA 多由 LLM 糟糕的指令遵循能力导致,TLE 则往往表明模型在特定任务上多轮能力薄弱。
3 AgentBench 的构成:概览
本节简要介绍构成 AgentBench 的数据集与环境。与以往的智能体评测基准(Côté et al., 2019; Fan et al., 2022)相比,AgentBench 聚焦于通过思维链(CoT)(Wei et al., 2022b; Yao et al., 2023b)提示对 LLM 进行实用评测,涵盖代码落地、游戏落地与网络落地三类场景。它们为 LLM 在自主任务完成方面的应用指明了有前景的方向,其多样性也避免了面向特定任务的模型(如代码专用 LLM)在 AgentBench 上"偏科式"的过强表现。限于篇幅,构建、评测与提示示例的细节请参见附录。
3.1 代码落地环境
由于 LLM 能够生成高质量代码(Chen et al., 2021),LLM 智能体一个非常实用的使命就是辅助人类与计算机界面进行交互。这里我们介绍三个依赖编码与推理能力的环境,作为 AgentBench 中的代表。
操作系统(Operating System, OS)。 让 LLM 在终端中访问并操控操作系统是一个迷人但富有挑战性的使命。尽管已有将自然语言翻译为 Shell 命令的尝试(Lin et al., 2018),此前很少有工作在可执行环境中评测模型。我们的目标是在真实的交互式 bash 环境(即 Ubuntu Docker(Merkel et al., 2014)容器)中,就具有确定性答案的人类问题(例如:操作系统中非 /home 目录的用户数量),或面向实际目标的一系列操作(例如:递归地将所有目录文件设为只读、但排除我的文件)来评测 LLM。我们采用成功率(Success Rate, SR)作为评测指标。(更多细节参见附录 B)
数据库(Database, DB)。 数据库分析在许多日常事务中至关重要但也颇为困难,因此考察 LLM 通过 SQL 操作真实数据库的能力十分必要。以往研究极大侧重于单个环节,例如 SQL 与自然语言之间的翻译(Zhong et al., 2017; Gao et al., 2023; Pourreza & Rafiei, 2023; Ruan et al., 2023),或基于单个小表回答问题(Nan et al., 2021; Iyyer et al., 2017),很少有工作把完整流程作为整体来评测模型。因此,AgentBench 在真实世界场景中的真实 SQL 接口、数据库与不同类型的查询上评测 LLM。我们采用成功率(SR)作为主要评测指标。(更多细节参见附录 C)
知识图谱(Knowledge Graph, KG)(Anonymous, 2023)。 与当代知识图谱交互——它们往往规模巨大(例如 FREEBASE(Bollacker et al., 2008)拥有超过 4,500 万实体与 30 亿事实)——要求智能体具备广泛技能(Gu et al., 2023)。在这类部分可观测的环境中运作,要求智能体在不完整信息下决策,并运用多种技能管理固有的不确定性,包括语言理解(例如错综复杂的语义细节)、规划(例如把指令拆解为更易管理的子组件)与工具使用(例如与 KG 接口交互)。因此,我们提出把 KG 作为评估 AI 智能体决策能力的代表性试验场。我们采用问答作为基本任务形式,相应地以答案 F1 作为指标。(更多细节参见附录 D)
3.2 游戏落地环境
玩游戏通常需要设计策略、遵循指令与推理方面的强能力。与代码落地任务不同,游戏落地环境中的任务不要求编码专业知识,而是更要求对常识与世界知识的综合理解。
数字卡牌游戏(Digital Card Game, DCG)。 游戏通常可作为智能体开发的模拟环境,而 DCG(例如 Hearthstone(Hoover et al., 2020))是纯文本 LLM 的理想选项。它通常包含大量卡牌文本描述,需要深思熟虑的出牌策略才能取胜,考验模型对游戏规则、操作逻辑的理解,以及基于当前局势形成策略决策的能力。在 AgentBench 中,我们采用 2021 年清华大学智能体大赛(THUAC)的简化版 DCG 系统 Aquawar 来评测 LLM 作为智能体的能力。在 Aquawar 中,智能体扮演一名玩家,操控一队拥有不同天赋的鱼,以回合制形式与另一支算法队伍对战。我们报告 LLM 的胜率作为评测指标。(更多细节参见附录 E)
横向思维谜题(Lateral Thinking Puzzles, LTP)。 横向思维谜题(Sloane, 1992; De Bono, 1970),又称情境谜题或"海龟汤",是全球流行的团体游戏,推动参与者从非常规视角解开谜题。典型玩法是:一人主持,其他人通过策略性提问来猜出谜底,回答仅限于"是""否"或"无关"。在该数据集中,我们首先搭建了一个用于自动判定的 LTP 主持系统;然后收集了多样化的、难度各异的网络谜题,并把情节简化为若干要点(即游戏进度)。通过这一评测,我们希望洞察 LLM 横向推理能力的深度与敏捷度。(更多细节参见附录 F)
家务(House Holding, HH,ALFWorld(Shridhar et al., 2020b))。 以家务为代表的具身游戏环境对常识落地要求很高,此前已被很好地用于语言智能体评测(Côté et al., 2019)。在 AgentBench 中,我们在经典 ALFWorld(Shridhar et al., 2020b)上评测模型在物理家务环境中完成任务的能力,该环境源自久经考验的文本游戏工具包 TextWorld(Côté et al., 2019)。智能体需要完成"把平底锅放到餐桌上"之类的家务任务。我们采用成功率(SR)作为评测指标。(更多细节参见附录 G)
3.3 网络落地环境
网页是人们在现实世界中交互的主要界面。因此,评测 LLM 智能体在复杂网络环境中的行为对未来发展至关重要且颇有价值。这里我们改编两个已有的网页浏览数据集,用于对 LLM 进行实用评测。
网络购物(Web Shopping, WS,WebShop(Yao et al., 2022))。 网上购物是现代生活中非常实用且重要的一部分。其轨迹——在真实电商网站上搜索、浏览并挑选心仪商品——要求自主智能体具备较强的推理与决策能力。Webshop(Yao et al., 2022)是一个模拟网上购物环境,正是为评测语言智能体而生。虽然它最初用于评测专门训练过的模型,我们提出仅用提示(prompting)来评测 LLM。(更多细节参见附录 H)
网页浏览(Web Browsing, WB,Mind2Web(Deng et al., 2023))。 通用网页环境是训练与评测智能体的理想沙箱。Mind2Web(Deng et al., 2023)是最新发布的通用基准,用于开发与评测能够在给定高层用户指令时、跨各类网站领域执行复杂任务的网页智能体。它为网站交互设计了可行的动作,如点击、选择与输入,从而支持对 LLM 作为网页智能体的整体评测。与 Mind2Web 原始设定相比,我们做了改编,使其无需额外微调即可评测提示驱动的 LLM。(更多细节参见附录 I)
4 AgentBench 评测
我们大规模评测了 29 个 LLM(包括 API 商业模型与开源 LLM),以形成对"LLM 作为智能体"现有表现的系统认识。我们还设计并发布了一个简单的即插即用评测工具包,以促进相关"LLM 作为智能体"研究。
4.1 评测设置
数据集统计。 我们在表 2 中报告了 AgentBench 数据集的统计信息。为简洁起见,下文使用各数据集的缩写。所有数据集都是实用的多轮交互挑战,单个问题的预估解决轮数从 5 到 50 轮不等。每个数据集提供两个切分:Dev(开发)与 Test(测试)。所有数据集均公开可得。我们在 AgentBench 设计中还仔细权衡了评测的全面性与效率,因为 LLM 的多轮交互可能非常耗时。我们将 Dev 与 Test 的规模分别设为 269 与 1,014 个问题,对应约 3k 与 11k 次推理调用,与 MMLU(Hendrycks et al., 2021b)所需的推理调用量大致相当。
被评测的 LLM。 作为对现有 LLM 在"LLM 作为智能体"上系统基准测试的尝试,我们共纳入 29 个模型,大致可分为两类:
•API 商业 LLM:主要由未公开参数量的 LLM API 组成(参见表 1)。由于投入更多,其性能通常更好。
•开源(OSS)LLM:多来自学术界与部分公司(参见表 1)。受计算资源所限,我们只纳入小于 70B 的开源 LLM。值得注意的是,这一量级已经涵盖了绝大多数表现出色、并针对对话或指令相关任务做过专门微调的开源 LLM(极少数除外)。
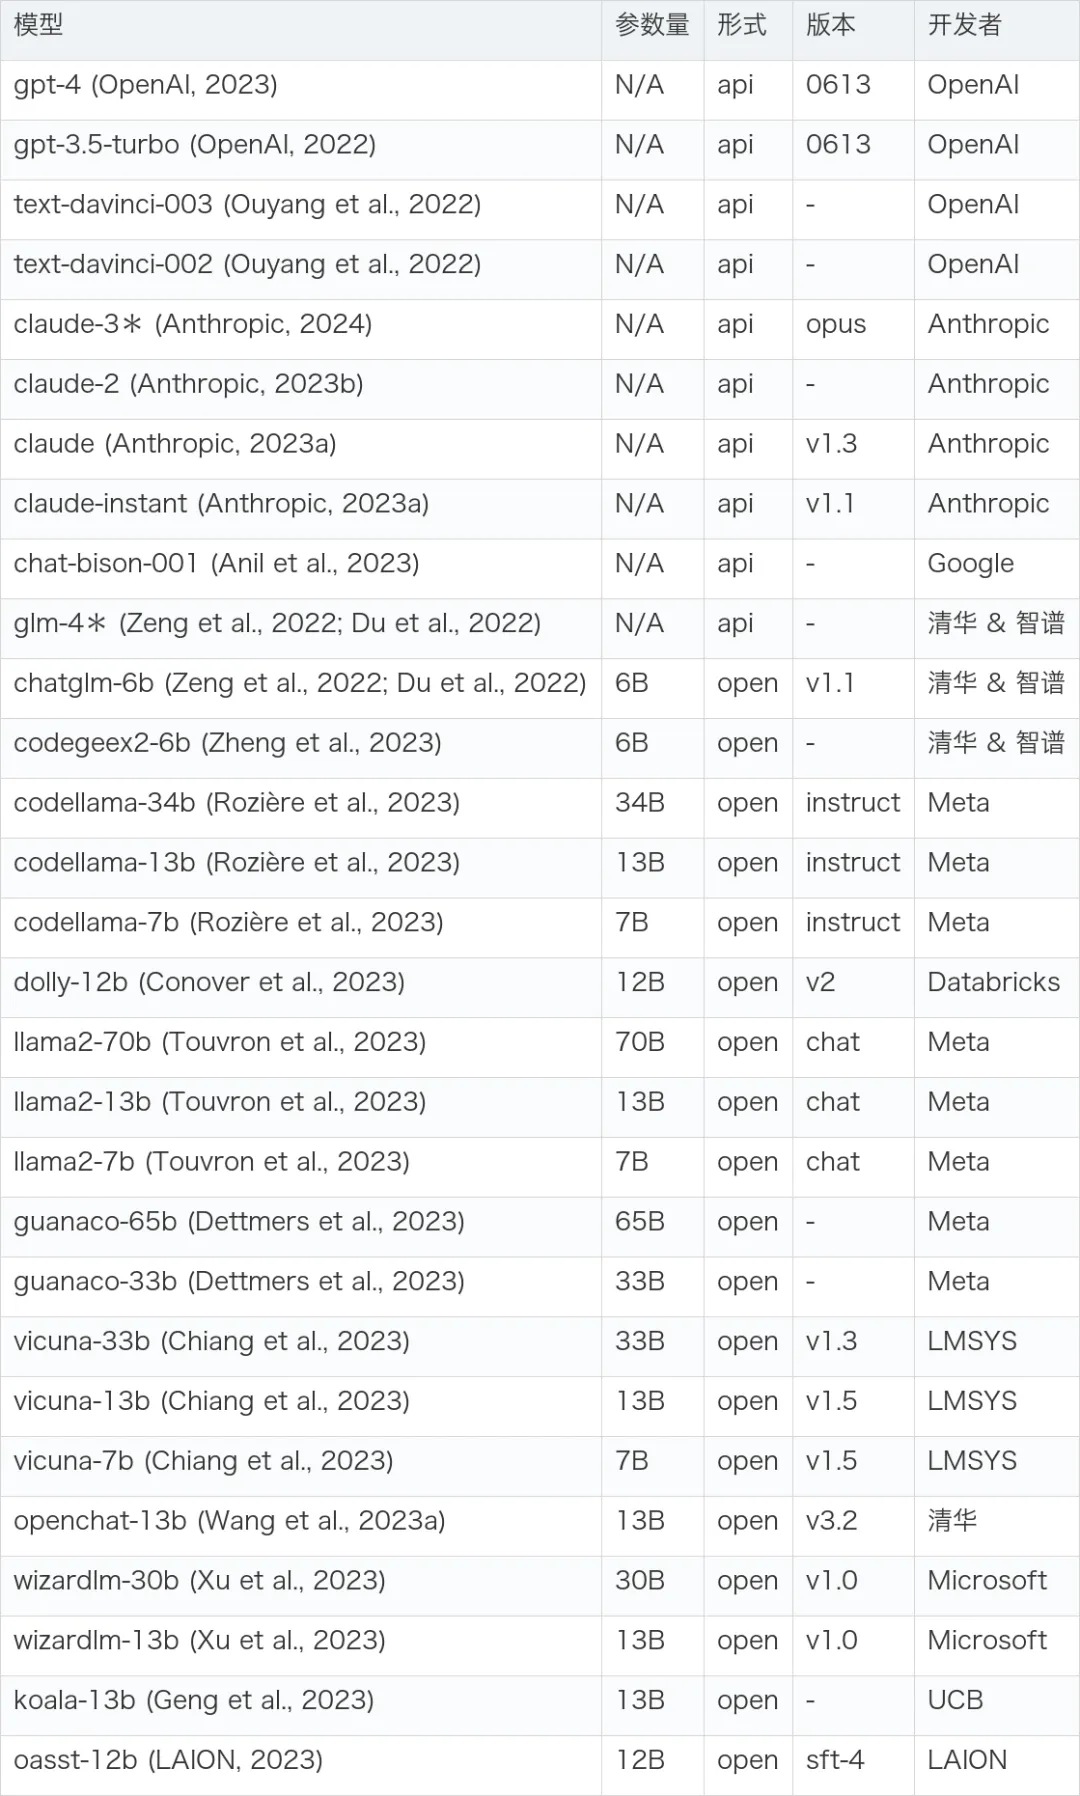
表 1:AgentBench 在"LLM 作为智能体"挑战上评测的 29 个 API 或开源(OSS)LLM。标注*的模型在任务权重计算之后进行评测。
译注:原表为左右两栏排版,此处按左栏在前、右栏在后合并为一表,共 29 个模型。guanaco-65b 与 guanaco-33b 两行的开发者列原文印作"Meta",应为原表之误——guanaco 出自 Dettmers et al.(2023,华盛顿大学),照原文译出并在此说明。
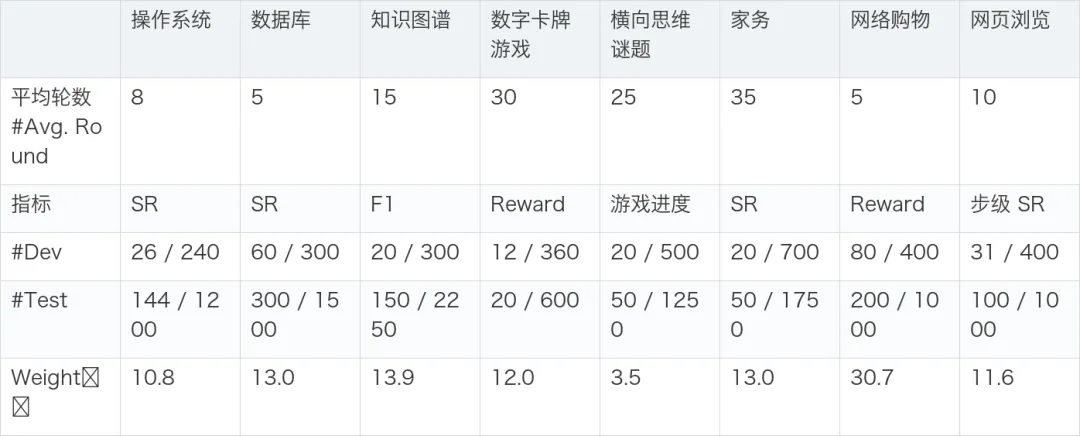
表 2:AgentBench 评测中 8 个环境的统计信息与指标。"SR"表示成功率;"#Avg. Round"表示解决单个问题的预估交互轮数;"#Dev"与"#Test"给出查询样本数 / 总预期交互轮数;"Weight⁻¹"指该任务在本次评测中所有模型上的平均分数的倒数(详见 4.1 节与附录 B 至 I)。
工具包:以 API 为中心与环境隔离的精简评测。 随着 LLM 系统复杂度持续提升且主要通过 API 访问,我们开发了一个契合 API 导向理念的评测工具包。该工具包为与 API 交互而精心设计,简化了适配与测试不同 LLM 的流程。有意在 AgentBench 上评测自己 LLM 的研究者,只需部署一个可通过 HTTP 协议访问的模型服务器。
此外,应对多样而复杂的交互环境本身就是重大挑战,统一配置所有环境可能极其繁琐且易产生冲突。为此我们实施了两个关键策略:其一,我们将具有复杂环境的任务封装进 Docker 容器镜像,研究者只需挂载代码路径即可轻松启动评测;其二,我们把每个任务细分为独立的 worker,确保各任务的环境相互隔离、互不冲突。(更多细节参见附录 A。)
评测提示设置。 为兼容大多数现有对话模型,我们的对话范式围绕两个角色构建——用户(即指令与环境反馈)与智能体——二者交替互动。我们把交互轨迹记录为对话历史 (u₀, a₀, …, uₖ, aₖ),其中 uᵢ、aᵢ 表示第 i 轮的用户与智能体内容。推理时,对话历史应遵循 (u₀, a₀, …, uₖ) 的格式。我们选择最小的 r,使得 (u₀, aᵣ, uᵣ₊₁, …, uₖ) 中所有 token² 数目不超过 3500;然后在 u₀ 中追加"[NOTICE] 2r messages are omitted."([提示] 省略了 2r 条消息)。之后,序列 (u₀, aᵣ, uᵣ₊₁, …, uₖ) 就作为多轮对话格式的最终输入。
² 由于各模型的分词器不同,我们简单按如下方式计算 token:长度为 n 的单词占 ⌈n/6⌉ 个 token,一个非空白字符占 1 个 token。
然而,为了兼容非对话模型,我们追加了后处理器。对支持多轮的对话模型,我们把历史直接喂给模型;对仅支持文本补全的模型(如 text-davinci-003),我们在历史的每条内容前加上"USER:"或"AGENT:",最后追加字符串"AGENT:"让模型生成智能体的内容。
在任务提示组织上,我们改编自(Yao et al., 2023b)的格式,在同一轮中同时包含"Thought"(CoT)与"Action"。通常在任务指令中提供一个简单的 CoT 示例,以获得更好的输出格式。为确保结果可复现,遵循(Wei et al., 2022b),所有任务推理均设 temperature=0(即贪心解码)。
总分计算。 我们观察到,由于任务难度不同,各任务的分数分布差异显著。因此,朴素平均分会被普遍高分的任务(据我们观察,如网络购物)严重拉高,淹没低分任务,不适合 AgentBench 的目的。于是我们这样产生总分:先把每个任务在所有被测模型上的平均分归一化到 1,再对每个模型跨任务取平均(参见表 2)。为标准化并简化未来研究的分数计算,我们用所有被测 LLM 在每个任务上的平均分的倒数作为固定权重,用于未来的总分计算。总分即每个任务分数乘以相应权重后的平均值。该方法确保评测的公平与一致,便于未来研究的比较与分析。
4.2 主要结果
AgentBench 的总分与分数据集得分报告于表 3。令人惊喜的是,在这个富有挑战性的基准上,我们发现一些顶级 LLM 已具备应对真实环境交互的扎实能力。例如,gpt-4 在 8 个数据集中的 6 个上表现最佳;在家务(House Holding)上成功率达 78%,表明其在该场景下的实际可用性。claude-2 与 claude 紧随 gpt-4,但明显优于 gpt-3.5-turbo。尽管其他 API 模型表现相对较差,但无论何种任务,它们大多能解决相当比例的问题。所有 API 模型的 AgentBench 总分均在 1.00 以上。
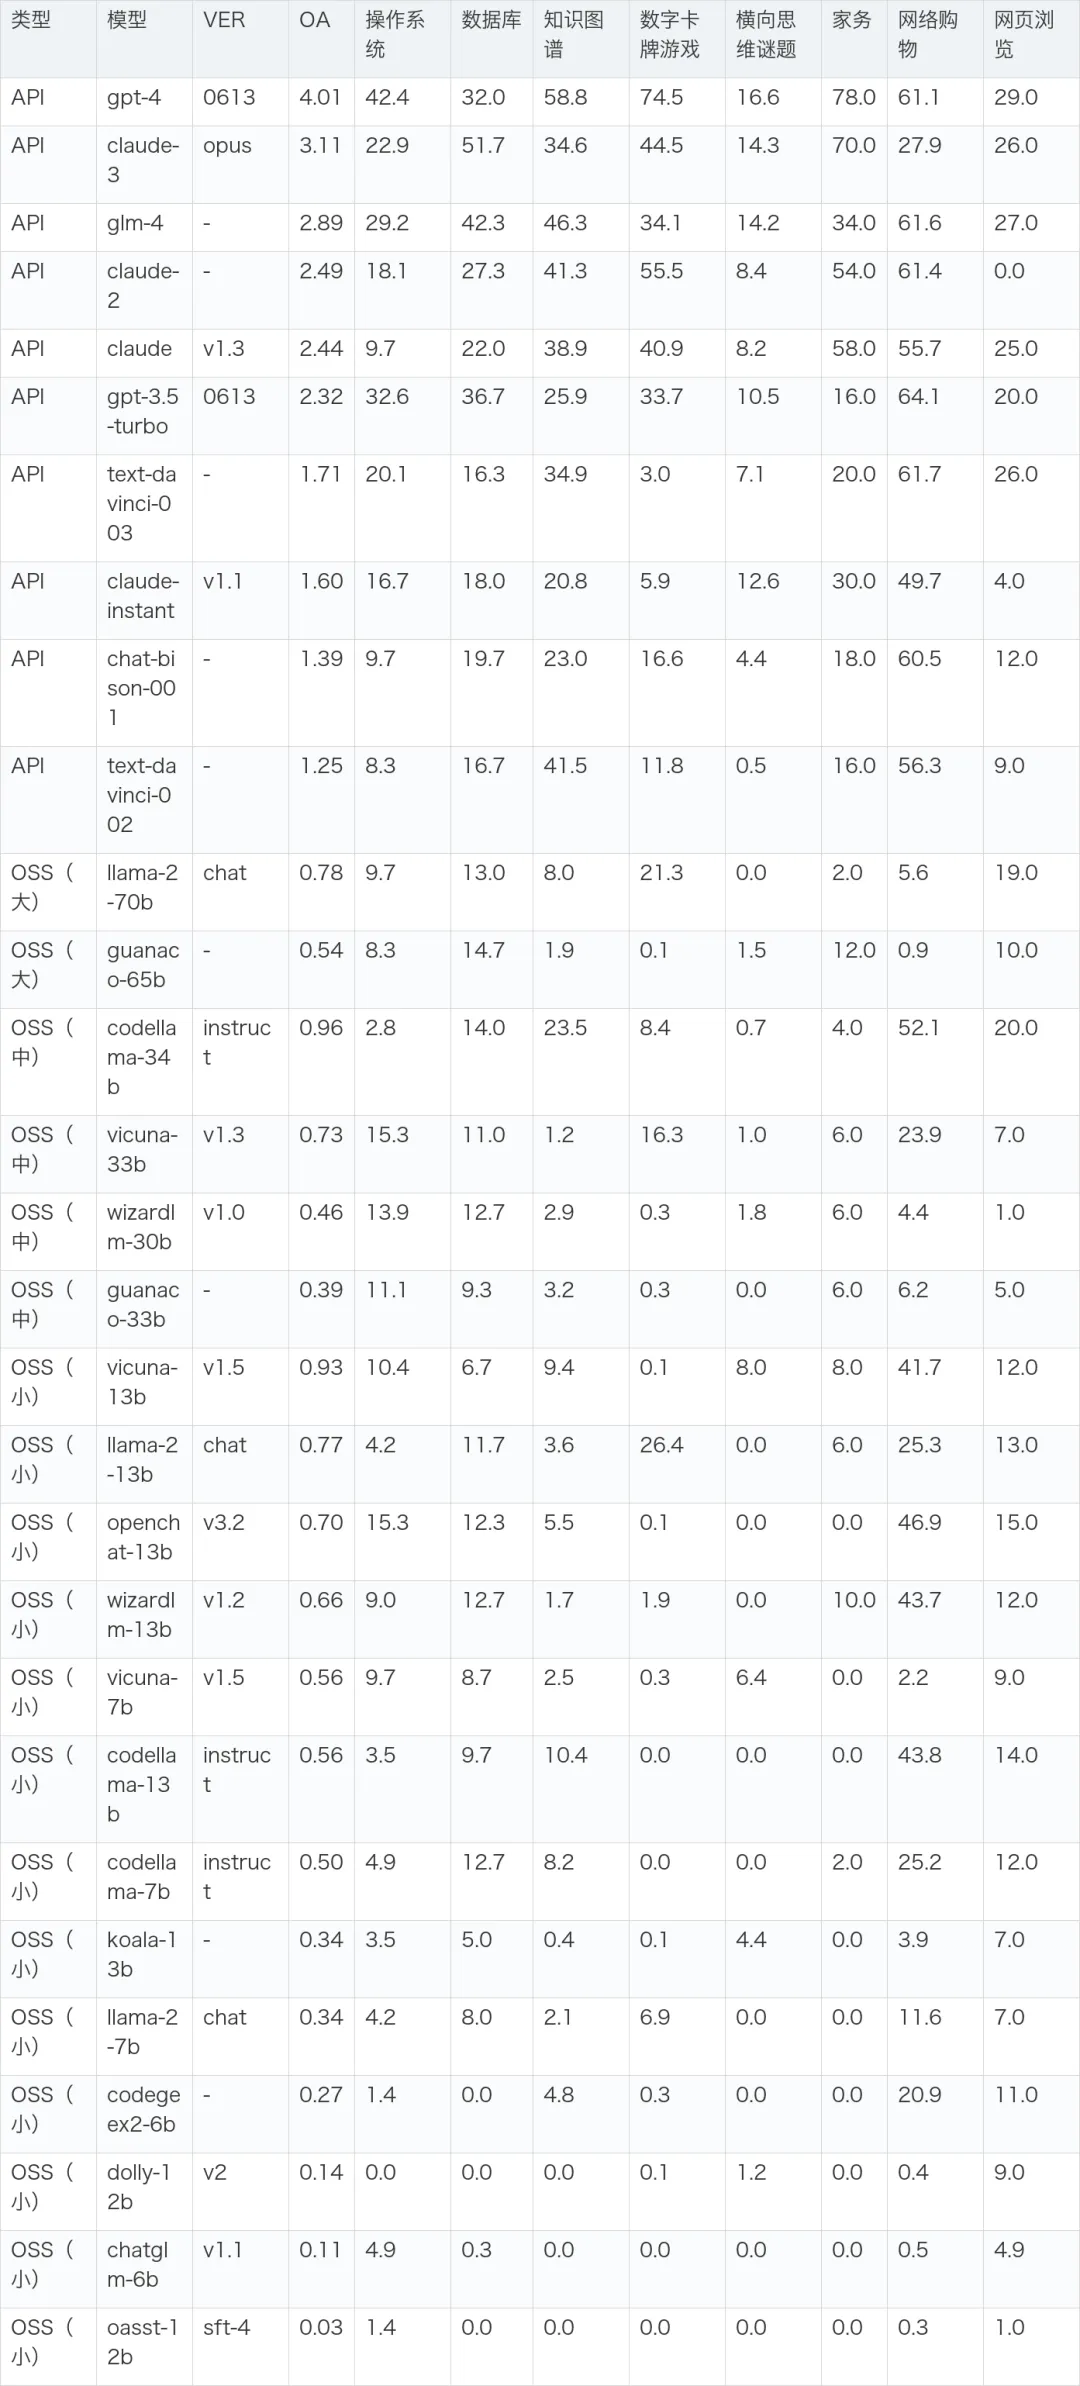
表 3:AgentBench 测试集(标准)结果。顶级商业 LLM(如 gpt-4)与开源 LLM 竞争者之间存在明显性能差距。"VER"表示模型版本;"OA"表示 AgentBench 总分,即所有环境的加权平均(参见 4.1 节)。
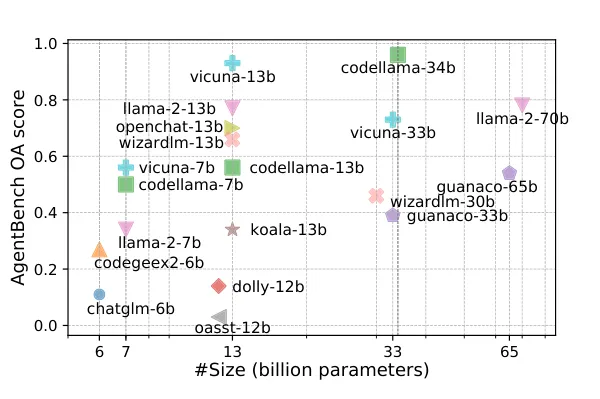
图 3:所有被测开源(OSS)LLM 的 AgentBench OA 总分(按参数规模 6B–70B 绘制的散点图)。多数开源模型的总分远低于 API 模型;最强的开源模型 codellama-34b 为 0.96 分。
然而,我们测试的开源 LLM 普遍无法在一些富有挑战性的任务(如知识图谱、数字卡牌游戏与家务)中解决问题。我们将其性能相对其规模绘制于图 3。总体而言,多数开源 LLM 在 AgentBench 上的表现远逊于 API 模型(平均 0.51 对 2.32)。评测范围内最强的开源 LLM(≤70B)是 codellama-34b,总分 0.96,但与 gpt-3.5-turbo 仍有明显差距。我们的社区仍需付出大量努力才能产出更强的开源 LLM。
4.3 分析
在评测中,我们分析了影响 LLM 智能体在 AgentBench 上表现的若干重要因素,包括结果占比分析、代码训练,以及 API 商业模型与开源竞争者之间的差异。关于规划、自我纠错与工具使用能力的更多洞见与案例研究见附录 J.2。
不同类型执行结果的占比。 表 4 报告了执行结果(参见第 2 节)的占比。AgentBench 任务中最主要的失败原因是任务轮数超限(TLE),揭示出 LLM 推理与决策能力的薄弱。这些数据印证了现有 LLM 的弱点,并可能为未来开发提供指引(请参考我们的框架)。在数据库与数字卡牌游戏任务中,由于格式要求严苛,无效格式(IF)错误频发(参见附录 J.2.1)。相反,家务与网页浏览任务常因 LLM 生成了超出预定义动作空间的动作而出现无效动作(IA)错误。更详细的比例请参见附录 J.1。
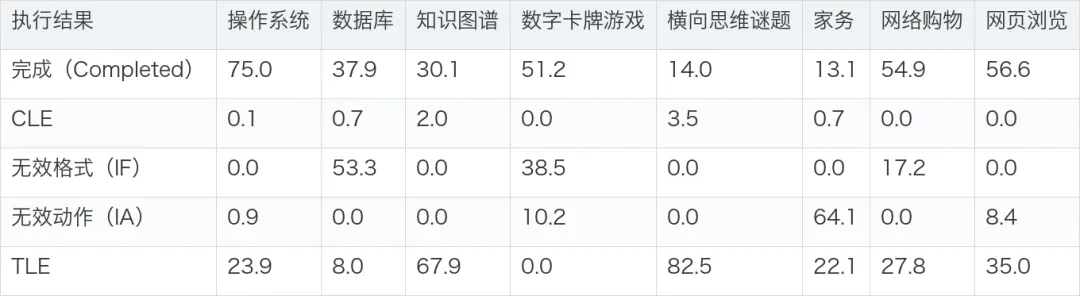
表 4:8 个任务上不同类型执行结果的占比(对所有模型取平均)。(CLE:上下文超限;TLE:任务轮数超限)
代码训练的矛盾影响。 我们发现代码微调可能深刻影响模型的推理生成与思考方式,甚至超出纯编码话题。对比 codellama 与 llama-2 系列,用代码调优似乎让模型在遵循相对固定流程的任务(如网络购物)中占优;但这种调优也可能损害模型的通用思考能力——codellama 系列在数字卡牌游戏上不如 llama-2 系列,在与 Linux 系统交互(比写 bash 代码更重要)的操作系统任务上同样如此。这指出了微调 LLM 时"擅长遵循流程"与"擅长通用思考"之间的权衡。
高质量对齐数据训练的影响。 另一个有益的比较是 vicuna-13b 与 llama-2-13b。二者共享同一基座 LLM,vicuna-13b 用 ShareGPT 数据(由 gpt-4 与 gpt-3.5-turbo 生成、用户分享)做对齐,而 llama-2-13b 从头做对齐。结果 vicuna-13b 在 AgentBench 上胜过 llama-2-13b,甚至与三倍于其规模的 codellama-34b 相当。这表明高质量对齐仍是开发更好 LLM 智能体的关键。
llama-2-13b 与 llama-2-70b 意外相近的表现。 实验中我们惊讶地发现,尽管规模差距巨大,llama-2-13b 与 llama-2-70b 表现相近。仔细核查并重跑实验后结果不变。我们认为这表明 llama-2-70b 的预训练不充分:虽然 llama-2-13b 与 llama-2-70b 都用 2T token 预训练,但按缩放律(Hoffmann et al., 2022),更大的 LLM 应该用更多 token 训练。另一个潜在原因可能是 llama-2-70b 在指令遵循上的对齐不足,导致其遵循指令的能力相对滞后(参见附录 J.2.5)。
5 相关工作
LLM 评测。 自监督(Liu et al., 2021)LLM(Brown et al., 2020; Chowdhery et al., 2022; Zhang et al., 2022; Scao et al., 2022; Zeng et al., 2022; Touvron et al., 2023),尤其是对话对齐的 LLM(Ouyang et al., 2022; Anthropic, 2023a; OpenAI, 2023)的通用能力,刷新了人们对深度学习系统的印象,并极大超越了传统 NLP 评测的范畴。这使得 LLM 评测成为一个紧迫而富有挑战的问题。与以往聚焦特定任务子集的工作(Wang et al., 2019; Wang et al.; Gehrmann et al., 2021)相比,越来越多的基准在评测中纳入更广泛的任务与数据集(Hendrycks et al., 2021b; Liang et al., 2022; Srivastava et al., 2023)。然而,它们大多仍局限于传统任务,无法评测 LLM 的开放式生成、多轮交互与作为智能体的能力。
LLM 作为智能体。 在前 LLM 时代,TextWorld(Côté et al., 2019)、Jericho(Hausknecht et al., 2020)与 LIGHT(Urbanek et al., 2019)等文本游戏环境在基于 BERT(Devlin et al., 2019)与强化学习的语言智能体研究中占据主导。随着 LLM 出现,LLM 智能体研究开始蓬勃兴起(Huang et al., 2022),尤其是在思维链(Wei et al., 2022b)问世之后。ReAct(Yao et al., 2023b)是在智能体任务中结合 CoT 推理与动作的开创性工作。此后,大量先进推理策略(Kim et al., 2023; Shinn et al., 2023; Wang et al., 2023d; Liu et al., 2023; Yao et al., 2023a; Gu et al., 2023)以及面向"LLM 作为智能体"的应用——包括框架(Richards, 2023; Nakajima, 2023; age, 2023)与多智能体系统(Park et al., 2023; Hong et al., 2023; Wu et al., 2023)——纷纷涌现,引发广泛关注。然而,该主题可用的数据集与模型仍然有限,缺乏一个标准且全面的基准。AgentBench 给出了首个覆盖广泛任务与可用 LLM 的"LLM 作为智能体"系统性基准;此外,它还开创了用智能体任务来度量 LLM 性能的思路。
在执行环境中评测 LLM。 随着 LLM 越来越能应对现实挑战,用执行环境而非静态数据集来评测它们成为一种趋势。除文本游戏(如 ALFWorld(Shridhar et al., 2020b))外,另一主流方向是代码执行。APPS(Hendrycks et al., 2021a)、HumanEval(Chen et al., 2021)与 MBPP(Austin et al., 2021)开创了以功能正确性而非文本相似性评测代码 LLM 的先河。该范式随后被广泛认可并采纳于后续工作(Li et al., 2022b; Zheng et al., 2023; Nijkamp et al., 2023)。然而,此前的代码评测框架鲜有考虑多轮交互。同期工作 InterCode(Yang et al., 2023)发布了一个支持模型与 Bash、SQL 环境交互评测的框架,与 AgentBench 的 OS、DB 任务相似。
6 结论
我们提出 AgentBench——一个系统化设计、多维度、持续演进的"LLM 作为智能体"评测基准,首次覆盖多达 29 个 LLM,并建立了统一的测试框架与敏捷评测工具包。基于该评测,我们就智能体任务、LLM 行为以及改进 LLM 在 AgentBench 上表现的潜在方法给出了多方面的洞见。我们期待 AgentBench 成为后续 LLM 智能体研究的基石。
致谢
我们感谢匿名审稿人与 Shunyu Yao 对完善本工作的建议,感谢智谱 AI 承担本研究消耗的全部 GPU 与 API 费用。Yuxiao Dong 受国家自然科学基金(NSFC)62276148 支持。唐杰受国家科技部科技创新 2030 重大项目 2022ZD0118600、国家杰出青年科学基金 61825602、清华大学基础科学研究项目 20233080067 以及新基石科学基金会"探索者奖"的支持。本工作还受智谱 AI 研究基金支持。
参考阅读:
翼络智能体实验室
联系人:零点壹,微信号:punkt1
