ICML 2026 | 时序推理评测新标杆TSRBench!首次统一感知、推理、预测、决策四大能力
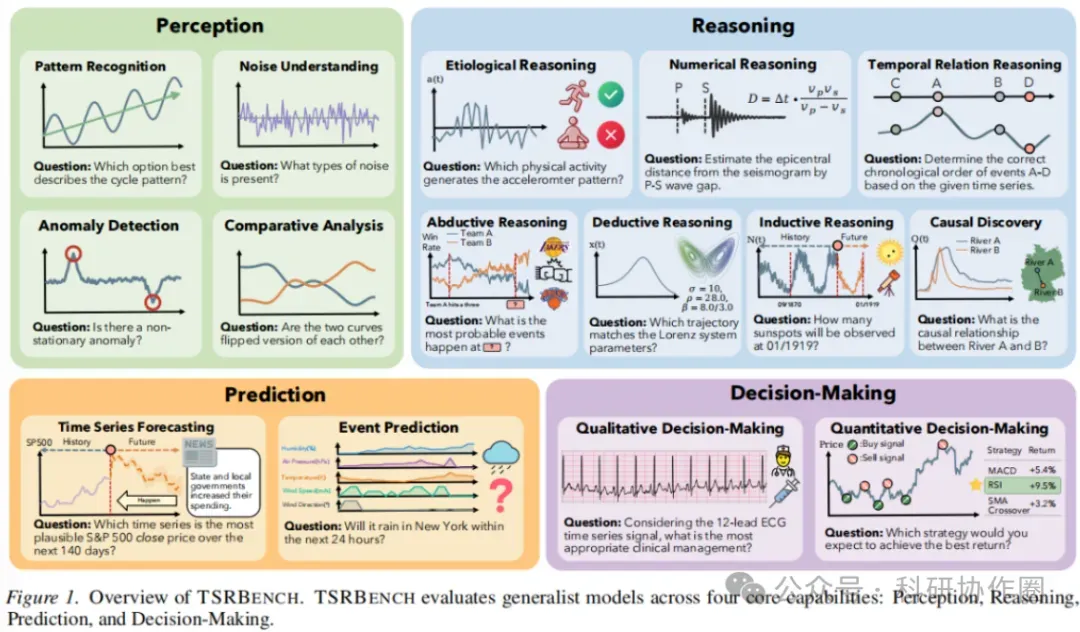
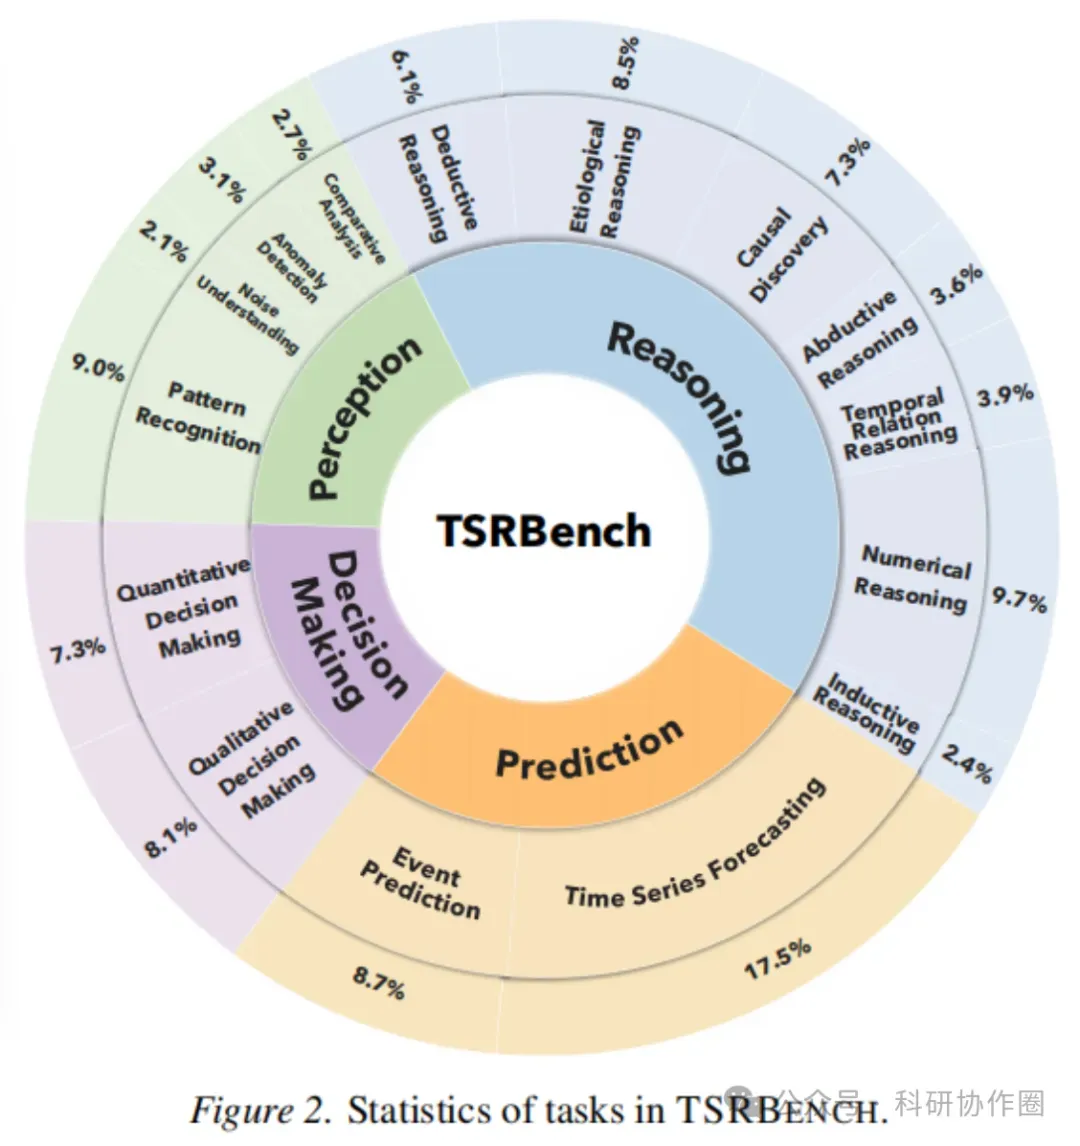
研梦非凡CCF地址:https://www.yanmengfeifan.com/shymkj/ccf时间序列数据无处不在,金融波动、医疗监护、电网负载、交通流量……所有高风险领域的决策都离不开它。但对通用模型来说,能“看懂”并“分析”时序数据,一直是块难啃的骨头。现有的评估基准要么只盯着传统数值预测,把数据当孤立数字;要么只覆盖少数领域,根本测不出模型真实的推理水平。针对这一痛点,研究团队耗时半年,推出了全新基准TSRBench。它包含14个领域、4125个问题,覆盖从基础感知到高阶决策的全能力链条,支持文本、图像、图文交错等四种输入模态,能公平评估大语言模型、视觉语言模型等不同类型的通用模型。四大能力维度,还原人类分析逻辑
TSRBench没有简单堆砌任务,而是按人类处理时序问题的逻辑,拆解成四大核心维度:- 时序推理:突破传统数值计算,包含溯因推理、因果发现等7个任务,考察模型能否像人一样提炼逻辑关系。
- 时序预测:包含数值和事件预测,采用多项选择形式,公平测试预测逻辑。
- 时序决策:分定性/定量决策,贴近现实场景(如电网调度、医疗方案选择)。
测试30+模型,得出四大关键发现
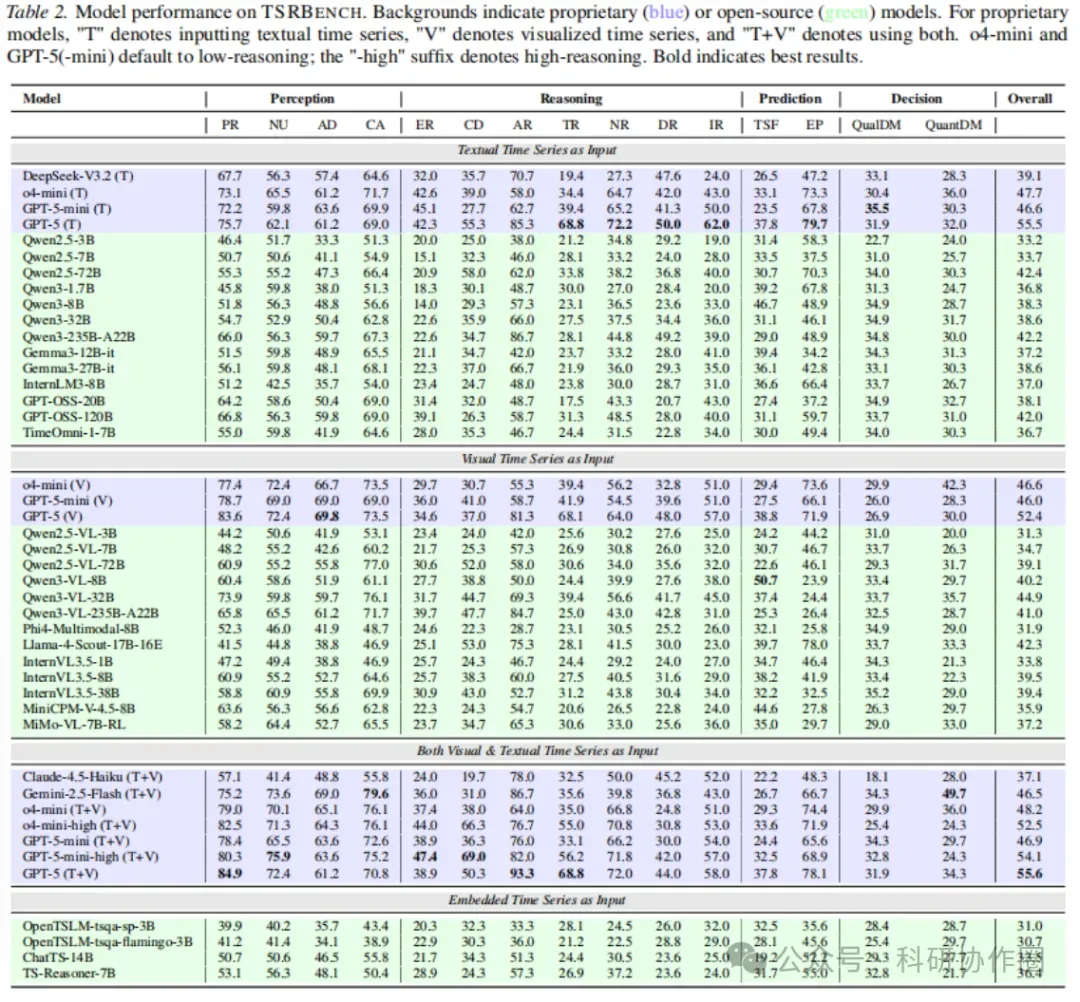
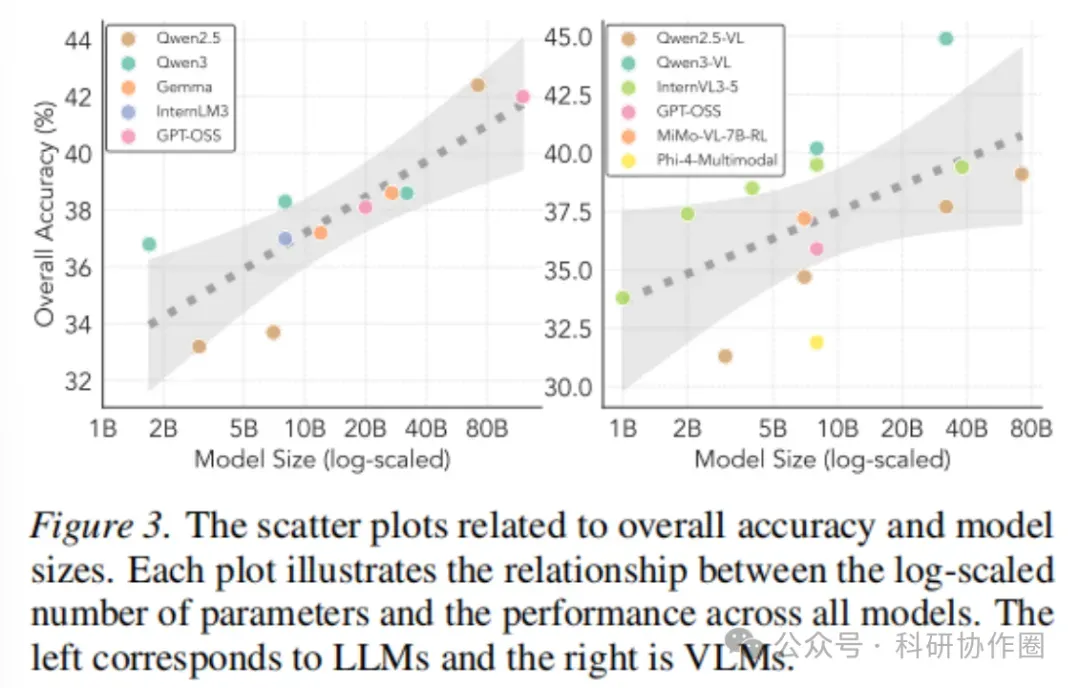
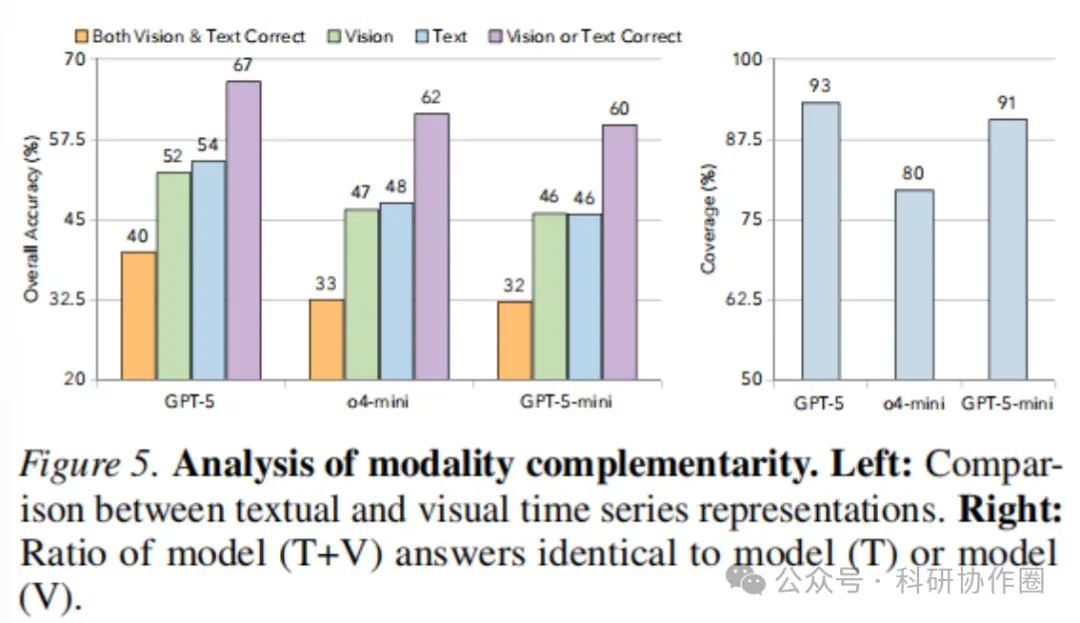
研究团队评估了30多个主流模型,包括GPT-5、Qwen3-VL等,得出了几个颠覆认知的结论:发现1:缩放定律在预测任务上失效了。模型越大不代表预测越准,单纯堆参数解决不了时序预测问题。发现2:会推理不代表会预测。感知、推理、决策三者强相关,但它们与预测任务的相关性极弱,预测是独立的短板。发现3:文本和视觉模态互补,但模型不会融合。视觉擅长感知,文本擅长细粒度推理,但双模态输入并未带来预期的性能飞跃。发现4:不同任务的改进方向完全不同。溯因推理等任务可通过知识蒸馏提升,而定量决策、时序预测是所有模型的共同弱点,必须从预训练数据加入更多定量监督信号。私信我回复「时序推理」,即可免费领取全部论文合集及项目代码!无论是发论文找创新点,还是做相关研究,这份资料都能帮你快速定位方向。