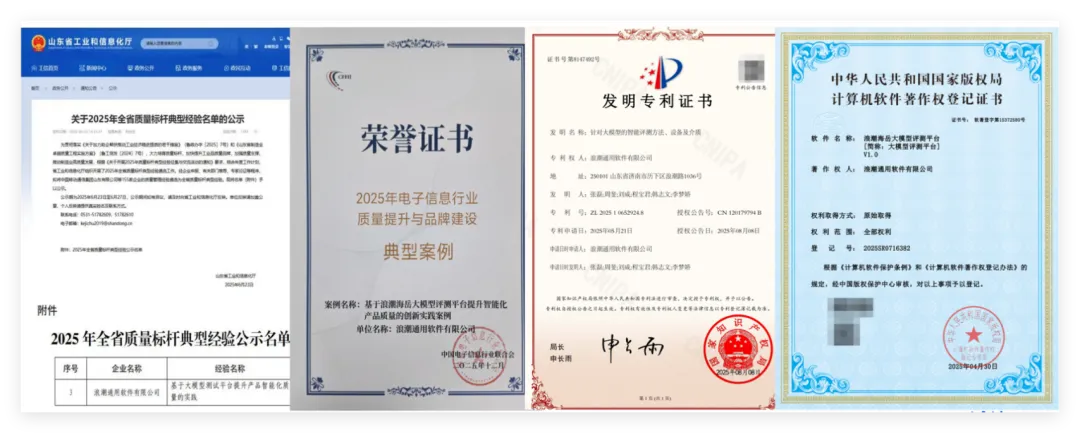
当前,以大模型为代表的生成式人工智能加速落地,顺应这一趋势,浪潮数字企业陆续推出浪潮海岳企业AI、海岳大模型等核心平台产品,引领企业智能应用走向纵深。
新问题也随之而来:传统软件的运行逻辑是确定的,大模型则是基于概率采样生成内容,同一问题多次提问可能得到不同回答,传统测试非“通过”即“失败”的判定模式,难以适配AI产品的质量校验需求。
面对大模型“幻觉”和“不一致性”等质量风险,大模型评测平台团队决定依托公司现有研发体系,按照“定标准—建平台—持续迭代”的思路,一步步构建全新的大模型评测体系。
构建评测体系,首先要回答“评什么”和“怎么评”。因此,定标准是团队要进行的第一步。
当时业内尚无成熟的大模型评测范式可循,团队一方面从业务场景出发反向拆解评测的需求,另一方面主动向外取经,前往先进企业实地调研,了解从模型训练、微调到质量评测的完整流程,同时收集海外大模型评测的方法与思路,边学边试,逐步摸索出可行的路径。
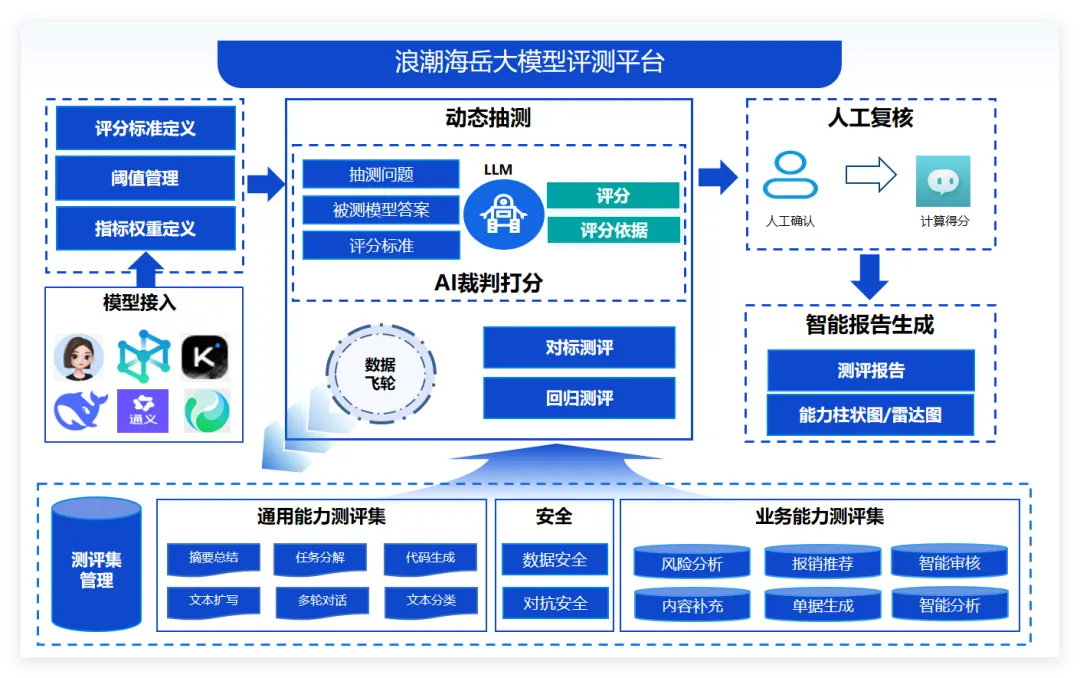
在此基础上,经过多方案对比,团队最终确定了把“评测数据集+评测权重+自动化执行+AI裁判评分”作为核心路径,让评测标准既能覆盖真实业务场景,又能通过平台转化为可重复执行的自动化能力。
在团队看来,功能、性能、安全是大模型评测体系的三大核心方向:功能决定AI产品“能不能用”,性能决定“好不好用”,安全决定“敢不敢用”,三者缺一不可。
研发过程中,团队汲取传统测试的优秀经验,同时针对大模型特性做了关键创新,引入专属方法,用统计思维替代非黑即白的判定逻辑。
有了标准,团队便着手搭建评测平台,将评测标准转化为自动化执行能力,既节省了人力成本,也让评测可重复、可量化、可追溯。
体系落地不是终点,更要能够实现不断迭代,常用常新。团队深度参与IEEE国际标准、国家标准及行业规范编制,编制评测白皮书,持续补齐大模型与智能场景评测能力,形成“标准—平台—迭代”相互驱动的良性循环。