一套 Agent 评测集怎么搭:三件用例、四件制度
- 更新时间 2026-09-30 18:56:29
结合这段时间通过 LangChain 学习的评测知识,以及我在 XSCesLab Agent 里的那轮落地。本篇解决一个问题:一套 Agent 评测集最少要有哪几件东西,哪一件最难,缺了会怎样。素材两处:自己那套数据处理 Agent 的两轮真实跑批,加上一次评测与质量的技术分享会。
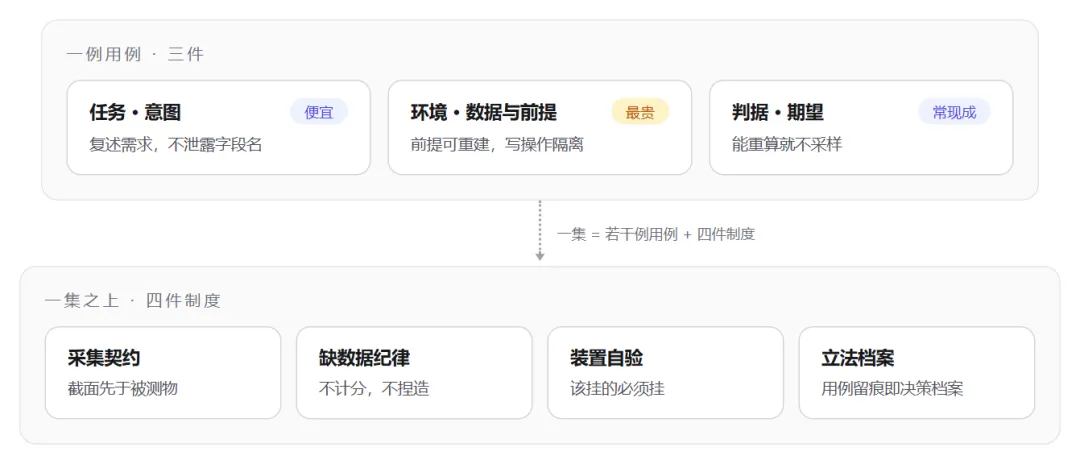
评测集在我这里分两层:一例用例三件(任务、环境、判据);若干例用例合起来是一集,一集之上再压四件制度。这两层就是下面这张图。哪一件最难、缺了会怎样,放在我走过的顺序里说。
尺子为什么变重了
一开始我对评测的理解很窄:跑一批用例,看对了几条,跟「跑通没跑通」差不多。变重是两次。第一次是 Agent 的落地位置变了:进专业领域(我这边是 GIS 数据处理,会上讲的是建筑图纸审查),进企业环境(涉及真实营收、涉及安全故障)。这两处都没有「肉眼看着还行」这条路,对错不由感觉定,由领域规范和风险定。
会上给的信号都朝这个方向:分级放行(中低风险辅助运行、高风险人工确认)、线上防模型自愈、多模型交叉验证防单一模型欺骗。这些都还不到评测方法,而是评测要顶住的要求。尺子的刻度是风险画的,不是技术画的。
我用什么搭,按什么顺序搭
第二次变重,是自己在写数据处理 Agent 的时候。迈出去的第一步其实不是评测,是观测。
LangSmith 对我的用处很具体:把一次运行摊开--调用链、每一步的工具调用、token 用量、中间的推理。以前只看得到输入输出,跑得好不好靠猜;摊开之后,「能从哪些方面评这个 Agent」才第一次有答案。
运行时 Agent 这边的技术选型是克制的:本体用 LangChain 的 create_agent,工具面是执行服务接口的薄封装,任务 JSON 走 structured output 出,轨迹用 middleware 落成 JSONL。生态里更重的东西--multi-agent 图、LangSmith evaluate、现成的 judge 基础设施,一个没上。
评测装置另起一摊:全 Node 的自建 harness,跟单元测试工程并列,零 langchain 依赖。判据能复用就复用,复用了单元测试攒下的 15 类断言、能力树的 keywords、能力注册表的 constraints;装置和被测物之间只隔一份轨迹 JSONL 契约。跨语言是多付的代价,换来的是解耦,以后换 Agent 框架,评测零改动。
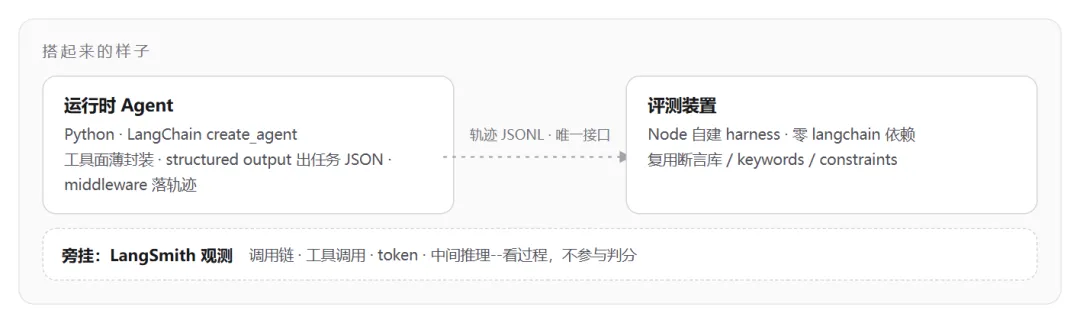
搭建顺序是这条路上最朴素的一个选择:先定契约,写一批手写轨迹让判据先活起来,跑装置自验(该挂的必须挂、同批双跑零波动),然后才让 Agent 主体开工,最后现场跑真--每个用例一个全新会话。理由也同样朴素:分数是「对象 × 装置」的属性,Agent 先做则迭代靠肉眼,装置后补时,判据很容易被写成「刚好过现有 Agent」。
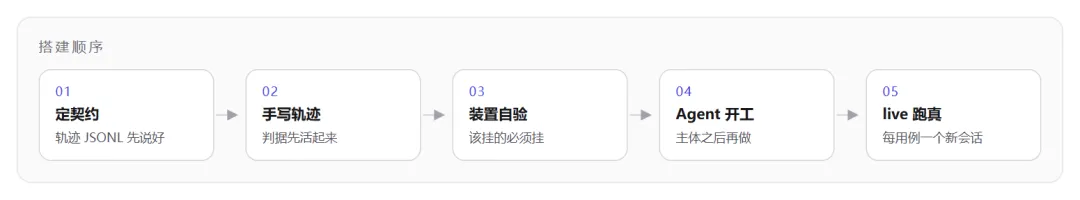
要评哪几件,也是在这时候定的。数据处理 Agent 就两件事要命:意图落在哪个能力上(能力选择),和这个能力的关键参数填什么值(参数填写)。我那套评测就是围绕这两件设计的--能力选择判精确匹配,参数填录取关键参数子集比对,链场景再升级成有序序列加逐段比对。
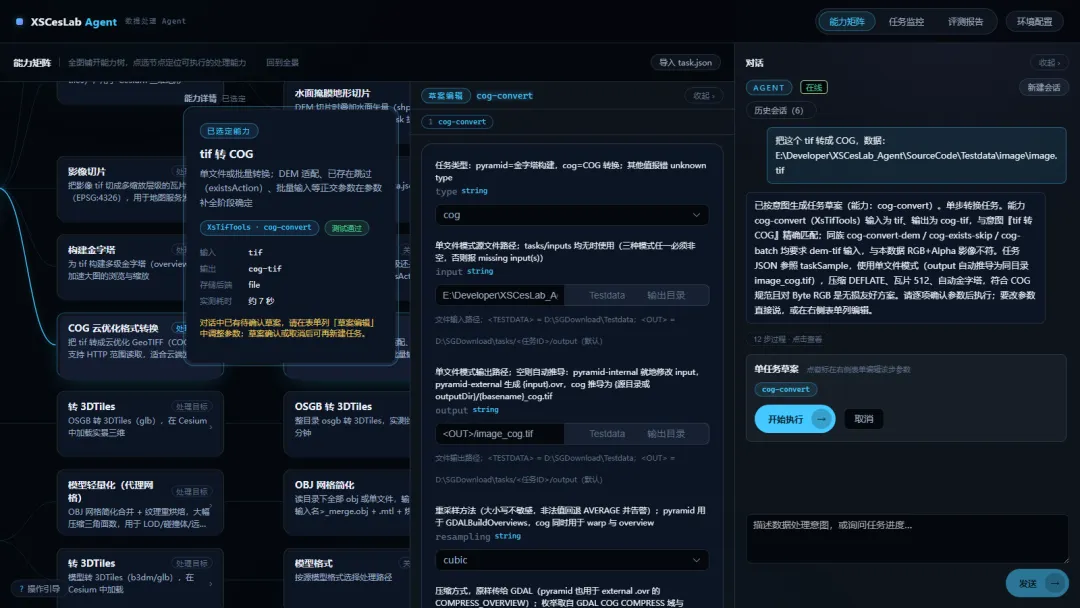
顺着这两件往下撞了三层:
看得到 ≠ 判得出。轨迹记的是「Agent 打算怎么干」,产物对不对得去看真实产物。判据因此分两型--重算型(白盒、可枚举、零波动)和采样型(分布、有噪声、要校准),能重算的尽量重算,判到对话质量那一层也还是白盒化,judge 没上场。
能评什么,在采集那一步就定了。早前那台两百行的评测 demo 只存了动作、观察和结论,模型每轮的思考没存,于是「推理是否合理」这一维永远评不了,judge 再强也只能在有损投影上做文章。后来我把采集口径单独当成一件事:先问这个评测问题需要什么证据,再决定落盘什么。
评测会反过来改 Agent。另一个项目(写作工作流)里要评「打回路由对不对」,做法就是把路由写成纯函数、状态落盘可回放。评测的要求会回流成设计约束,不只是跑完之后看一眼分数。
一例用例三件
LLM 评测集是「输入 + 期望输出」两件套;Agent 评测集必须多出环境这一件,因为 Agent 的答案取决于它面对的世界。行业里的形状也是这样:SWE-bench 是 Issue(任务)+ repo@commit(环境)+ Test Patch(判据),三者齐了才敢用二元结果说「解决了没有」;GAIA 的环境是工具与网络,OSWorld、AndroidWorld 的环境是桌面虚拟机和手机模拟器。少了环境,评测就退化成 LLM 评测;少了判据,只能人肉看。
环境这一脚,是我踩得最深的一次。有个负例考「该拦的必须拦」:输入 tif 已经含内部金字塔,再要外置金字塔,就该被前置约束拦下。它的前提原本是「拿一个已有内部金字塔的 tif」,而当时靠的是测试数据被别的用例原地改写后留下的偶然状态。换到干净树下跑一轮,数据探查显示没有 overviews,Agent 依据不足而放行--这是合理行为,判挂的是装置,不是 Agent。修法两条:前提 fixture 化(预建一个专门的 tif,与轮次顺序解耦),写操作关进副本目录。不可重建的前提,等于不可复现的结论。
任务、环境、判据三件的成色差得很远。题目可以合成--会上分享的两个案例,一个是人工构造 + 线上回流 + AI 合成三路扩题,另一个是线上 bad case 回流补集。判据常常能复用现成资产:我那套几乎没写判据,第一层用能力树的 keywords,第三层用能力注册表的 constraints,第四层直接 import 单元测试攒下来的 15 类断言。环境做不了这两种偷懒--SWE-bench 得把仓库快照钉在 commit 上,OSWorld 得备虚拟机,我跑一例地形瓦片得留出分钟级真跑时间。真跑贵的那层判据(L4 产物终判),最后只能安排成子集跑。
一集之上的四件制度
采集契约:被测 Agent 与评测装置之间只隔一份轨迹契约--工具调用、草案、拦截、约束命中、结束语、对话消息、路由判定几类事件,序列号从 1 连续递增,未知类型即违约;非 JSON 行、字段缺失、序列断裂一律按装置错误处理,不折算成 Agent 失败,保证「挂」只有一个含义。契约先于被测物存在:先定契约、写一批手写轨迹让判据先活,Agent 主体后开工--否则判据很容易被写成「刚好过现有 Agent」。还有一处取舍:产物层与链路层的判据根本不消费轨迹,直接读真实产物目录和执行服务的链聚合视图,轨迹的价值在可归因,不在当证据本体。
缺数据纪律:无轨迹可评的用例标缺数据,不计分、不捏造通过率;链路视图拿不到就跳过;策展来的用例参数没补齐,如实标 noClaim,不假装判过。报告里宁可有一列「没数据」。
装置自验:手写正负例轨迹跑判据,该挂的必须挂;同批双跑零波动。这条纪律是我被咬过之后才立的,例子在下一节「缺一件会怎样」。
立法档案:用例的 _note 记转写来源、口径取舍、每轮修订原因,用例集同时是决策档案;题目一律用自然语言复述需求、不泄露字段名,考的是意图到参数的映射,不是照抄。
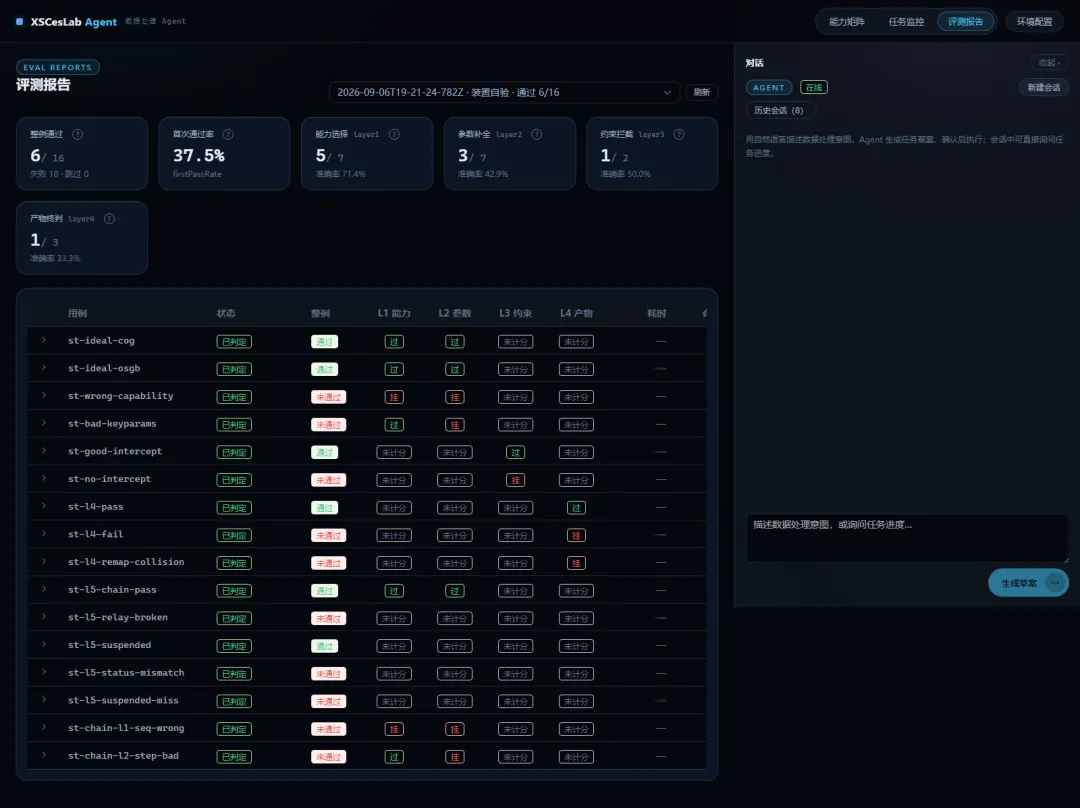
上面这张是装置自验的报告:用例 id 是手写轨迹(st-ideal-* 该过、st-wrong-* / st-no-intercept 该挂),判据跑出来的结果必须跟声明一致--先证这支尺子本身不歪,再拿它去量 Agent。
缺一件会怎样
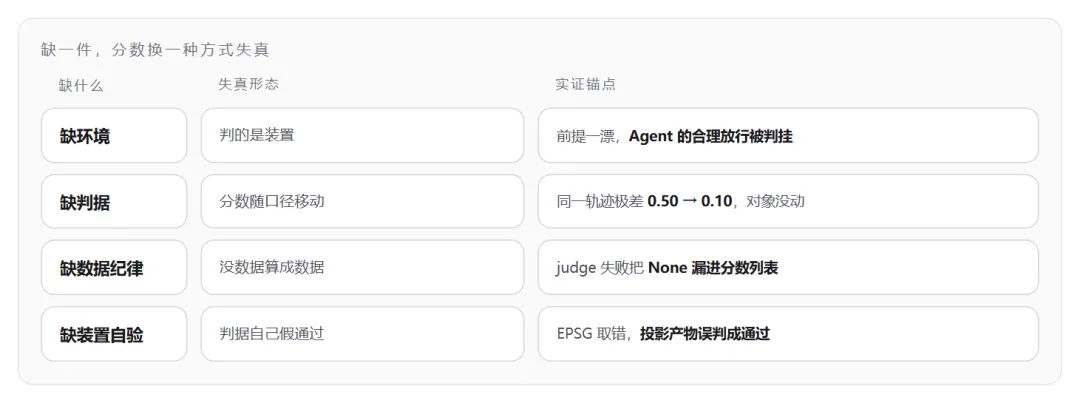
缺环境,判的是装置:前提漂移之后,Agent 的合理行为被判挂。这类失分穿着「Agent 不行」的外衣,最不好认。
缺判据,分数随口径移动:同一条轨迹,口径留白的 rubric 连喂五次是 [0.8, 0.75, 0.8, 0.75, 0.3],极差 0.50;换成口径钉死的 strict rubric,极差收到 0.10,对象一个比特没动。这也是会上「控制变量法」在装置侧的对应物--要比模型、编排和产品,任务、环境、判据三件都得不动。
缺数据纪律,没数据会被算成数据:judge 链路的网络失败曾把一个 None 漏进分数列表;聚合层怎么处理这种「无数据」本身也是设计题。
缺装置自验,判据自己假通过:产物校验里一条坐标系断言,原本取 WKT 里第一个 EPSG 码,而投影坐标系的 BASEGEOGCRS 恰好列在前面,于是把投影产物误判成通过--那是校验漏洞,不是产品缺陷,靠人眼永远看不出来。会上那句「评测基础设施要像产品一样对待、并编写测试用例」,说的就是这个。
同族的还有一条:prompt 压不住的事,都是工程问题。「不要写绝对路径」写进 prompt 照样出现绝对路径,最后靠产物路径守卫兜住。类型、键形、占位、进程终态这些「机器接不接受」的问题,回归确定性管线收口;判据的作用是把它们一件件拍出来。
两轮跑批的读数
同一套判据与用例骨架,两次全量快照(真跑 Agent 现场生成轨迹,不是手写模拟轨迹;第二轮多了 3 例策展用例,并新增了对话质量层):
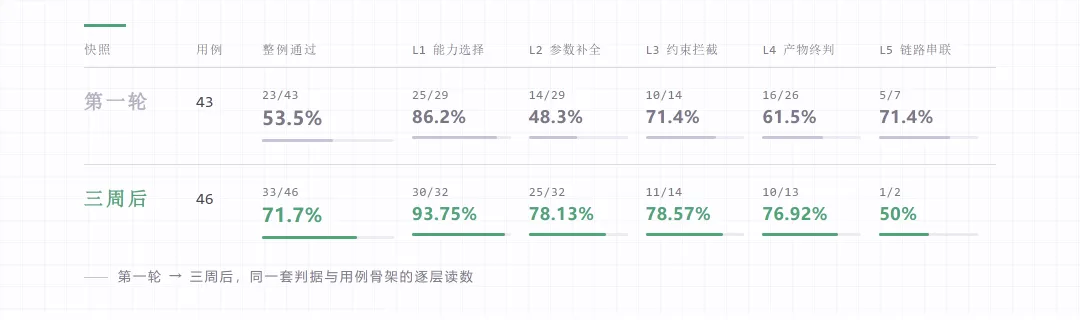
(表里 L4、L5 两列样本很小,只读趋势不读小数:链路层两轮分别只有 7 例和 2 例参与判分;对话质量层是第二轮才进判据的,没进这张表。)
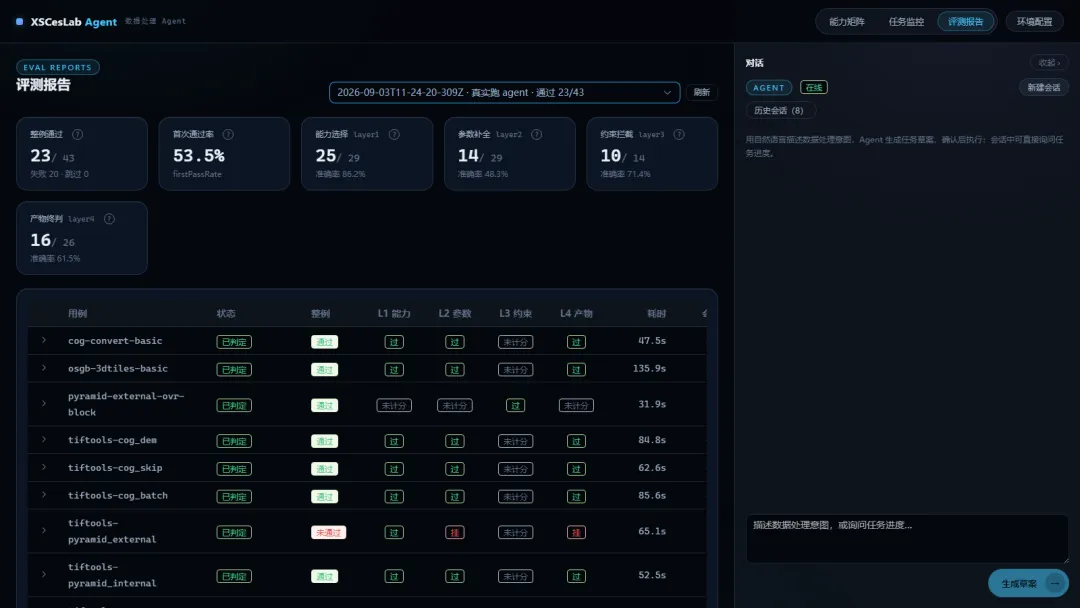
上图就是第一轮那一批(2026-09-03T11-24-20):整例 23/43、首次通过率 53.5%,逐用例一行,L1--L4 各自给「过 / 挂 / 未计分」。「未计分」是分层判据的天然形态--拦截负例本来就没有草案,L1/L2 无判据可跑;正例不该被拦,L3 自然空着。空着就空着,不折算成过。
能力选择一直是强项,参数补全是瓶颈。两轮结论一致:模型擅长「意图落在哪个能力上」这类语义匹配,弱在「关键参数该取什么值」这类本地约定。会上两条实践是同一件事的不同位置--一条用大模型做机评替代人工打标,一条用多模型交叉验证防自愈;模型能判语义,判不了本地约定。
提升不是靠改 prompt,是靠装置把失败模式一件件拍出来。那轮咬出的失败族里有模型包装抖动:数值写成字符串("256"、"5000")、数组包成 {"item": ...} 壳、<OUT>/out 被拆成对象。更隐蔽的是静默丢键--归一化管线缺一个兜底返回,草案里的 JSON 数值与布尔叶子一律变成 None,又被下游「null 一律剔除」无声删掉,全程没有警告。数据在管线里丢了却不报错,只有把判据钉在关键参数上才看得见。链场景还有产物名漂移:第一步产物写 <OUT>/terrain_tiles,第二步却去引用 <TESTDATA>/terrain,接力必断。
验收口径得按「被测物是概率性的」改。单测红等于代码错;评测挂只是「错了,或者这次采样歪了」。所以不追同轮全绿(模型逐调用抖动之下成本不可控),改成两条:整轮挂 1~2 例时修复并定点验证转绿;链用例逐一转绿、记录齐全即达标。波动还是回归也有依据--同批用例里有的例参数填满、有的例同一能力漏填,这种签名不一致的翻红,本身就是采样波动的铁证。
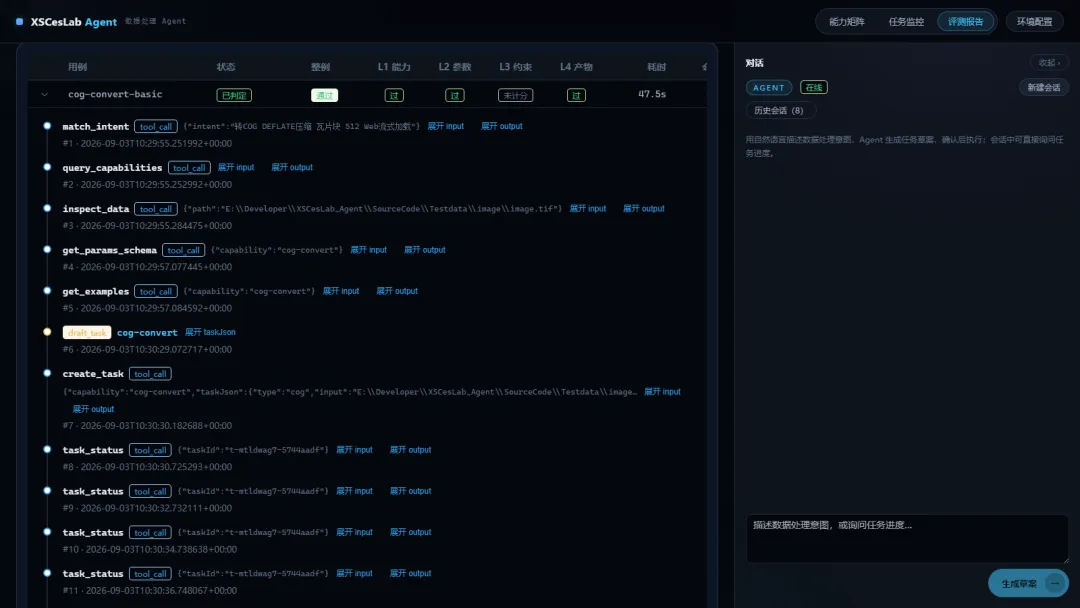
报告里每一行都能展开成轨迹:match_intent → query_capabilities → inspect_data → get_params_schema → get_examples → 草案 → create_task → 轮询 task_status,每步带序号、时间戳和入参出参。判挂的用例能顺着这条线回到原始会话复盘,而不是只看一个分数。
会上听到的:评测这道题还没答完
这次会听下来最直接的感受:评测本身的质量,行业还在探究,没有标准答案。关注点已经从「怎么把功能写出来」挪到「怎么证明它可靠」。我把听到的按问题归了几条。
技术选型:一条线做解耦--AgentCompass 把评测集、运行环境、运行框架拆成可替换的组件;另一条线做抽象--Harbor 把任务、模型、沙箱变成概念,覆盖任务规格、轨迹记录、运行时观测。这类选型选的其实不是打分工具,是以后每年都要维护的装置形态。
场景不同,尺子不同:通用与 GUI 类看复杂任务、多模态判断和跨应用状态流转(GAIA、OSWorld、AndroidWorld);软件工程类用 Issue 生成 Patch、Test Patch 验证,落到二元判定;深度搜索类盯引用真实性和幻觉;建筑审图那条线更有意思,评测标准从单专业能力转向跨专业冲突审查,直接拿真实项目当评测集,由总工判断可靠性来驱动迭代。同一次分享里出现的几种尺子,刻度完全不一样。
质量要求反写判据:企业侧要分级放行加人工兜底;概率性输出要补稳定性指标,做法是多次询问或交叉模型验证;机评要盯人机一致率,等于把 judge 自己也当成被测对象;软件工程那条线用测试先行加结果账本,把测试结果存成结构化 JSONL,做需求、用例、结果三层追溯,再用 A/B 模型互审加最大重试次数收口。
环境怎么搭:初期把全链路当黑盒评,不符合预期再按 SOP 拆层、每层单独建 benchmark。黑盒给「行不行」,分层给「差在哪」,跟我这边的分层判据是一回事;环境本身那两条硬约束(前提可重建、写操作隔离)是我自己踩出来的。
评测集怎么设计:数据来源上,会上是人工构造 + 线上回流 + AI 合成三路并行,上线后按 bad case 补,优先覆盖核心场景;我这边是种子用例转写加真实会话策展。这里我立了两条自己的规矩--题目不泄露字段名,合理误读回头钉死意图并留痕。还有一个判断:评测集可以自动生长,但立法必须人拍。从真实会话里能确定性提取用例草稿,可期望值定义的是「什么叫对」,那是标准不是数据;装置也要先立起来、自验过(该挂的必须挂、双跑零波动),再去跑被测物。
还没解决的
judge 的位置:开放语义维度(对话质量、文章好坏)目前只有采样一条路,跟零波动纪律冲突。仍按之前立的立场挂着:能重算就不采样。
最弱的一层是链:链路串联第二轮只有 50%,样本还只有 2 例。样本上不去的原因很实际--链用例要真跑分钟级、要备多段产物,环境成本直接压住样本量。
规模与成本的矛盾:前三层秒级可以全跑,产物层只能跑子集。想让全量进质量门禁,得先把真跑成本降下来。
一条边界:这套做法成立的前提是被测系统有可判定的终态;开放式写作、对话质量这类领域,目前只能退回采样型判据加人工验收。那台两百行的极简评测 demo 与这里的分界线也在这。
收个尾
半年下来,我对这把尺子的用法变了一次:从「算一个通过率」,变成「先问这个数字是怎么来的」。评测这道题我目前只答到一小块--有确定性终态的那部分;剩下的我会继续实践反思。
