hi,大家好,我是七鹿。
前面三篇,我们聊了 Roblox 新词挖掘的原理,也把判断游戏潜力的信号,拆成了可以观察和记录的指标。
但知道这些,还不够。
每天打开 Roblox,找游戏、查数据、看玩法,研究完一个,再研究下一个。
方法是有了,工作量也没有少多少。
所以,这个系列的最后一篇,再聊聊如何具体构建一个roblox游戏新词雷达:
从哪里找游戏、怎样采集和筛选、AI 负责什么、怎样输出结果?
首先肯定不是让 AI 随便推荐几个游戏。
而是给它明确的数据来源、筛选条件、判断规则和输出要求,让它持续帮我们找游戏、记变化、筛候选。
我的机会雷达,就是沿着这个方向做的。
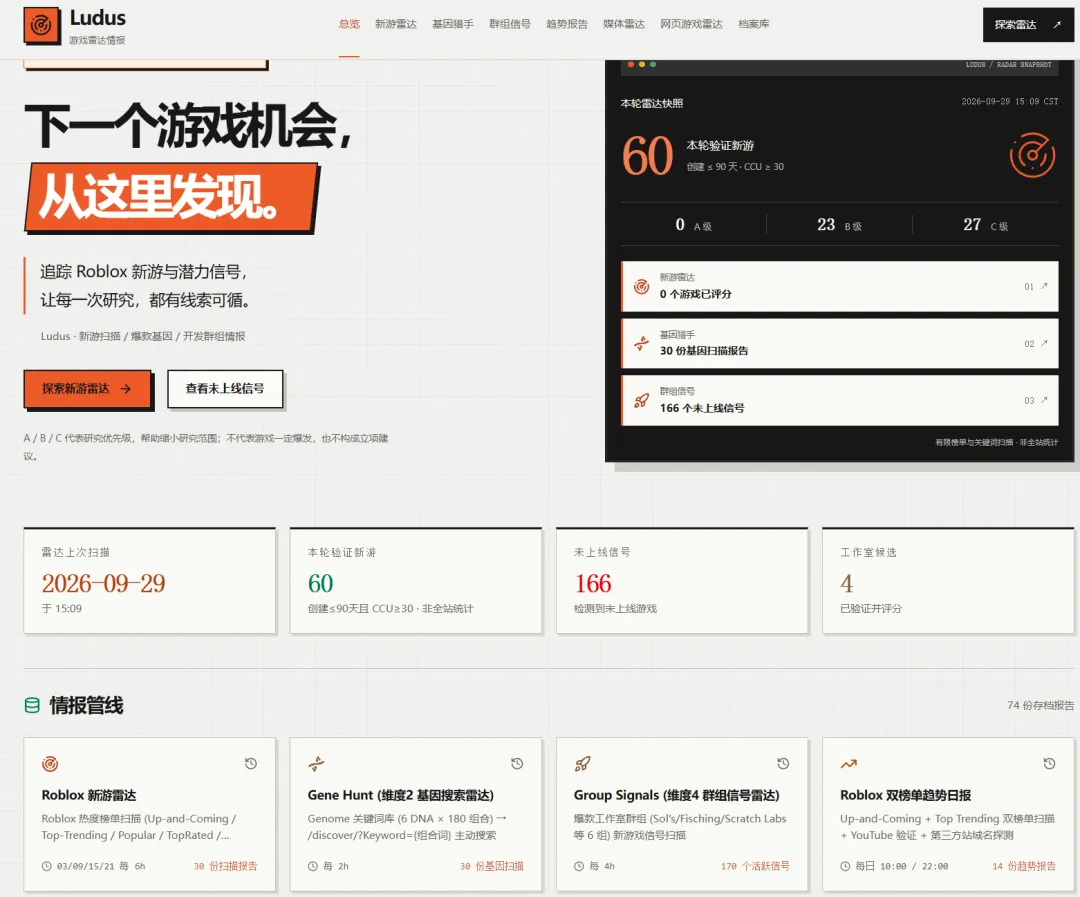
现在站点里已经能看到新游雷达、基因猎手、群组信号和趋势报告这几条入口。
下面就结合这些实际页面,把这套搭法拆开讲。
一、拆解找词流程
构建这个雷达,我觉得第一步不是选模型,也不是设计一个很酷的大屏。
先把找词的动作说清楚。
去哪里找游戏 → 核实是不是目标新游 → 留下数据 → 按规则分析 → 输出候选 → 到时间继续复查。
看起来就这么几步,但每一步都要有一个具体结果。
找到游戏,要留下准确的链接和来源。
核实新旧,要有创建时间,不能看到标题写着 NEW,就当成刚上线。
分析增长,要有之前的数据,不能只看现在的在线人数。
判断潜力,要能解释依据,不能只有一句“具备爆款基因”。
输出名单,也不能到这里就结束。下一次什么时候再查、查什么、什么变化值得重新关注,都应该留下来。
这样拆完,才知道哪些交给程序,哪些交给 AI,哪些暂时还需要自己看。
自动化不是把一句“帮我找新词”交出去,而是把这条流程接起来。
第一版甚至不需要网页。
先让它真实跑一轮,产出一份有来源、有数据、有判断的报告。报告有用了,再把它搬到页面上。
比如七鹿就是先跟AI聊清楚流程,然后让hermes 帮我跑,再将每日新词报告推送到飞书,再验证基本准确后,最后才是构建整个雷达监测网站。
二、第一步:把爆款基因,变成能主动搜索的词库
还记得前面我们研究了几个游戏的基因特征吗? 这些游戏的共同特征,到了这里就有实际用途了。
我们不一定知道下一个游戏叫什么,但可以先整理出一批与玩法、奖励、场景相关的词,拿着这些词去找游戏。
这就是我站点里“基因猎手”的思路。
公开页面把搜索词分成了六类,并列出了一个 180 个组合的关键词矩阵。这里的六类,是搜索词库的分类,不是把前面文章的判断指标重新换了一套。
这些词的作用,不是证明一个游戏会爆。
而是给搜索一个方向。
比如,报告里实际出现过 party + game、mutation + rare、unbox + ASMR 这样的搜索组合。程序轮换这些组合,从返回结果里收集游戏,再交给后面的验证环节。:chatgpt-content-reference{index="2"}
这样一来,原来的动作是:
我想到什么,就搜什么。
现在可以变成:
把搜索方向整理好,让程序按顺序跑,并记住哪些已经搜过。
这里有个容易踩的坑:
命中搜索词,不等于游戏真的具备对应玩法。
搜一个收集相关的词,返回的游戏未必有完整收集系统。标题写了稀有,也不代表它有值得研究的稀有度机制。
所以,关键词库负责把候选找进来,后面的玩法分析才负责判断。
不要直接拿“命中了几个词”,当成“有几个爆款基因”。
词库也不是越大越好。构建时应该同时记下每个组合搜出了什么、留下了多少有效候选。连续搜不出有用结果的组合,后面再调整,而不是不断往里面堆词。
三、第二步:不要只靠搜索,给雷达接上不同入口
主动搜索是一条路,但不是唯一一条。
我这套雷达的公开流程里,还接了榜单扫描和开发群组信号。它们寻找的是不同阶段、不同来源的候选。:chatgpt-content-reference{index="3"}
榜单入口,负责观察已经出现公开热度的游戏。
比如上升中、热门趋势等榜单。
构建时,不只保存这次榜单里有什么,还应该和上次比较:有没有新进入的游戏,哪些游戏的位置或在线人数发生了变化。
关键词入口,负责主动找。
不是等游戏被榜单推到眼前,而是带着前面整理的玩法词,去搜索候选。
群组入口,负责看开发者和工作室的新动静。
公开的群组信号页面,会记录候选名称、所属群组、创建时间和首次发现时间。这里面也能看到测试场景、工作区之类的条目,所以我会把它理解为“待验证线索”,而不是一出现,就认定它即将正式发布。:chatgpt-content-reference{index="4"}
三个入口接进来以后,马上要做的一件事,是合并。
同一个游戏,可能在榜单里出现,也可能被几个关键词搜到,还可能出现在群组列表里。
不能因为它出现了三次,就算发现了三个新游戏。
实际构建时,可以用游戏的 Universe ID 作为统一身份,把不同入口的发现记录挂到同一个游戏下面。Roblox 官方文档提供了游戏详情、群组游戏、收藏数量、投票等相关接口;公开扫描报告中也记录了先解析 Universe ID、再查询游戏详情的两阶段验证过程。:chatgpt-content-reference{index="5"}
这样,每个游戏就不只剩一个名字。
而是能知道:
它第一次从哪里进来,后来又在哪些地方被发现,哪些数据已经核实。
四、第三步:先验证、存数据,再谈增长
候选找到了,不要立刻全部丢给 AI 做深度分析。
先做一轮便宜、明确的验证。
我公开的新游扫描采用过“创建时间不超过 90 天、同时在线不少于 30”的筛选口径,报告里也会记录因为年龄、低在线人数或重复命中而被排除的游戏。
这类门槛的作用,是控制研究范围和处理成本。
不是说第 91 天的游戏就没有机会,也不是 29 人在线和 30 人在线之间,存在什么神奇的分界线。
尤其要区分几个时间。
游戏创建时间,是平台记录。
首次发现时间,是雷达第一次看到它。
正式公开上线时间,能核实再记录,不能直接用前两个时间冒充。
之前的设计里,就专门把创建、首次发现、首次观察到活跃的时间分开了。
验证之后,才进入持续记录。
要把第三篇里的增长指标真正接进来,最基本的要求就是:每次采集追加一条记录,而不是把上一次的数据覆盖掉。
一条记录至少要包含游戏身份、采集时间、同时在线、累计访问、收藏、投票、更新时间,以及这次采集是否成功。
这些公开数据的历史快照,也是之前设计中计算增长和保存判断的基础。
为什么这么做?
因为“现在有 1000 人在线”,只说明现在。
它之前是 100 人,还是 5000 人?昨天同一时段是多少?一次高峰过后,有没有留下更高的日常水平?
这些问题,都需要历史记录。
程序可以根据同一套规则计算变化,但不能在没有记录的时候,把一条趋势编出来。
没有足够历史,就显示数据不足。采集失败,就记录失败。不要拿零去填。
五、第四步:让程序算数据,让 AI 读玩法
到了分析这一步,我会把两种工作分开。
在线人数变化、访问增量、收藏增量、时间窗口比较,这些交给程序计算。
游戏核心动作是什么,奖励从哪里来,玩家有没有继续玩的目标,哪些机制得到证据支持,这些再交给 AI 辅助整理。
不要让 AI 一边猜数据,一边写玩法,最后自己给自己打个高分。
更合适的流程是:
先提取事实,再按固定标准评分。
比如,拿到一个游戏的介绍和玩法素材,先让 AI 整理核心动作、奖励方式、成长目标、玩家互动,以及还不能确认的内容。
这一步先不急着下结论。
然后,才拿这些整理好的事实,对照前面几篇形成的判断标准。之前的设计也是把事实提取和规则评分拆成两步,并要求每个评分保留证据和未知项。
这里最重要的不是提示词写得有多长。
而是让同一批游戏,接受同一套问题和标准。
不能今天因为标题好玩就加分,明天因为封面漂亮又换一种判断。
还要认清公开数据的边界。真实留存、真实平均游玩时长等数据属于有权限的游戏分析范畴,不能把外部看到的在线、访问和收藏,直接说成自己已经测到了留存。
现在站点里已经有评分和研究等级。要把这一层继续完善,我会沿用之前的设计,把三个东西分开看:
潜力怎么样,证据够不够,目前处在哪个观察阶段。
这对应之前设计中的 Alpha Index、Confidence 和 Stage,但不能把它们与网页上现有的 A/B/C 等级直接当成同一套已经完整上线的评分。
这样,一个玩法看起来不错、但数据还很少的游戏,就可以保留为高潜力候选,而不是被包装成高确定性的机会。
六、第五步:输出的不是一堆分数,而是一份能继续执行的报告
前面这些步骤最后要落到什么?
不是一句“今天发现 100 个游戏”。
我更需要的是一份能接着往下做的报告。
拿站点里 2026 年 9 月 1 日的一份历史扫描报告举例,里面记录了这样一个候选:
游戏:Crown or Pass发现来源:party + game 关键词搜索创建时间:2026 年 7 月 23 日报告时同时在线:1,031当时研究等级:B,评分 79/100
这些是当时报告记录的数据,不是今天的实时状态。它至少把“从哪里找到、是不是目标范围内的新游、当时怎么看它”留了下来。
但完整的雷达,还应该再往前走一步:
下一次查什么?
这个在趋势报告里已经有具体例子。
9 月 1 日的报告为 Infected Lands 记录了约 4,500 的同时在线,并安排了 12 小时后的复扫,观察在线是否超过 6,000。这里的 6,000 是当时那条观察任务的条件,不是所有游戏通用的爆款门槛,也不能说明它后来一定达到。
这个形式很有用。
报告不再停留在“值得关注”。
而是留下一个可以执行、也可以被验证的下一步。
构建时,我会要求每个重点候选都带上下一次检查时间和检查内容。可能是补一段玩法证据,也可能是等待下一轮数据,或者核实某个异常增长。
没有变化,就继续记录,不必反复把同一句结论推送给我。
有明显变化,再重新排优先级。
另外,报告还必须交代这次任务本身的状态。
公开历史报告就出现过部分关键词通道被限流、结果降级的记录。遇到这种情况,应该告诉我“这部分没正常完成”,而不是把它解释成“今天没有新机会”。
没有候选,和没有采集成功,是两回事。
七、第六步:把任务排上时间,再用后面的结果检验它
一轮能跑通,还只能叫一次自动找词。
要成为雷达,就得持续运行。
但持续运行,不等于所有任务都用同一个频率。
站点公开的管线说明里,关键词扫描、群组扫描、新游汇总和趋势报告采用了不同的调度安排:分别有每 2 小时、每 4 小时、每 6 小时,以及每天固定时段的任务。这是公开配置展示的分工,不等于仅凭网页就能确认后台当前每轮都准时完成。
具体构建时,我会把两件事分开:
一件事,是继续发现新的游戏。
另一件事,是反复观察已经发现的重点候选。
前者要扩大覆盖,后者要积累变化。
不需要每次都让 AI 重新读一遍没有变化的介绍。数据刷新可以更频繁,玩法分析则在新游戏进入、内容有明显变化,或者需要复核时再做。
这也是控制成本的地方。
再往后,完整雷达还应该补上一层:回验。
这部分在之前的方案里,设计的是 7、14、30 天后检查结果,并冻结每次判断时的数据和规则版本。这里讲的是需要落地的验证设计,不把站点已有的报告归档,等同于已经完成了整套回验。
回验要先约定什么叫“判断得到支持”。
不能看到游戏后来涨过一下,就说预测成功;没涨,就说它还需要时间。
也不能只追踪高分游戏。应该从普通或低分候选里留一部分对照,看看排在前面的游戏,后来到底有没有更好的表现。
对我来说,最后要回答的其实是三个问题:
后来增长的游戏,我有没有提前发现?
发现以后,有没有把它及时排到值得研究的位置?
当时的判断,到底给我留下了多少提前准备的时间?
这才能分清楚,是入口没覆盖到,还是评分判断错了,或者提醒得太晚。之前的验证设计,也把发现覆盖、前列候选命中情况和提前量分别作为效果指标。
规则要不要改,应该看这些结果。
不是今天漏了一个游戏,明天就重写一套模型。
八、交给 Codex,我会分几次做,而不是一次造完
说到这里,可能有人会觉得,还是挺多的。
所以,真正动手时,我不会把上面所有东西一次性塞给 Codex,让它“帮我做一个完整平台”。
我会把交付拆开。
第一轮,先交一份真实报告。
给它一份词库,接一个能工作的候选来源,拿到游戏身份和基础数据,完成去重、筛选和带证据的分析。
先不要用户系统,不要收费系统,也不要大屏。
验收时,就打开报告里的游戏,看来源对不对、数据能不能对上、判断有没有依据。
第二轮,让同一套流程重复运行。
接上定时任务,追加保存每次数据,能比较前后变化,也能显示哪些任务失败了、哪些数据已经过期。
这一轮的结果,不是“页面上有个自动化开关”。
而是过了一段时间以后,确实留下了不同时间的真实记录。
第三轮,再补重点复查和结果回验。
让候选带着下一步检查任务,保留当时判断,等观察周期到了再回来核对。
这三轮跑通之后,网页做什么就很清楚了。
展示候选、查看变化、追溯依据、阅读历史报告。
从最低成本起步,先有词库、采集任务、历史记录、分析规则和报告,就能开始验证这个雷达到底有没有用。
缺了哪个环节,再补哪个。
不用先造一个庞大的 AI 系统,才能开始找游戏。--切记
这就是这四篇文章最后要落到的地方。
前面研究游戏,不是为了总结几句“爆款都有这些特征”。
整理指标,也不是为了列出一张看起来专业的表。
而是要把它们接起来:
用玩法词主动找候选,用真实数据验证,用固定标准分析,用后续结果修正判断。
雷达负责持续把值得研究的游戏送过来。
再往后,做站的人还要研究玩家的具体问题和搜索需求,决定做什么内容、什么工具。确定值得投入,再接上 RB Auto 的建站流程。
不要把这两步反过来。
也不要让雷达一打高分,后面就不经过研究,直接批量上站。
真正值得复制的,不是某天榜单上的几个游戏名。
而是把找词这件事,从偶尔想到才做,变成一套能持续发现、持续记录、持续验证的流程,为后面的全自动化上站输送弹药。
最后给大家分享一个提示词:
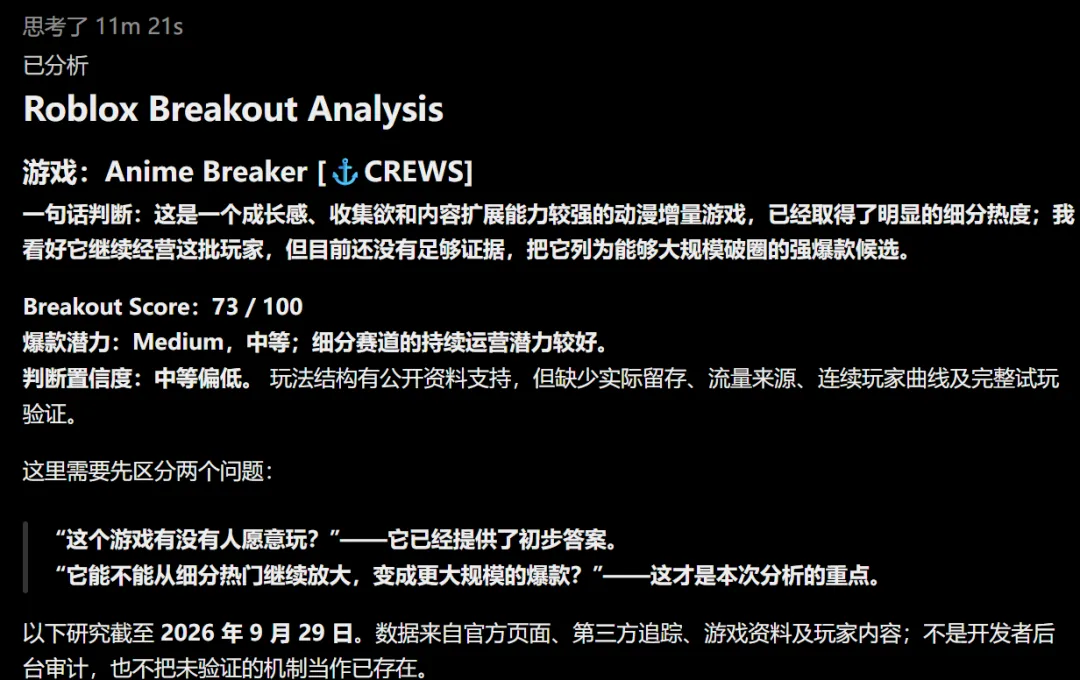
https://github.com/kennyzir/7deer_skills大家直接到我的开源仓库获取,拉到最下方找游戏爆款基因分析提示词。
实测真好用。可以直接借助这个提示词,对任何你发现的游戏进行爆款预估。将roblox游戏连接和这个提示词一起发给ChatGPT或者gemini 即可。
最后给大家介绍下我的游戏全自动化上站系统:Rbauto
这套系统七鹿接近1年时间打磨,从去年10月份开始研究roblox游戏站,然后开始手工建站,到用openclaw和hermes半自动化建站,最后再到这套AI驱动的全自动化建站系统。
目前基本已经完全释放人工,这套系统可以无缝接入本文聊到的新词雷达,实现无人值守的自动建站,
包括找词、关键词挖掘、SEO研究、自动化更新,购买域名、上站部署、博客外链等全流程。
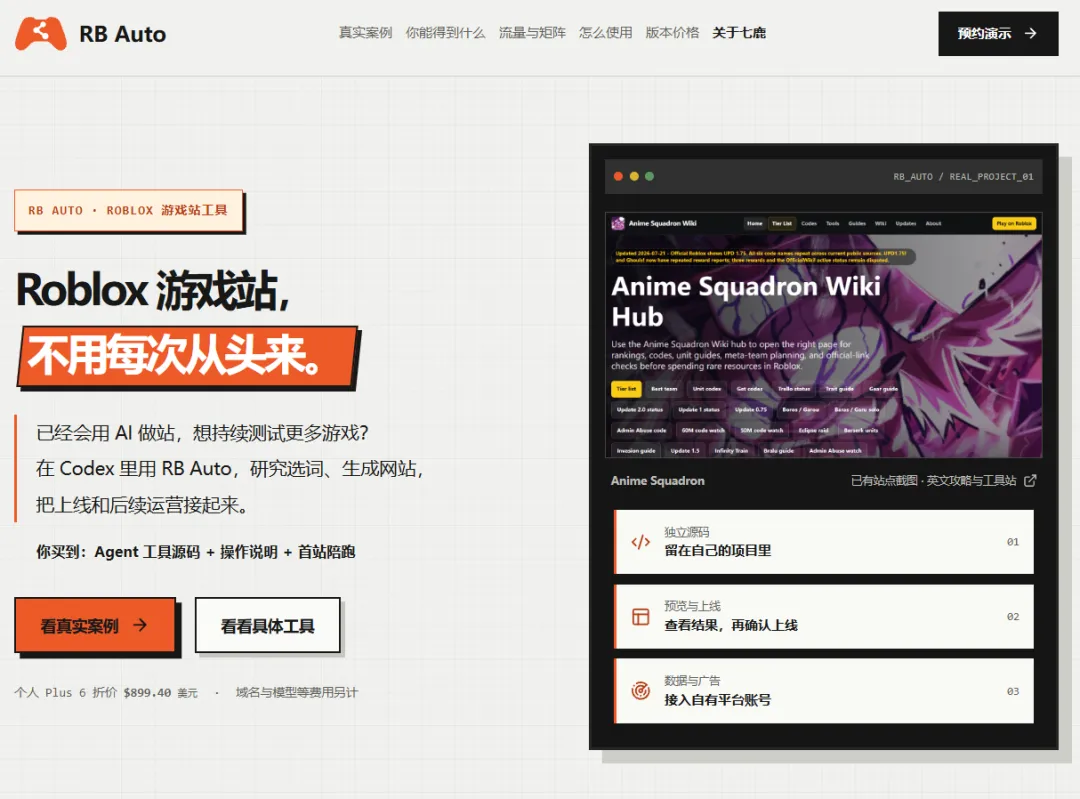
做 Roblox 游戏站,最累的不是做出第一个,而是每换一个游戏,又得从头折腾。所以七鹿将这套流程做成了 RB Auto全自动化上站工具:选词研究、页面生成、SEO 检查、上线更新,在 Codex 里串起来。
这套Agent工具的源码会全部交付给你,第一个站,七鹿会陪你上手。
不是承诺每个站都赚钱,而是让你不用把几个月押在一个词上,能持续测试多个游戏,把精力留给真正跑出流量的站。
虽不敢说买了这套系统就能百分百保证挣到刀了,也不敢说百分百保证拿到流量。
但至少能节约你半年的摸索时间,能帮你快速从0-1搭建游戏站的玩法体系,解决1-10的自动化规模化快速站点构建。
大家可以到这里先看案例和演示,再决定是否适合自己。 https://rbauto.ludusdex.com
以上。这套全自动化系统目前是付费的,感兴趣的微信call七鹿vx: aiqizilu ,直接暴击折扣。
最近行业玩游戏站的声量少了,七鹿还在继续坚持,建了个游戏站交流群, 有意的兄弟加我,免费拉你进群。