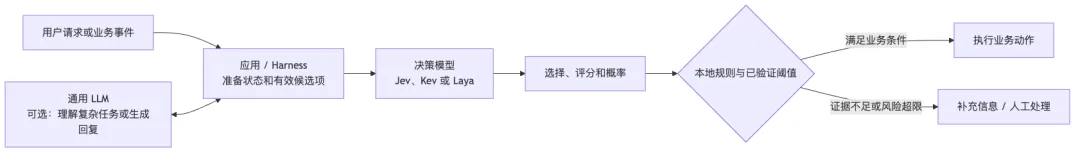
当业务代码只需要判断“工单交给哪个团队”“检索结果是否相关”“是否转人工”时,可以把问题写成固定候选项,让模型直接返回选择和概率。
Jev、Kev、Laya 都提供了这样的接口:输入当前状态和类型化问题,输出供程序使用的判断。它们的共同目标是减少把文本答案转换成业务分支的步骤。
但接口相近,留下的工程选择依然很多:模型部署在哪里,能否用自己的数据训练,概率是否适合设置阈值,宣传中的准确率和延迟究竟测了什么。
先给出本文的选型方向:
Jev:通过 TypeSafe 托管 API 接入,适合先建立业务效果基线。
Kev:在 Qwen 底座上训练决策能力,提供多个模型规模,适合需要自行部署和定制的场景。
Laya:采用较小的编码器模型,适合评估高频、明确、可以提供领域标注的判断任务。
这些是根据架构和部署方式给出的工程建议,最终选择仍需要业务数据验证。
本文依据截至 2026 年 9 月 29 日可见的官方文档、作者仓库及模型卡整理。文中跑分均标明公开评测来源;概率算例和评测方案是解释性示例。
一、先看三者分别交付了什么
这里的 B 表示十亿参数,M 表示百万参数。Kev 和 Laya 公开了代码与权重;Jev 的官方快速开始以云端 API 为入口。它们可以承担相似的业务判断,但 Kev、Laya 都是独立实现。
来源:TypeSafe 快速开始(https://docs.typesafe.ai/introduction/quickstart)、Kev 作者仓库(https://github.com/jaredpalmer/kev)、Laya 作者仓库(https://github.com/NandhaKishorM/laya)。
二、共同接口:状态、问题、候选项
三者都支持 choice、score、noul 这三种问题:
例如,下面是一份工单分流请求。使用 Jev 时,model 可以填写 jev-latest;使用其他服务时,应替换为对应实现支持的模型标识。
{ "model": "jev-latest", "state": { "message": "我的订阅被重复扣款了,请帮我查一下。" }, "questions": { "department": { "type": "choice", "instructions": "哪个团队最适合处理这条请求?", "criteria": { "billing": "支付、账单和重复扣款问题", "technical": "程序故障、接口和系统可用性问题", "other": "当前分类无法覆盖的问题" } }, "urgency": { "type": "score", "instructions": "只根据消息中明确提供的信息评估紧急程度。", "criteria": [ "普通咨询,没有明确时限", "业务受到影响,需要优先处理", "明确紧急时限或严重业务中断" ] }, "refund_requested": { "type": "noul", "instructions": "用户是否明确要求退款?" } }}
这个例子刻意把“发生扣款问题”和“明确要求退款”拆成两个判断,方便分别标注、评估和处理。
它是请求结构示例,具体中文效果需要测量。输出格式受到约束,可以减少自由文本带来的解析问题;语义判断仍可能错误,包括误读否定词、忽略条件或选择错误类别。
类型与返回值的定义见 TypeSafe Primitives(https://docs.typesafe.ai/primitives) 和 API Reference(https://docs.typesafe.ai/api)。
三、它们在系统中处于同一个判断位置
模型接收状态,返回判断。应用代码负责维护流程、生成有效候选项,以及执行后续动作。
工单分流可以直接由业务系统调用决策模型。需要开放式规划或生成回复时,再组合通用 LLM。
例如,模型判断“属于账单问题”后,代码可以把工单交给账单团队;退款资格、金额和执行权限仍应由业务规则及可信数据确定。模型输出属于判断证据。
四、底座差异:Qwen 决策读出与编码器决策读出
1. Jev:官方公开了接口与训练目标
TypeSafe 将 Jev 定位为 System One 模型,并说明其训练路径是 RLCD:Reinforcement Learning for Calibrated Decisions,目标是得到结构化决定和经过校准的概率。TypeSafe AI Primer(https://docs.typesafe.ai/introduction/machine-learning-primer)
本文查阅的官方资料没有给出完整底座、参数量和权重实现。因此,对 Jev 的工程评估应从可观察的 API 行为、业务效果和服务表现出发。
Kev 作者引用了第三方对 Jev 架构的分析作为设计来源。理解 Kev 时可以参考它,但这不能作为 Jev 官方架构已经公开的证据。
2. Kev:保留 Qwen 的表示能力,训练候选项的读出
Kev 在 Qwen 模型上增加 LoRA 适配器和 pointer head。可以把它理解为:
状态 + 问题 + 候选项 ↓Qwen 底座及 LoRA ↓问题表示与各候选项表示 ↓pointer head 评分 → 概率分布
这种读出直接给候选项打分,服务路径不需要逐 token 生成聊天答案。候选项来自当前请求,因此输出空间可以随问题改变。Kev 模型实现(https://github.com/jaredpalmer/kev/blob/main/kev/model.py)
当前 Qwen3.5 / 3.8 实现把问题放在独立行中,并在服务路径复用状态缓存。一次 API 请求可以包含多个问题,底层计算方式仍取决于模型、缓存和 token 预算。Kev 状态缓存实现(https://github.com/jaredpalmer/kev/blob/main/kev/model.py)
Kev 的基础训练使用交叉熵,训练适配器与读出头;具体版本还可能增加后续数据和训练阶段。这个方案和 Jev、Laya 公开描述的 RLCD 路径有区别。Kev 训练实现(https://github.com/jaredpalmer/kev/blob/main/kev/train.py)
3. Laya:采用更小的编码器底座
Laya 的三个公开检查点使用 ModernBERT-large 或 mmBERT-base,参数量约为 3.22 亿至 4.21 亿,直接输出类型化决定。作者描述其训练采用 RLCD,并提供领域微调工具。Laya 项目说明(https://github.com/NandhaKishorM/laya)
较小的模型提供了较轻量的部署起点。能否满足业务准确率,还要看语言、候选项数量、输入长度以及训练任务与当前业务的差异。
因此,“更小”可以作为资源评估的依据,不能单独作为效果判断。
五、模型名称后面,还要看具体检查点
Kev 的四种规模
前三种从 Base 检查点开始;27B 使用已经后训练的底座。作者说明其底座后训练数据未知,因此不同规模间的差异同时包含参数量和训练经历。Kev 模型列表(https://github.com/jaredpalmer/kev#models)、Kev-27B 模型卡(https://github.com/jaredpalmer/kev/blob/main/docs/model-cards/kev-27b.md)
27B 也有明显的部署要求:作者报告 bf16 权重约 55 GB,加上服务缓冲约 66 GB,需要相应的数据中心 GPU。选择规模前,应确认实际服务内存,而不只计算权重文件大小。Kev-27B 部署说明(https://github.com/jaredpalmer/kev/blob/main/docs/model-cards/kev-27b.md)
Laya 的三个检查点
根检查点主要用于英语;中文等输入应评估 multilingual 检查点。其编码器支持更长窗口,但默认预算、选项预算与实际长文档准确率仍需分别检查。Laya 检查点说明(https://github.com/NandhaKishorM/laya)
这个差异会影响评测:用英文检查点测试中文业务,再把结果概括为“Laya 的准确率”,会丢掉重要条件。
六、读准确率之前,先读训练条件
1. Laya 的 76.6% 来自任务微调
Laya 作者在 typed-decisions 测试中报告了如下结果。该测试包含 400 个案例、2000 个决定:
| |
|---|
| |
| |
| 微调后的 laya-typed-decisions | |
| |
| |
0.766 对应在这套任务的训练划分上微调后的检查点。基础检查点在这套测试上接近随机水平;这并不等于它们在所有分类任务上都接近随机。
作者报告同时说明,引用的 Jev 成绩来自第三方公开结果,样本数量和问题写法不同。因此,报告中“Laya 与 Jev”的数字应作为参考,不能直接当成严格同条件胜负。Laya 评测报告(https://github.com/NandhaKishorM/laya/blob/main/BENCHMARKS.md)
2. Kev 区分训练来源和新来源
Kev 发布资料区分:
这两种评估分别帮助观察领域内表现与迁移表现。留出同一来源的样本,和面对新业务来源,是不同难度的问题。
作者发布资料的新来源准确率摘要如下:
这里的 Jev 只在开发集上测量。因此,“Kev-27B 接近 Jev”引用的是开发集上的 0.848 与 0.857;不能把 Kev 的测试集 0.896 拿来和 Jev 的开发集 0.857 排名。
Jev 的训练来源未知,Kev-27B 底座的后训练来源也未知,这仍不是控制了所有训练变量的架构实验。数据及条件见 Kev 评测摘要(https://github.com/jaredpalmer/kev#models)、4B 模型卡(https://github.com/jaredpalmer/kev/blob/main/docs/model-cards/kev-4b.md)、9B 模型卡(https://github.com/jaredpalmer/kev/blob/main/docs/model-cards/kev-9b.md)、27B 模型卡(https://github.com/jaredpalmer/kev/blob/main/docs/model-cards/kev-27b.md)。
具体发布版本还可能改善某些任务、降低另一些任务。模型卡中的版本、数据来源和失败记录,比一个总准确率更适合判断能否迁移到自己的业务。Kev-4B 模型卡(https://github.com/jaredpalmer/kev/blob/main/docs/model-cards/kev-4b.md)
七、几十毫秒的延迟,测量口径是什么?
作者公开测量中,可以找到这些数字:
来源:Laya Speed(https://github.com/NandhaKishorM/laya/blob/main/BENCHMARKS.md#speed-tesla-t4)、Kev Serving Performance(https://github.com/jaredpalmer/kev#serving-performance)。
这张表用于说明测量条件,不能用于给三者排速度名次:硬件、问题数量、输入和服务路径不同,而且它没有包含同条件的 Jev 测量。
业务中真正关心的是:
端到端延迟= 输入处理 + 排队 + 模型计算 + 后处理 + 网络往返
冷启动、并发和缓存也应单独记录。例如 Kev 报告区分新文本与重复文本,重复文本可以复用缓存;托管 API 则需要测量应用到服务的实际网络路径。
本地 CPU、消费级 GPU、数据中心 GPU 和远程 API 应按自己的使用条件比较。更小的模型通常提供资源优势,但框架开销、批处理和实现优化也会影响最终延迟。
八、同一个 confidence 字段,可能不是同一个数
概率分布和 confidence 要分开理解。TypeSafe 官方说明,Choice 与 Score 的 confidence 是从答案概率分布计算出的统计量。TypeSafe Confidence(https://docs.typesafe.ai/confidence)
当前 Kev 与 Laya 实现使用不同的计算方式。下面只比较有多个候选项的 choice。
1. Kev:归一化后的最大概率
设候选项数量为 K > 1,最大候选概率为 p_max:
C_kev = (p_max - 1/K) / (1 - 1/K)
Kev 说明它沿用 TypeSafe 参考适配器的计算定义。该值衡量最大概率相对于均匀分布提高了多少。Kev API 说明(https://github.com/jaredpalmer/kev#api)
2. Laya:一减归一化熵
当前 Laya 的 confidence 定义是:
H(p) = -Σ p_i × ln(p_i)C_laya = 1 - H(p) / ln(K)
它衡量整个分布的集中程度。Laya 还提供 answer_confidence,用于表示报告答案的概率;字段含义应以固定版本的实现为准。Laya 服务兼容说明(https://github.com/NandhaKishorM/laya#self-hosting-http-server-jev-compatible)
3. 相同概率,两个不同的 confidence
假设三个候选项的概率是:
{ "billing": 0.6, "technical": 0.2, "other": 0.2}
这是一组算例,计算结果为:
三个数都来自同一组概率,却表达不同含义。把旧系统的 confidence >= 0.8 原样移到另一个实现,会改变被自动处理的样本集合。
即使统一使用最大候选项概率,也要测量它在当前数据上的可靠性。只有经过校准和验证,概率区间才有希望对应相近的实际命中率。
4. 校准与提高准确率是两件事
温度缩放常见形式是:
当 T 是同一问题使用的正数标量时,它调整概率分布的陡峭程度,保留候选项的大小顺序。因此,它不会直接修正已选错的候选项。
可以把三件事分开检查:
准确率:答案是否正确。
校准:报告的概率与实际频率是否匹配。
阈值表现:选出的自动处理样本是否满足错误预算。
Kev 发布检查点附带温度参数;Laya 作者报告基础检查点存在校准偏差,并建议在自己的数据上重新拟合。发布校准参数也不能保证换了业务分布仍然可靠。Kev-4B 校准记录(https://github.com/jaredpalmer/kev/blob/main/docs/model-cards/kev-4b.md)、Laya Calibration(https://github.com/NandhaKishorM/laya/blob/main/BENCHMARKS.md#calibration)
九、接口兼容时,还要检查约束和含义
Kev 和 Laya 都提供 POST /v1/systemone 风格接口,方便复用客户端代码。迁移时仍应检查:
例如,TypeSafe 当前 API 文档规定 Choice 最多 255 个选项,Score 接受 2 至 10 个等级。Kev 文档中的等级范围不同,不能据此假设同一请求在所有实现中都合法。TypeSafe API Reference(https://docs.typesafe.ai/api)、Kev API(https://github.com/jaredpalmer/kev#api)
Laya 的候选描述共享选项 token 预算。候选项很多时,描述可能被裁短,原本不同的类别在输入中变得难以区分。可以评估扩大预算、先检索候选或分层分类,并把额外步骤的成本和漏选计入结果。Laya 迁移约束(https://github.com/NandhaKishorM/laya#self-hosting-http-server-jev-compatible)
这些属于集成与测量问题,不必只靠更换模型规模解决。
十、什么时候需要微调?
先定义预期结果,再观察错误样本。下面几种情况值得尝试领域微调:
新增候选项本身不必然要求重新训练。这类接口在请求中定义候选空间,但新领域能否被正确理解仍需要测量。
Kev 的领域训练通常从已经发布的决策检查点继续,保留已有适配器和读出能力。应记录初始化版本,并同时检查原任务和新任务,避免只优化一个局部指标。Kev 微调说明(https://github.com/jaredpalmer/kev#fine-tune-on-your-own-data)
Laya 作者的公开结果说明,领域训练可以显著改变特定任务表现。是否能得到同样收益,取决于自己的标签、数据量和任务分布。Laya 微调说明(https://github.com/NandhaKishorM/laya#fine-tuning)
数据划分至少分清三个用途:
训练集:更新模型参数。
验证与校准集:选择模型、拟合温度、确定阈值。
测试集:在模型及规则固定后,报告最终结果。
同一工单的改写、同一文档的多个片段,应按来源分组划分,避免训练集和测试集出现几乎相同的内容。业务有时间变化时,可以再留出较新的数据,检查规则和语言漂移。
十一、怎样做一轮有价值的业务比较?
一轮最小评测应该回答:在允许的错误范围内,哪种方案能处理更多业务,延迟和成本是否可接受。
1. 固定业务问题与数据
三者使用相同原始状态、候选项和等级定义。中文、否定表达、多意图、证据缺失及长文本应单独看结果。
第一轮比较发布模型直接使用的效果;后续微调比较则另外注明训练数据量和训练成本。这样才能看出增加的收益来自哪里。
如果规则或现有分类器能处理相同任务,也把它们作为基线。模型方案需要证明相对于现有流程的增量。
2. 同时检查四组指标
| |
|---|
| 分类准确率、Macro-F1、混淆矩阵;评分任务的误差 |
| |
| |
| 端到端 p50 / p95、并发、冷启动、内存和服务费用 |
这组指标与任务目标相关,不能只挑总准确率最好的一行。
3. 在同一错误预算下比较覆盖率
设全部样本数为 N,阈值下自动处理数为 A,其中错误数为 W:
自动处理覆盖率 = A / N自动处理错误率 = W / A (A > 0)
例如,在验证集选择满足错误预算的阈值,然后固定阈值到测试集测量。需要同时报告样本量和区间估计;“本次没有观察到错误”不等于未来错误率为零。
每个模型应使用各自验证过的阈值。比较的是共同业务要求下的效果,而不是让语义不同的 confidence 字段使用相同数字。
4. 把选择和执行分开验收
分类正确只是一个阶段。还要确认候选项符合当前权限与业务规则、工具调用成功,以及最终状态确实改变。
例如,工单被判为账单类,后续成功进入正确队列并被处理,才构成业务结果。退款等状态变更还需要认证、授权和幂等控制。
十二、最后怎样选?
下面是评测起点,不是性能排名:
自部署还要把机器空闲、模型加载、监控、升级和校准维护计入成本。开源权重减少的是服务选择限制,实际推理与运维仍消耗资源。
托管服务则需要评估真实网络路径、可用性、限流和数据传输要求。两种部署方式都应保留固定模型版本的评测记录。
对三个项目,最实用的理解可以概括为:
Jev 提供托管的决策能力;Kev 提供可选择规模的 Qwen 决策模型;Laya 提供较小的编码器决策模型。
>
参考资料
TypeSafe / Jev
Introduction:模型定位与问题类型(https://docs.typesafe.ai/introduction)
Quick start:托管 API 接入(https://docs.typesafe.ai/introduction/quickstart)
AI Primer:RLCD 与概率校准(https://docs.typesafe.ai/introduction/machine-learning-primer)
Primitives:Choice、Score、Noul(https://docs.typesafe.ai/primitives)
API Reference:请求、返回值及数量限制(https://docs.typesafe.ai/api)
Confidence:分布统计量与业务阈值(https://docs.typesafe.ai/confidence)
Kev
作者仓库:模型规模、API及服务性能(https://github.com/jaredpalmer/kev)
模型实现:表示、候选项读出及温度缩放(https://github.com/jaredpalmer/kev/blob/main/kev/model.py)
训练实现(https://github.com/jaredpalmer/kev/blob/main/kev/train.py)
Kev-4B 模型卡:版本与领域评测(https://github.com/jaredpalmer/kev/blob/main/docs/model-cards/kev-4b.md)
Kev-9B 模型卡:新来源评测与微调记录(https://github.com/jaredpalmer/kev/blob/main/docs/model-cards/kev-9b.md)
Kev-27B 模型卡:底座与部署条件(https://github.com/jaredpalmer/kev/blob/main/docs/model-cards/kev-27b.md)
Laya
项目仍在快速更新。复验时记录代码版本、模型检查点、输入模板和实际运行后端,避免把不同版本的数字混在一起。