数字木鱼 TK · 科技观察
AI 写代码,次高思考档为什么在一项评测里赢了最高档?
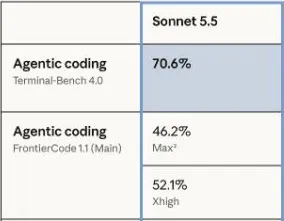
同一个模型做同一项代码评测,只把思考强度再调高一档,分数却低了。Anthropic 9 月 28 日公布的 Sonnet 5.5 数据中,FrontierCode 1.1 Main 主任务集的 Xhigh 档得分为 52.1%,Max 档为 46.2%。次高档高出 5.9 个百分点。
图:Anthropic 官方发布页表格局部,重点看 FrontierCode 1.1 (Main) 行与 Sonnet 5.5 列。
这项评测要看交出的代码能否达到合并标准。分数为何倒过来,还得看它怎样认定一次修改合格。
▌评测看的是“能不能合并”
制定 FrontierCode 的 Cognition 把目标称为可合并性:项目维护者会不会接受这次代码修改。它同时检查正确性、测试质量、修改范围、代码风格和项目规范。Anthropic 在 Sonnet 5.5 发布页的脚注里还说明:这项评测看改动能否无需人工再修改就被合并;即使额外改动有帮助,只要超出任务范围,也会被扣分。
在这样的评分下,多查一遍、多改几处,并不会自动加分。多出的工作仍要留在题目划定的范围里,还要赶上交付时间。
▌Max 多做的审查,为什么可能失分
Anthropic 披露了一个具体路径:Sonnet 5.5 在 Max 档更常运行 Claude Code 的 code-review skill。这个技能会把审查拆给多个子代理。Anthropic 引述 Cognition 检查的两个案例,其中出现超时或超出任务范围的额外修改,结果拉低了得分。
调高档位,在这里不只是让模型把同一步想得更久。它还可能改变后续的工具调用和审查轮次。在这两个案例里,额外审查没有换来更符合验收标准的代码。官方脚注解释了这条具体失分路径;逐题成绩没有公开到足以分摊全部 5.9 个百分点。
▌先定交付,再选档位
Anthropic 把 Claude Code 和 Claude 应用的默认思考强度设为 Medium,Claude Platform 默认设为 High;更高档会花更长时间推理和检查。Max 因而只是可选设置,不是每项任务自动该选的档位。
如果任务要求在规定时间内修改指定范围的代码,先说清完成条件和可改动的边界,再决定是否追加审查。Sonnet 5.5 的这项成绩把选档顺序摆在眼前:先看交付目标,再考虑思考强度,不必机械地开到最高。
资料与说明
本文只比较 Anthropic 公布的 FrontierCode 1.1 Main 同一模型两档成绩;5.9 个百分点为本文相减。两例失分过程由 Anthropic 脚注转述 Cognition 的检查,不是本文独立复测。
Anthropic|Introducing Claude Sonnet 5.5Anthropic|Claude Sonnet 5.5 System Card(第 111 页)Cognition|FrontierCode Leaderboard 与评测方法