AGENT 评测避坑 · 方法论连载 01
你的 Agent 评测,通过率 100%却不可信?
先讲一件真事。
我们给 AI Agent 搭评测体系的时候,曾经跑出过一批通过率非常漂亮的报告——绿油油一片,几乎挑不出毛病。团队一度很欣慰。
直到有个人问了一句:
我们回头一查,冷汗下来了。相当一部分“通过”,是评测系统自己造出来的——不是 Agent 做对了,而是考卷不管考生答什么都是满分。
从那天起我们立了一条规矩:每一条“通过”,都要能回答“它凭什么通过”。
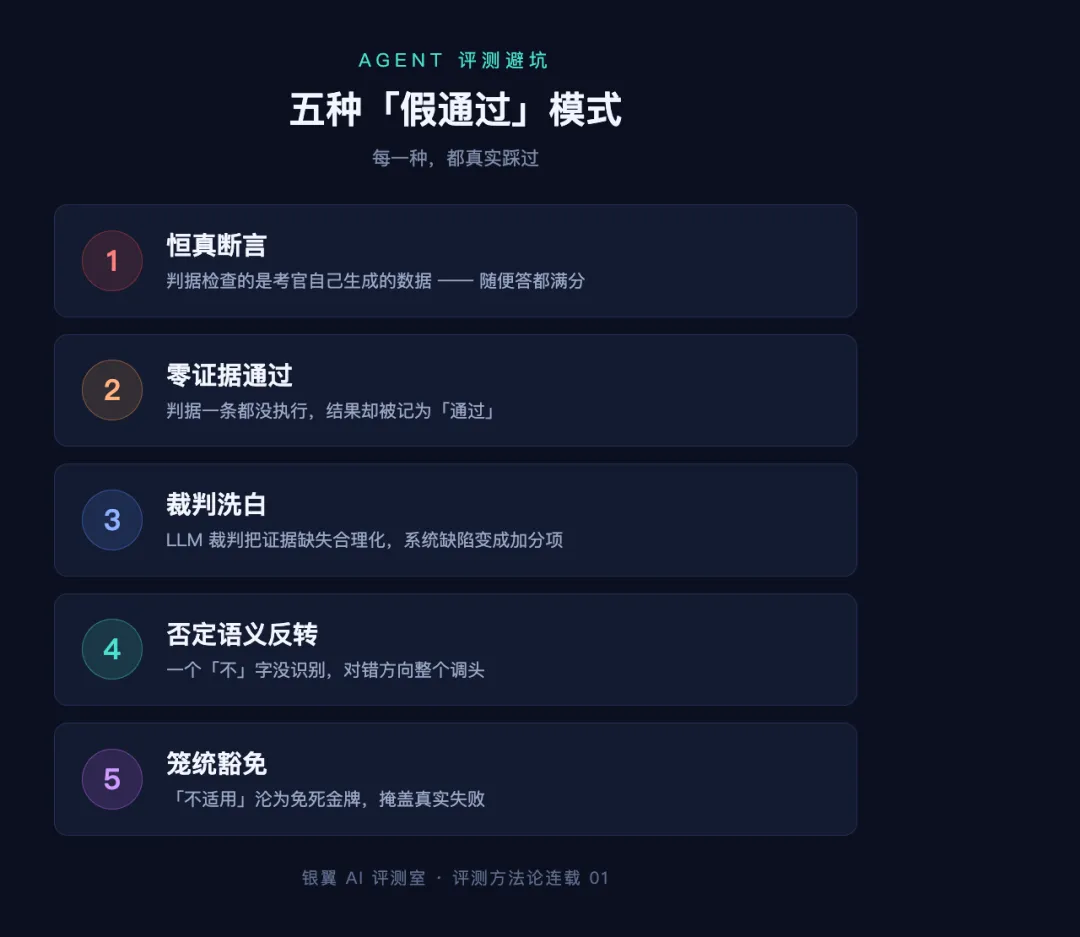
下面这五种“假通过”模式,每一种都对应我们真实踩过的一个坑。直接上案例。
我们给 Agent 配了搜索工具,评测判据里有一条:检查“返回结果是否包含 format、content_len 这些结构字段”。跑了几天,这条判据全绿,一次没红过。
直到我们做了一次突变验证——把被测 Agent 换成一个永远返回空值的假对象,重跑评测。它照样全绿。
排查下来哭笑不得:那些字段根本不是 Agent 输出的,是评测夹具在合成测试数据时自己塞进去的。判据检查的字段集,来自平台自己写的答案——考官批卷用的参考答案,是自己誊的那份。
修法:判据只准读被测对象的真实产物——它调了什么工具、传了什么参数、回了什么话;平台自己写进数据的字段一律作废。并且立了道门禁:每条新守卫上线前,必须先证明“注入违规会变红”——0 命中不能自证清白,脚本坏了和真干净,输出是一样的。
有一次评测框架升级,改了前置条件。升级后跑完,报告里的通过率不降反升——很不对劲。
逐条对账发现:有一批用例的前置判据一条都没有实际执行,但结果栏全写着“通过”。原因是框架的默认逻辑:没有失败记录,就算通过。
这在传统软件测试里勉强成立,因为断言挂了会炸异常。但 AI 评测里,判据可能因为维度不适用、数据缺失、前置不满足而静默跳过——这些“沉默的用例”就被白白计成了通过,通过率凭空抬高。
现在的规矩:零判据,不许通过。一条用例要么有实测依据证明它通过,要么标记“不可判定”退出统计。宁可承认没测到,不能假装考过了。
用大模型当评测裁判很流行。但我们遇过这么一次:平台升级后某类证据没采集到,裁判拿到的上下文里,证据位置是空的。
一个没有纪律的 LLM 裁判会怎么判?它的判词原文大意是:
它不是在作弊——它只是在做它最擅长的事:把模糊的东西圆成合理的东西。而这一圆,平台自己的采集缺陷就被“洗”成了被测对象的加分项。
规矩随之而来:LLM 裁判只做补充判断,永远不能覆盖确定性结论;证据缺失直接标“未测量”,根本不进裁判环节。不让模糊进入评分,更不让裁判替系统还债。
这是最冤的一种。我们有两条评测链路,各自维护了一份否定词表——其中一份,漏收了“不调用”三个字。
于是:Agent 回答“未调用该工具”,判据在整句话里搜“调用”两个字,搜到了,判定——“已调用”。方向完全反转。
更诡异的是,两条链路做过行为等价性检查,结果是绿的。为什么?因为两份词表各错各的,等价性检查对“共同错误”免疫。这也成了我们的一个方法论信条:行为等价不等于正确,单一来源才是。
现在:所有否定判定必须逐个标识符精确匹配,否定词表全网只维护一份。这类 bug 的可怕在于它不报错——错的判成对的,对的判成错的,而通过率看起来一切正常。
我们的评测维度适用性,曾经直接拿“接入类型”来定——走通用接口接入的,就套通用模板考通用维度。
结果出了一类冤案:有产品明明是长时序任务型 Agent,只因为走的是通用接口接入,就被套了通用模板——它最核心的能力维度被判“不适用”,整场考试根本没考它最强的地方,报告分数虚高,而且从统计上完全看不出异常。
修复之后的原则:架构归类显式声明,接入类型只做参考;“不适用”必须由客观前置条件触发,不能由结果反推;可评维度少到一定程度,整份评测直接标“不可判定”。以及那条铁律:“不适用”永远不许用来掩盖真实的失败——配了工具却没调用,是失败,不是不适用。
五种模式摆在一起,你会发现一个共同点:
它们都不是“评测错了”,而是“评测系统在无意识地美化结果”。
传统测试讲“开发者不能自己测自己”,AI 评测要多一条:评测系统也不能默认自己是诚实的。每一个绿灯都需要审问出处。
如果你只记住一句话,记住这句:通过率不会告诉你评测可不可信,“它凭什么通过”才会。
银翼 AI 评测室 · 评测方法论连载 01
愿所有 Agent 都经得起 Voight-Kampff 测试。