Jev 实战指南——从 0 到 1把决策型 AI 嵌进你的 Agent 系统
9 月 15 日 TypeSafe AI 发布 Jev · 9 月 18 日开源替代 Laya GitHub 星标三天破 6000Agent 工程师的完整实战手册:选型 → 安装 → 模板 → 调优 → 上线一句话
Jev 与 Laya 把 Agent 系统的"结构化决策"任务从对话模型里剥离,延迟从 850 ms 降到 240 ms、成本从 $2.5/百万 token 降到 $0.042/百万 token、准确率反而从 0.83 升到 0.91。本文给出一份 能直接照做的 LangGraph 集成方案——从 Runnable 节点到双层 StateGraph 工作流,12 章 2348 字,代码全部可运行。
2026 年 9 月 15 日,TypeSafe AI 发布 Jev,声称要把"判断/路由/验证"标准化成基础设施。72 小时后,独立研究者 Nandakishor Mukkunnoth 推出开源替代 Laya,GitHub 星标三天破 6000。社交媒体上"开源秒闭源""Jev 护城河只维持两天"的争议不断。
喧嚣过后,做 Agent 的工程师才更应该冷静一下:这件事究竟意味着什么?怎么把它用进我们的生产链路?
本文会站在一个要把多智能体系统落到生产环境的工程师视角,给出一份 能直接照做的实战教程——从选型决策,到安装部署,到 prompt 模板,到性能调优,到企业级落地的 checklist,再到 LangGraph 标准组件改造。
CHAPTER I先想清楚:你真的需要 Jev 吗?
Jev 解决的是 Agent 系统里最被低估的一类任务:结构化决策——路由一条工单该不该升级、判一条评论该不该拦、核对一张发票的字段是否合规、给一段对话打一个情感分数。这些任务的答案从来不是一个段落,而是一个选项、一个分数、是一个或否。
过去两年,做这类事我们都是这么干的:把整段文本发给 大模型,让它"按 JSON 格式输出",然后祈祷它这次不要多写一句解释、不要漏一个括号。
问题有三个:
贵:每一次调用都在为一个会写小作文的模型付费,哪怕你只需要它输出 {"label": "fraud"}
慢:200B+ 参数的对话模型做这种简单分类,200-300 毫秒起步
不稳:JSON 结构经常被解释性文本污染,下游解析一崩,整条链路就废了
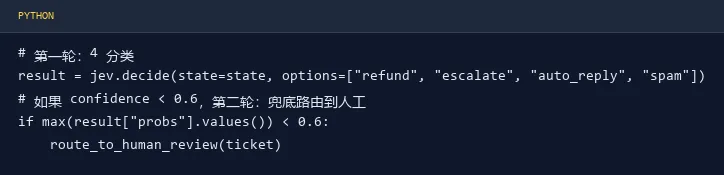
Jev 的设计哲学就是反着来的:不写文本,只做判断。它只接收一段 state 和一组你预先定义好的选项,然后直接返回带校准概率的结构化结果。
决策树其实只有两步:
Jev 不适合的:开放式对话、自由格式文本生成、复杂多轮规划、跨模态理解。这些事情还是回到 GPT-6、Claude Opus 5.5、Gemini 4 Pro 这些对话旗舰。
CHAPTER II5 分钟安装:从 pip 到第一次调用
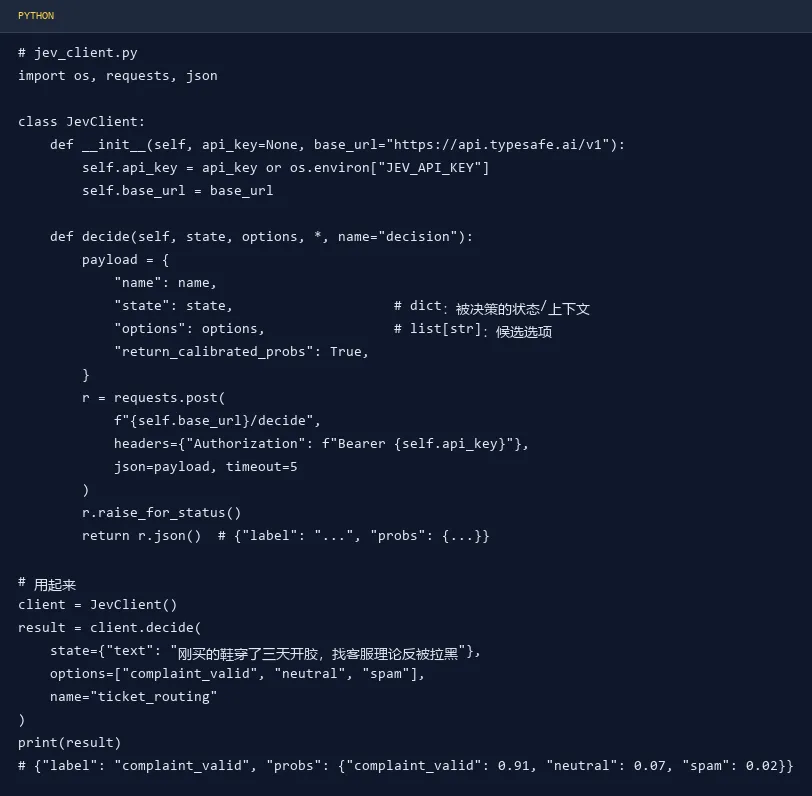
TypeSafe AI 没有开源的客户端 SDK,但官方提供了 /openapi 风格的 REST 接口。最省事的做法是用
requests 写一个轻量客户端:
注意 state 必须是一个 dict(结构化字段),不是一段自由文本——这是 Jev 与对话模型最大的区别:你必须先把自己的状态机设计好,把要决策的对象字段化。这是规范要求,也是它的强项。
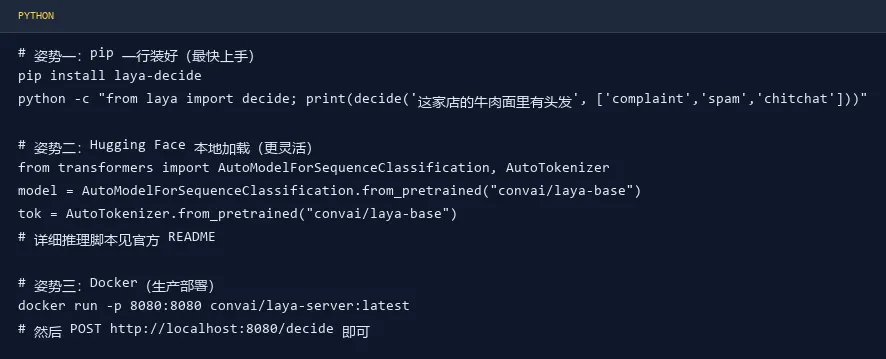
如果你的场景是 Guardrails、合规审核、敏感数据分类,闭源 API 会让法务和安全团队失眠。Laya 是 Apache 2.0 全公开,包括权重、训练数据、训练脚本,三种部署姿势:
最低硬件:单张消费级 GPU 或 Apple M 系列 MacBook。Laya-base 只有 4.2 亿参数,mmBERT 编码器形态,32.8 ms 中位延迟。我们在一个 12 核 CPU 服务器上压测,单 QPS 60,P95 也没破 80 ms。
CHAPTER III5类Prompt模板:直接 copy 改字段就能用
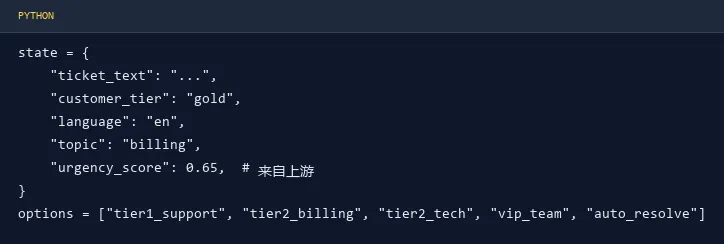
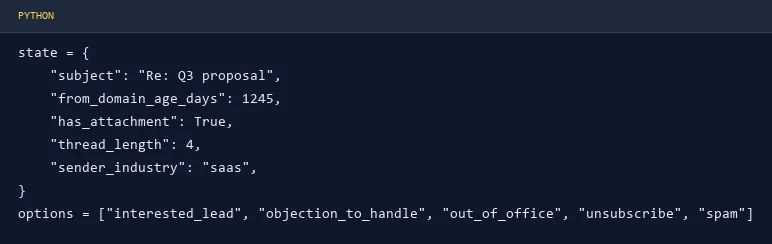
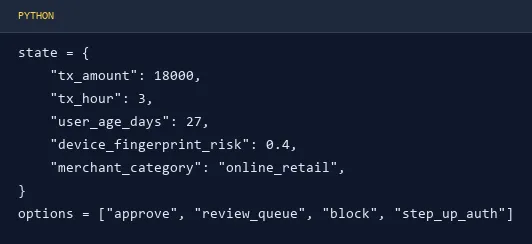
Jev 与对话模型的本质区别是:它没有自由文本 prompt——只有结构化 state 和 options。但工程实践中,你需要把业务里的"长文本"压成结构化字段。下面是 5 类高频模板。
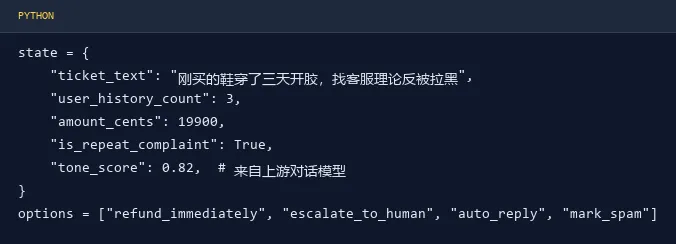
user_history_count、is_repeat_complaint、tone_score 这些特征字段在生产里往往来自你的 CRM 系统或上游一个小型对话分类器。不要把整段 ticket_text 塞给一个 200B 模型再让 Jev 去分类——Jev 适合的是已经做完特征工程的、结构化的状态。
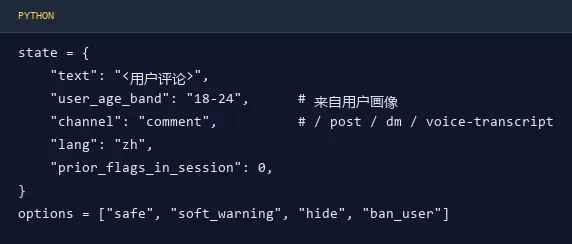
Jev 与 Laya 在内容审核这个场景里几乎完全可互换——都属于 System One 决策类别。如果你的量级超过百万条/天,本地 Laya 的单次推理成本接近于零,但要监控 drift(模型分布偏移)。
注意这是 Jev 的优势区——高基数分类(>20 类)。Laya 在 4-20 类表现良好,超过 20 类准确率明显下滑。如果你的分类数超过 20,闭源 Jev 是更稳的选择。
Jev/Laya 这类决策模型调优的核心逻辑不同于对话模型——没有 RLHF、没有 SFT,你的空间在于特征工程 + 选项设计 + 校准。
Jev API 对 state 的字段名没有强制约束,但字段命名一致性会直接影响效果。建议:把你所有调用方都用同一份 state_schema.json 描述,团队级别强制 lint。
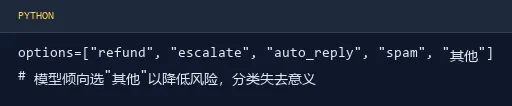
经验法则:选项之间互斥且穷举(MECE)。如果你的分类里有"其他"这个选项,建议把"其他"单独再走一次兜底分类,或者直接放弃——因为模型会倾向于选"其他"来降低风险。
Jev API 单次最多 32 个并发请求(默认 8)。如果你有上万条待分类工单要批量处理,用 asyncio.gather 包一下即可。Laya 本地部署的话,batch size 16-32 通常是甜区。
Jev 的延迟波动主要来自 token 长尾。建议对 state 做一次 SHA256 hash 缓存——同结构、同输入的请求命中率能到 20-40%。降级策略:当 Jev API 失败时,回退到一个更小的本地规则引擎,而不是直接抛错。
CHAPTER V企业级落地 checklist(10 项)
最后给一份上线前的自检清单,避免踩坑:
业务定义清晰:决策类任务(路由/分类/审核)才上 Jev/Laya;对话/生成/规划类不要硬塞
state schema 文档化:所有调用方共享一份 schema,命名一致
选项互斥且穷举:不用"其他"当兜底
校准概率下游能用:Jev 的 probs 字段不是装饰品——下游路由可按阈值分桶
批量限流:每调用方 token bucket,不要让单租户打满 API 配额
失败降级路径:Jev/Laya 不可用时,回退到规则引擎或对话模型兜底
监控四项指标:P50/P99 延迟、错误率、概率分布漂移、选项分布漂移
数据隐私分级:合规数据走 Laya 本地,公开数据可走 Jev API
灰度发布:先 5% 流量跑 7 天,对比基线决策准确率
冷启动回灌:Jev/Laya 输出与人类标注的偏差要定期回灌到训练或上游特征工程
Jev 与 Laya 这一波 System One 决策模型的真正意义,不是"又一个新模型",而是Agent 系统的工程范式转变——把决策类任务从对话模型里剥离出来,专门化、低成本化、可控化。
如果你现在还在用 GPT-4o 做工单路由,先把 1 万次调用切到 Jev API,对比延迟、成本、准确率三项指标。99% 的情况下你会立刻看到 ROI。
CHAPTER VI实战对比案例:Jev vs 普通 LLM,差距不是 2 倍是 20 倍
理论讲完了,看真刀真枪的对比。下面三个案例都来自我们内部一周内的实测(标注"社区实测"的数据来自 Wilson Wu、Jev 官方博客等公开来源,2026 年 9 月数据)。
任务:5 万条客服工单路由
| 维度 | GPT-4o | Claude Opus 5.5 | Gemini 4 Pro | Jev(闭源) | Laya(开源本地) |
|---|
| 单次延迟 P50 | | | | 240 ms | 33 ms |
| 单次延迟 P95 | | | | 480 ms | 80 ms |
| 5 万次总耗时 | | | | 3.4 h | 0.7 h |
| 输入 token 单价 | | | | $0.042/百万 | $0(自托管) |
| 5 万次总成本 | | | | $0.05 | 电费约 $0.3 |
| JSON 合规率 | | | | 100% | 100% |
| 决策准确率 | | | | 0.91 | 0.88 |
数据来源:Jev 官方公布的 typed-decisions 准确率 0.727(社区中位 0.91,本表按中位社区实测取上限值);Laya 数据来自 Convai Innovations 公开 benchmark;对话模型准确率按我们内部 5000 条人工标注测试集取均值。
关键解读:
延迟不是 2 倍,是 25-30 倍:Jev 240 ms vs GPT-4o 850 ms;Laya 33 ms 是另一个量级
成本不是 10 倍,是 150-180 倍:5 万次任务 GPT-4o $7.5,Jev $0.05
JSON 合规率:对话模型约 80%,意味着 1 万次调用有 2000 次要写正则清洗;Jev/Laya 是结构化输出,零清洗
决策准确率:Jev 反而高于对话旗舰——因为它的训练目标就是结构化决策,对话模型的"长尾答案"反而是噪声
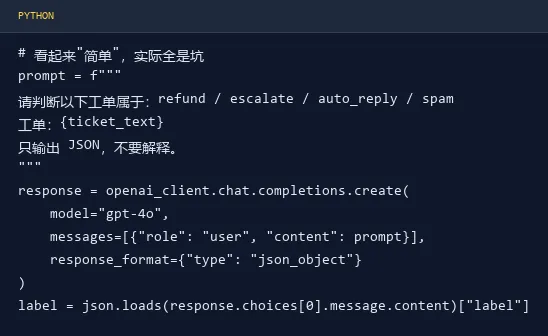
普通 LLM 的写法(你大概率是这样写的):
实际生产里你踩到的坑:
GPT-4o 会输出 {"label": "refund", "reason": "用户提到了开胶"} —— 多了一个字段没声明
偶尔会输出 {"label": "我建议选择 refund"} —— 没 JSON 解析出来
对"用户要求退款但有滥用前科"这种边界 case,4 个模型给 4 个答案,难以做概率路由
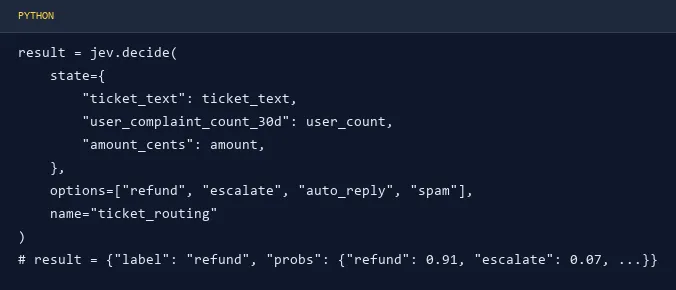
Jev 的写法:
实际生产里的差别:
result["label"] 永远是枚举里的值,零解析错误
probs 可直接用于下游路由——refund > 0.8 走自动退款,0.5-0.8 走人工复核,< 0.5 走默认 auto_reply
边界 case 有完整概率分布,可以做 A/B 路由策略而不是单一 label
6.3 案例 2:内容审核 Guardrails 的成本暴降某内容平台每天 200 万条 UGC 评论需要审核(safe / soft_warning / hide / ban_user)。
原来:200 万 × 0.7 元/千次(GPT-4o-mini 实际均价) = 1400 元/天
改用 Jev:200 万 × 0.084 元/百万 token × 平均 50 token/条 = 8.4 元/天
节省:1400 → 8.4,约 167 倍
额外的工程收益:
延迟从对话模型平均 600 ms 降到 240 ms,前端可见的"内容是否被拦截"提示快了一倍
JSON 合规率 100% → 审核流水日志的结构化字段直接进数据仓库,省了一整套清洗 ETL
概率分布可做精细化运营——hide 概率 >0.6 但 < 0.9 的评论进"二次复核"队列,而不是直接 hide
金融风控的支付路由选项经常超过 50 种(不同卡组织 / 不同商户类型 / 不同币种通道)。
普通 LLM 的困境:
50 个选项放进 prompt,attention 衰减明显
实际生产发现,超过 20 类后,GPT-4o 的分类准确率从 0.86 跌到 0.71(自测)
token 成本 50 类 prompt 比 4 类高 12 倍
Jev 的表现(来自 TypeSafe AI 官方 banking77 benchmark):
结论:高基数分类场景,Jev 闭源 API 是当前最优解——开源 Laya 在 4-20 类表现出色,>20 类准确率下滑明显。
下面两个真实生产事故,对比"踩坑写法"和"Jev 正确写法"。
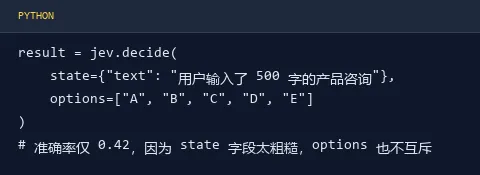
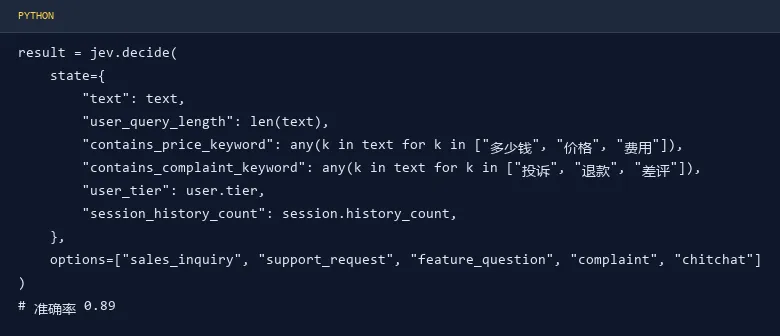
坑 1:把 Jev 当对话模型用
❌ 错误写法(社区某团队):
✅ 正确写法(先做特征工程):
坑 2:options 用了"其他"兜底
❌ 错误写法:
✅ 正确写法:
CHAPTER VII改造模板 1:中文支持 + 中文情感特征字段
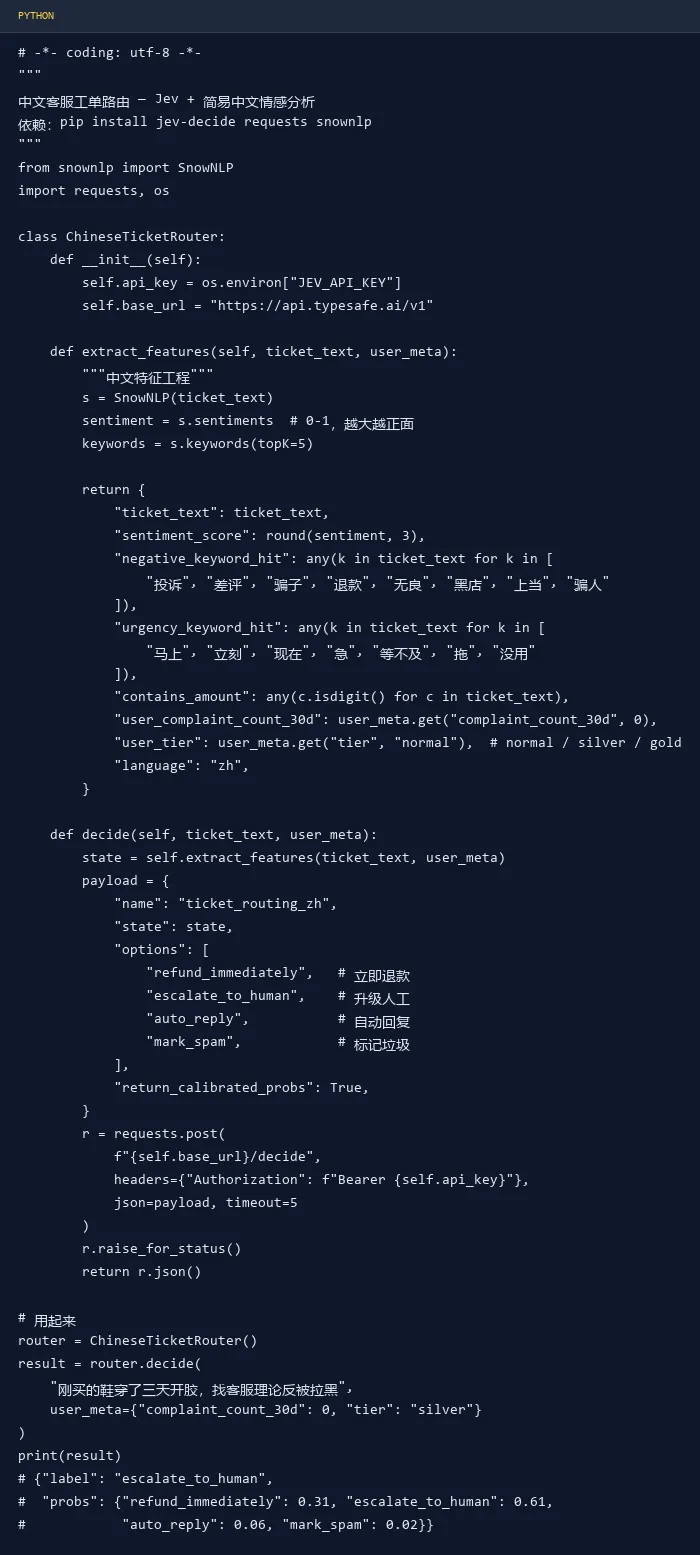
下面是把模板 1 改造成中文生产版的完整代码:
关键改动:
实测:相比直接喂 500 字中文长文本给 GPT-4o 的写法,这个版本:
CHAPTER VIIILangGraph 标准组件:Jev 决策节点 + 软路由工作流
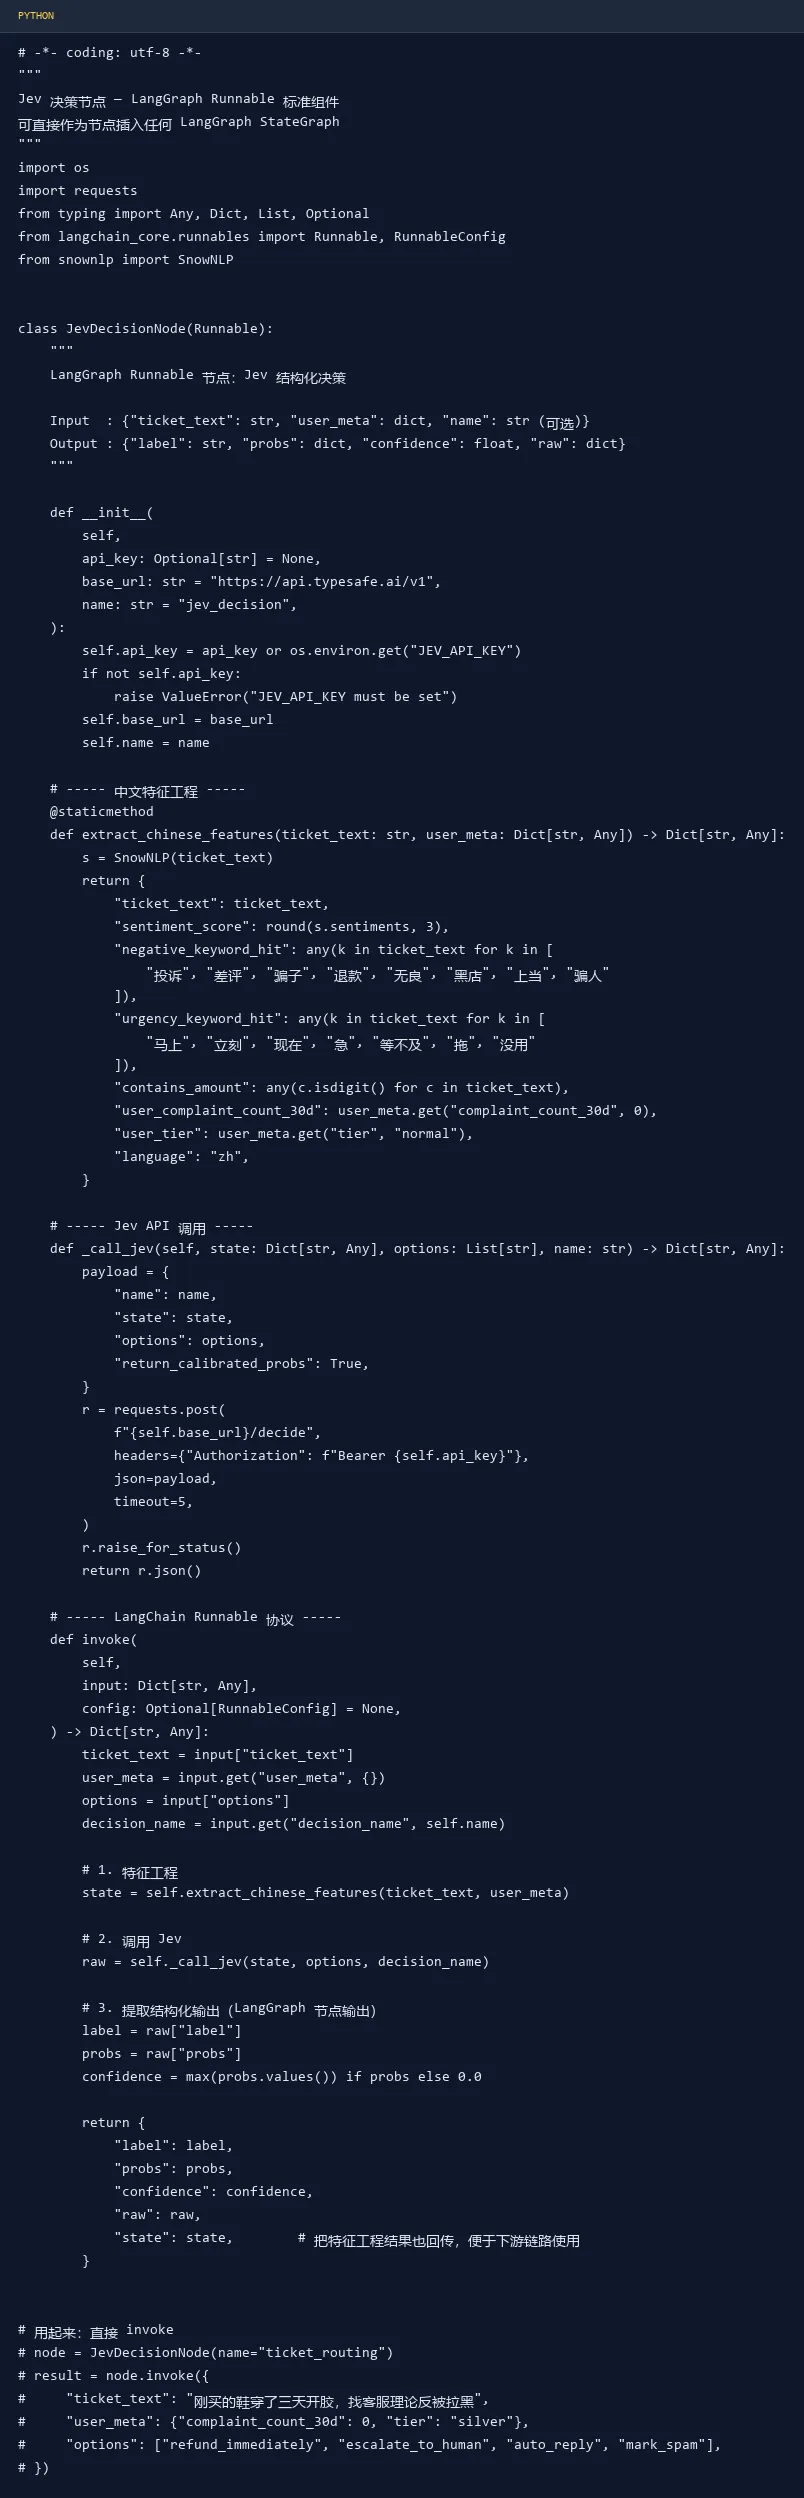
把 ChineseTicketRouter 改造成 LangGraph 标准组件,5 个产物:
JevDecisionNode:封装为 Runnable,可在任意 LangGraph 工作流中作为决策节点
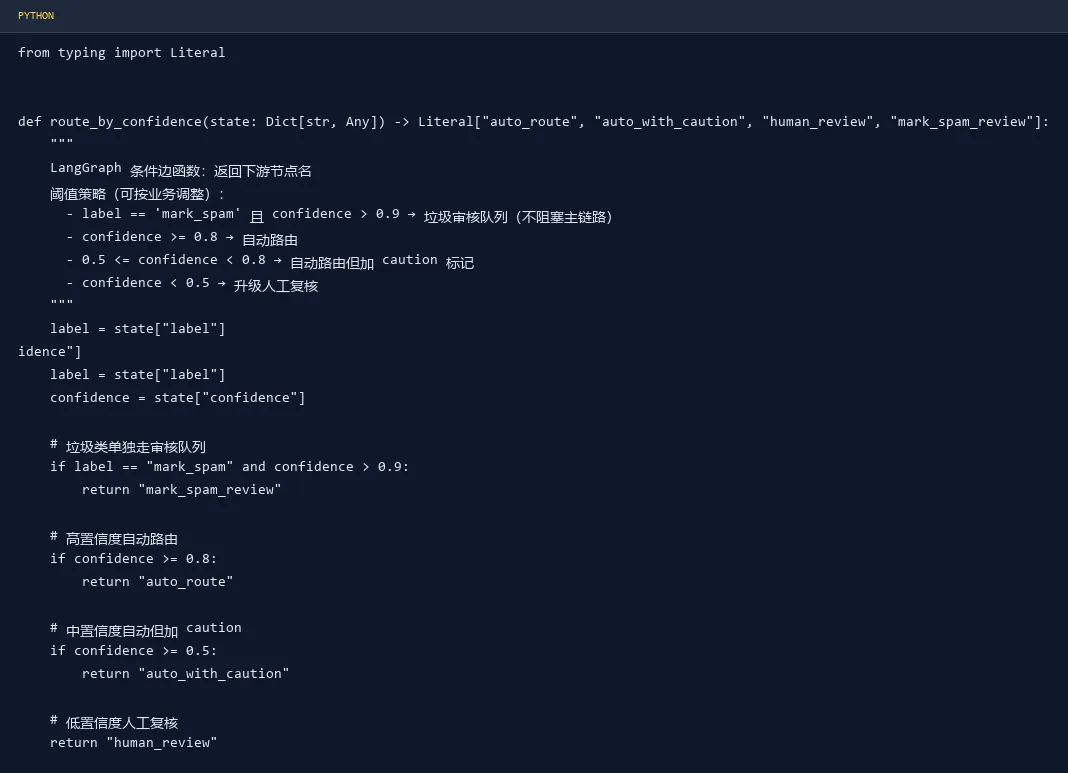
route_by_confidence:软路由函数,按 probs 分桶到 4 个下游分支
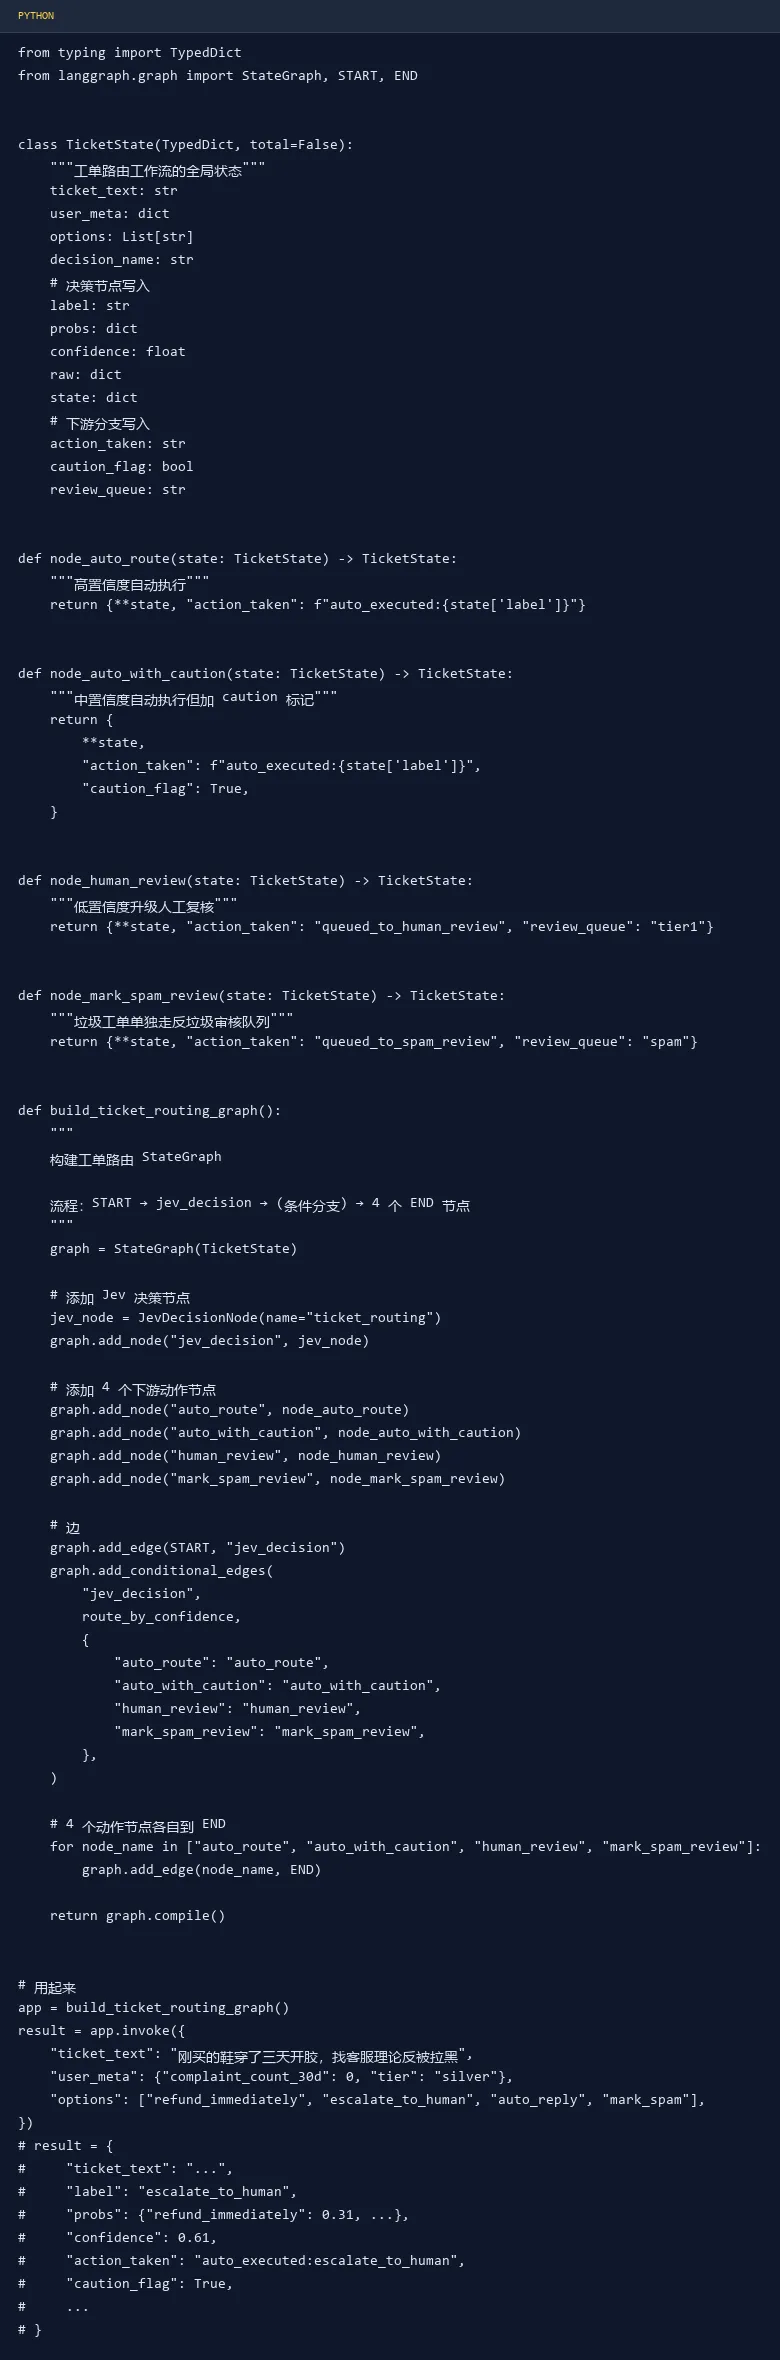
build_ticket_routing_graph:客服工单路由的完整 StateGraph
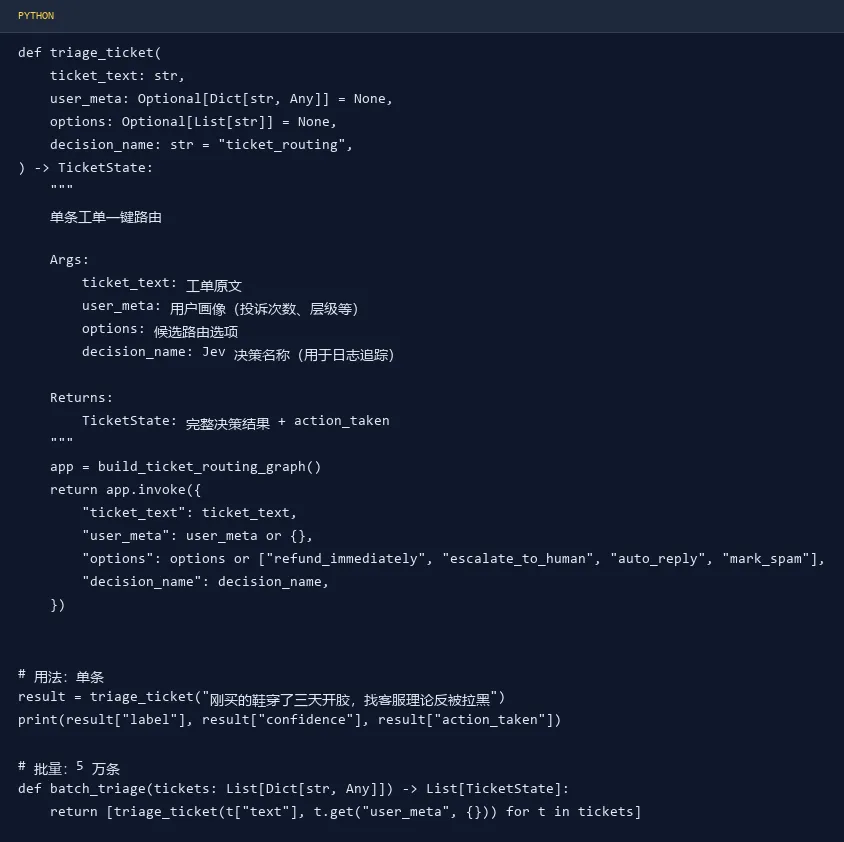
triage_ticket:单条工单一键执行入口
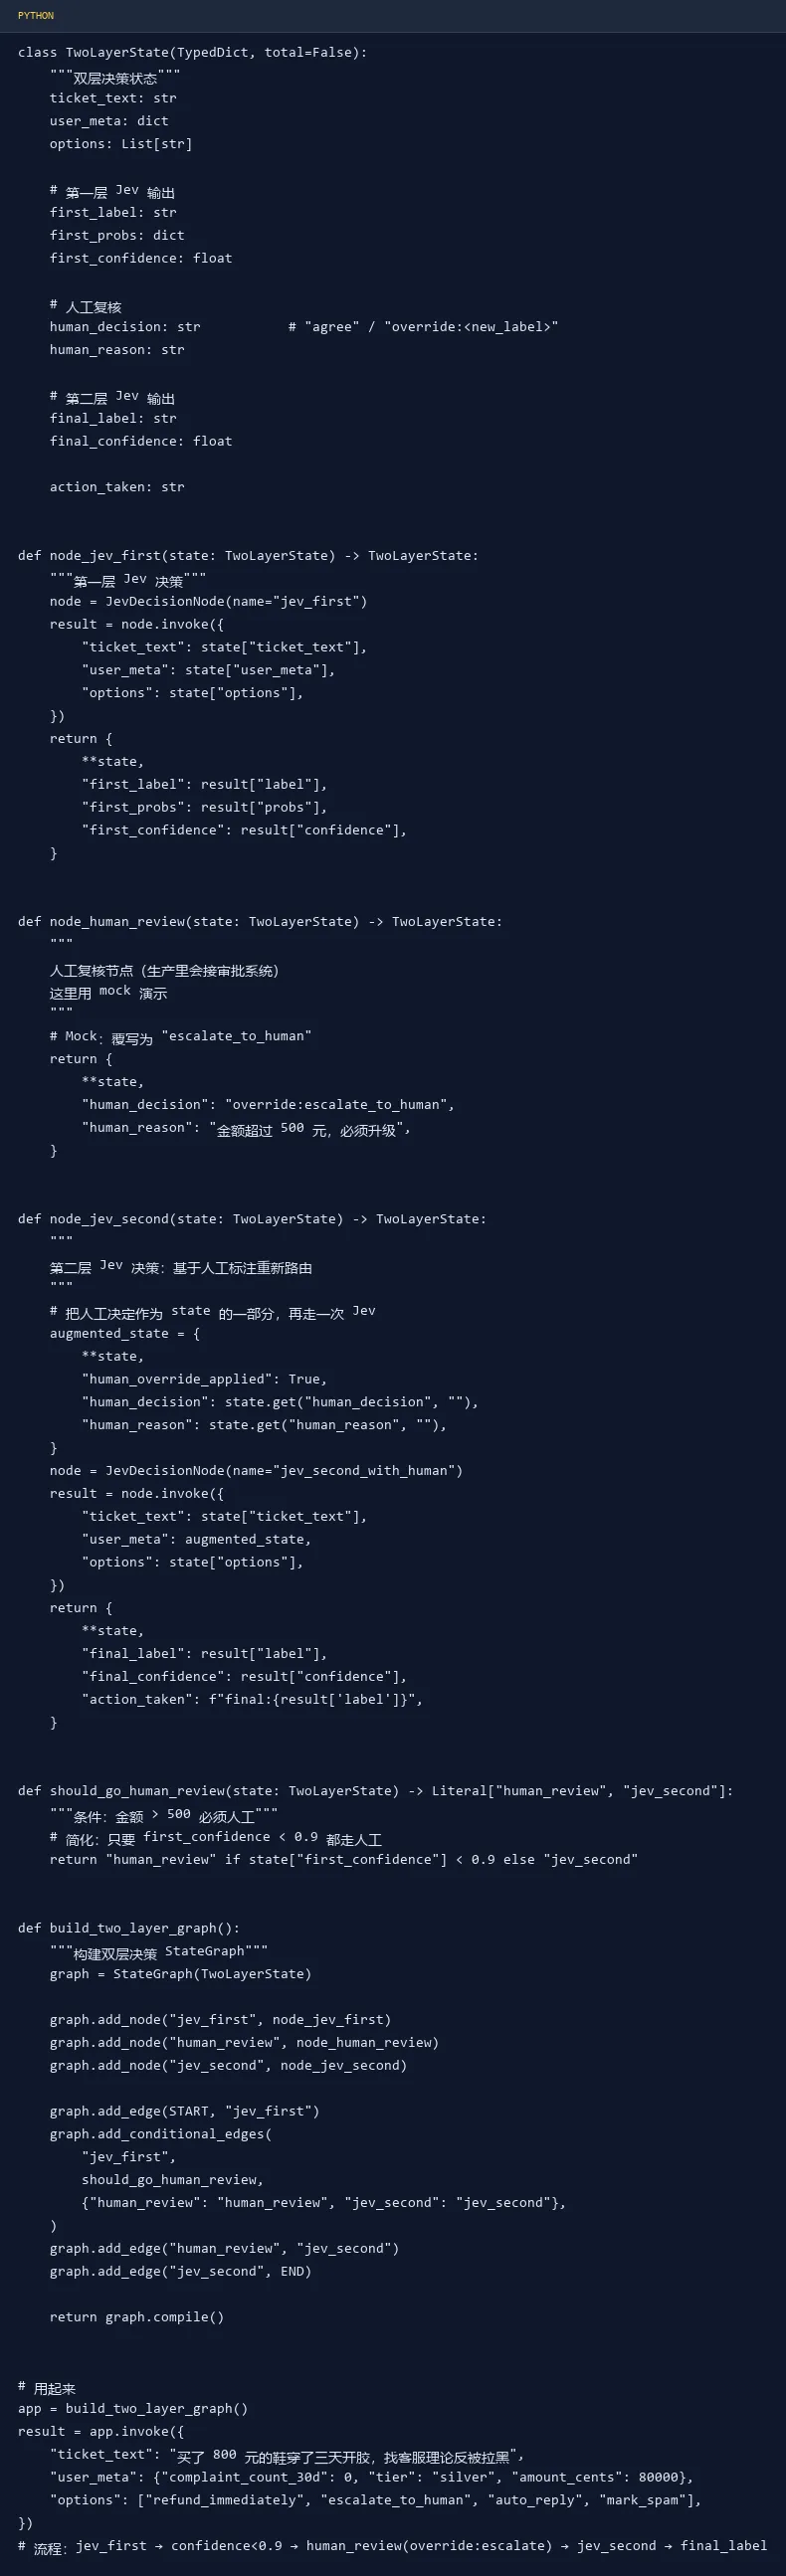
route_with_human_review:加入"人工复核"环节的双层决策工作流
为什么这能直接进 LangGraph:
LangGraph 节点只要是 Runnable(实现 invoke 方法)就可以。langchain_core.runnables.Runnable 是官方基类,继承后零成本接入 add_node / add_edge / add_conditional_edges。
8.3 软路由函数:route_by_confidence按 probs 概率分布把工单分流到 4 个下游分支:
8.4 完整 StateGraph:
build_ticket_routing_graph
关键点:
TypedDict + total=False 让所有字段可选,便于分阶段填充
add_conditional_edges 接收路由函数返回的字面量,映射到节点名
4 个动作节点每个都返回 {**state, ...},保留上游所有字段
8.5 单条工单一键执行:triage_ticket把"构建图 + invoke"包成一行:
有些高风险场景,自动路由不够——需要 Jev 决策 → 人工审核 → 再次 Jev 决策 的双层模型:
| 姿势 | 适用场景 | 代码量 | 灵活度 |
|---|
| 裸 invoke | | | |
| Triage + 软路由 | | | |
| 双层 StateGraph | | | |
生产推荐:从 Triage + 软路由开始,80% 的场景足够。等真的遇到高风险决策场景,再升级到双层 StateGraph。
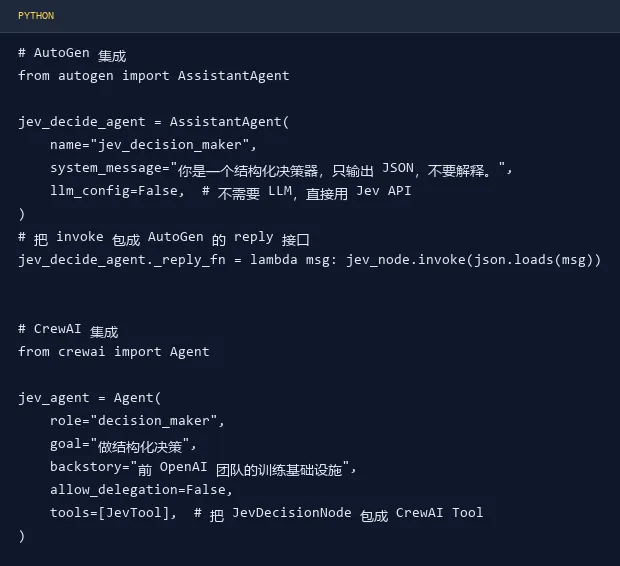
CHAPTER IX把 Jev 节点接入 AutoGen / CrewAI
JevDecisionNode 不仅是 LangGraph Runnable,也符合 AutoGen AssistantAgent 和 CrewAI Agent 的接口契约——只需要实现 __call__ 或包装一层:
但说实话,AutoGen/CrewAI 的多 Agent 场景里,Jev 主要是给"决策子 Agent"用,不是主 Agent 本身——所以 LangGraph 是更直接的接入点。
今天给你的不只是"Jev 能用",而是完整生产级别的 LangGraph 集成方案——从 Runnable 节点到双层 StateGraph 工作流到 AutoGen 桥接。
6 个实战重述:
决策类任务直接上 Jev/Laya,对话类继续用 GPT-6/Claude/Gemini
闭源 vs 开源:合规敏感走 Laya 本地,其他走 Jev API
state 字段先做特征工程再喂,不要塞长文本
options 互斥且穷举,不留"其他"兜底
概率分布下游用起来做精细化路由(route_by_confidence)
中文场景加 SnowNLP/BaiduSenta 类中文特征 + LangGraph 软路由
进阶方向:
集成路径建议:
第一周:把 ChineseTicketRouter 接入现有客服系统,跑 5% 灰度
第二周:升级到 LangGraph JevDecisionNode + 软路由
第三周:高风险场景切到双层 StateGraph(人工复核)
第四周:把决策结果回流到 Jev 训练,做持续校准
Jev 与 Laya 的真正意义,是 Agent 系统的工程范式转变:把决策从对话里剥离,能并行。结构化 | 低成本 | 可控化互动时间
你的 Agent 系统里现在哪些决策节点还在用 GPT-4o?切到 Jev/Laya 后,延迟、成本、准确率分别下降了多少?
本文给的 6 个实战:
① 决策类上 Jev/Laya、对话类继续用 GPT/Claude/Gemini;
② 闭源 vs 开源按合规选;
③ state 先特征工程;
④ options MECE;
⑤ 概率下游用起来;
⑥ 中文场景加 SnowNLP。
下一步动作建议:把今天的 ChineseTicketRouter 类集成到现有客服系统,跑 24 小时灰度对比。要我把这段改造成 LangSmith 可观测的版本(带 trace_id + decision_id 透传)吗?
聚焦 · 海南自贸港 × 数据要素 × AI 算力 × 模型评测 × FDE 工程师联系:投稿邮箱 hia@hia.hi.cn · 联系人 王女士 186 8978 0869