澳鹏在关于视频理解模型评测的分享中给出一个判断:模型在单帧图像上的高准确率,常被直接等同于对整个视频的正确理解,但这两件事并不等价。评测分数与实际表现之间的差距,根源在于证据采样和评分权重两个断层。
如果只看总分,评测报告很难回答一个更基本的问题——分数是怎么来的。下面把这两个断层拆开,并给出一份可审计评测流水线应包含的环节。
关键帧选错,推理就建在错位证据上
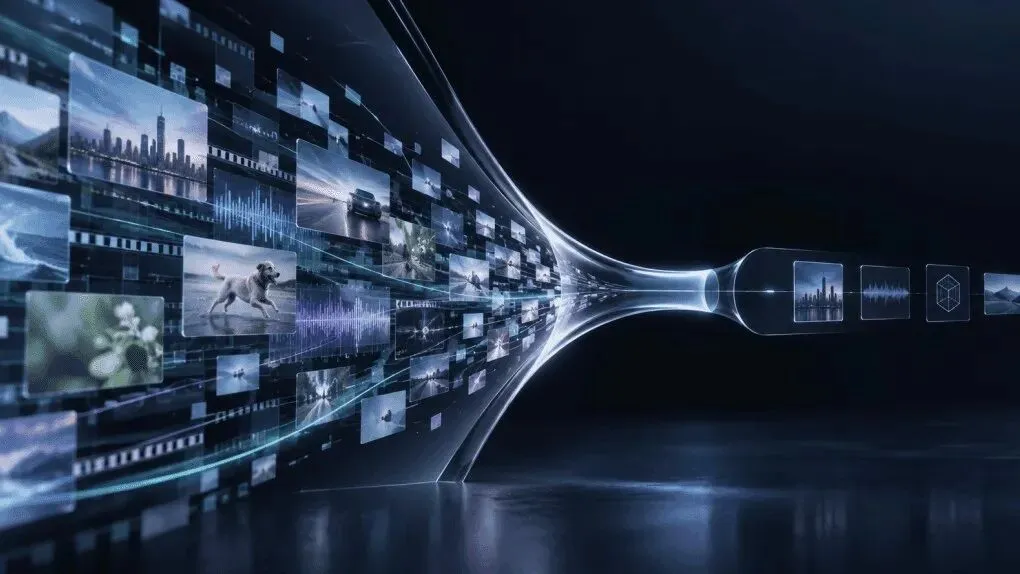
VLM通常不直接处理完整视频,而是分析一个高度压缩的版本,例如少数关键帧。如果这些帧没有捕捉到核心事件,后续推理就建立在错位的证据之上。这正是评测高分与实际表现产生差距的根源。
图|澳鹏干货 VLM评测的盲区高分 理解
任何视频评测的首要环节是证据提取:如何从数万帧画面中找到真正重要的那几帧。T*研究团队提出的“长视频Haystack问题”描述的正是这一挑战,其发布的LV-Haystack基准包含3,874个人工标注实例,用于衡量关键帧搜索的质量与效率。
结果并不乐观。此前最先进的关键帧选择方法在LVBench子集上的时序F1分数仅为2.1%,意味着绝大部分关键证据在评测开始前就已丢失。TimeSearch-R方法通过端到端的自验证强化学习训练搜索策略,将时序F1分数提升至8.1%,是此前水平的3倍以上,但绝对值依然很低。
Neptune研究也指出,许多长视频基准测试仅凭少数关键帧答对,无法真正检验模型的时序理解能力。换句话说,答对不等于看懂了时间顺序。
评分细则被当成一份错误清单
第二个断层在评分环节。VLM在评分时容易走向“细节最大化”,通常把评分细则视为一份详尽的错误清单,并给每个项目大致相同的权重。而人类判断是重点加权,围绕沟通的充分性来组织评价。
因此,评分标准的设计本质上是在定义一个权重函数:明确何种错误是关键、必须扣分,何种细节是次要、可以忽略。这种判断无法从图像本身推断,只能来自任务规范和校准数据集。
澳鹏的实践经验是,在关键决策边界引入人类评审专家,能有效纠正VLM过度关注局部细节的倾向,使评分更贴近实际使用场景中的质量判断。这里的人类介入不是补漏,而是校准权重。
把评测拆成可审计的流水线
解决VLM评测困境,需要把它视为一个系统工程。合理的评测流水线应包含:提取结构化实体、属性、动作、状态变化和时间戳;针对要评分的具体准则检索相关证据;对多个维度分别打分;对检测到的错配应用显著性权重;将模棱两可或高影响案例转交人工裁决。
在此框架下,不同层级的问题才能被有效识别。例如引入多层次评估区分不同粒度的错误,对检测到的错配进行显著性加权,并在评测链路中加入人工裁决环节。
澳鹏在构建多模态评估数据集时发现,评测指标的选择至关重要。总体一致率的意义有限,必须分别报告精确率、召回率,按错误类型分析误报率,跟踪人工覆写率及其方向,并增加严重性加权一致率和局部-全局分歧率。
这些数据还应进一步按视频时长、状态转换数量等维度分层分析,以精准定位评测系统的具体弱点。单一总分无法暴露这些分层差异。
混淆矩阵区分两类不同的错
当评测系统出错时,混淆矩阵可以区分阈值偏移和类别混淆。阈值偏移可通过重新校准修复,也就是调参;类别混淆则需要从评分标准设计或模型训练层面进行修改。两类错误的修复路径完全不同。
一份可靠的评测报告,不仅应报告通过率,更应报告分数是如何达成的:证据是否完整、权重是否合理、判断过程是否可审计。
总体一致率的意义有限,必须分别报告精确率、召回率,并按错误类型分析误报率。
需要说明的是,上述时序F1数字来自特定基准和特定方法,不能直接外推为通用采购或验收指标。LV-Haystack的3,874个实例、LVBench子集上的2.1%与8.1%,都是在各自实验条件下测得的结果。
哪些维度该加权、人工裁决该设在哪个阈值,仍取决于具体任务规范,资料并未给出统一答案。澳鹏在多模态评测实践中将人类判断与系统化评估相结合,但这一框架在不同视频类型上的适用性,尚未被完整验证。
项目合作正在推进数据采集、标注或模型评测?打开公众号菜单“联系慧链”,告诉我们数据类型、规模和交付时间。