第一次 GEO 诊断,品牌到底要做什么?
当用户开始直接问 AI 而不是搜网页,品牌在 AI 回答里的位置,正在变成新的货架。
越来越多品牌开始关注 GEO。但真到要动手时,很多团队卡在同一个地方:
不知道第一次该做什么,也不知道从哪看起。
有人上来就买监测工具,有人花大价钱做内容铺设,更多人是看了几篇文章就开始摸不着头脑——问题池怎么定?平台选哪几个?什么样算"被 AI 推荐"?
其实第一次 GEO 诊断不复杂,核心只做两件事:拿到 AI 的回答,然后从回答里找问题。
这件事可以人工做,也可以用工具做。这篇文章把我们在实操里跑通的方法完整讲一遍,品牌方照着做,就能完成属于自己的第一次诊断。
01 | 第一次诊断,只做两件事
很多人把 GEO 诊断想得太复杂。其实第一次动手,目标非常朴素:
第一件事:拿到 AI 的回答。也就是在目标用户真实会问的问题下,把主流 AI 平台的回答完整跑一遍。
第二件事:从回答里找问题。看品牌有没有被提到、说对了没有、有没有被推荐、AI 引用了谁、竞品凭什么进了答案。
路径上有两条选择:
人工诊断——不需要复杂系统,一份问题清单、一张记录表、几个目标 AI 平台就能开始。适合第一次跑通流程、问题数量在几十个以内的品牌。
工具诊断——用 GEO 监测工具批量跑问题、批量看结果。适合问题池已经比较大、需要长期跟踪的品牌。
第一次我们建议从人工开始,因为只有自己亲手跑过一遍 AI 回答,后面用工具时才知道该看什么、该怀疑什么。
02 | 人工诊断,先准备三样东西
人工诊断不需要采购任何系统,开工前凑齐三样东西就够:
一份问题清单。确定要测哪些核心问题。问题池可以先拉长,但第一次诊断只挑最近要攻坚、要重点做的那部分。
一张记录表。把每次 AI 回答的关键信息结构化记下来,后面要复盘、要对比、要追踪变化,全靠这张表。
几个目标 AI 平台。优先选你的目标用户真正在用的平台,平台不用贪多。
清单、记录表、目标平台——三件事凑齐,诊断就能开工。
03 | 第一步:把测试范围定清楚
开始跑测试之前,先花十分钟把这五件事定下来,不然后面每一轮都会乱:
测哪些核心问题?问题池可以大,但第一次只选最近要攻坚、要重点做的问题,一条一条测。
选哪些 AI 平台?平台不用太多,优先目标用户常用的那几个。
观察哪些具体产品?要不要盯着某几款 SKU 看,提前明确。
记录竞品情况?同步记录竞品出现在哪些回答里、以什么身份出现。
用哪种回答模式?测试时采用哪种回答模式,前后保持一致。
04 | 跑测试时,守住六个动作
这一步最容易"随便跑跑就完了",但测试不规范,后面的数据全废。六个动作必须守住:
1. 用完整、自然的用户问题。不要把问题压缩成关键词,要像真实用户那样完整提问。
2. 每次开独立的新对话。防止上一轮上下文影响下一次回答。
3. 同一个问题多测几次。看 AI 的回答是否稳定,多次测试才有统计意义。
4. 回答模式尽量保持一致。同一平台、同一口径下测试,结果才可比。
5. 保存完整回答和引用来源。别只截个图,完整文本是后面分析的基础。
6. 记录平台、时间和测试轮次。让每一次测试可定位、可复测、可对比。
05 | 最容易踩的坑:问题里别加品牌名
这是新手最容易犯的错,必须单独拎出来讲。
如果你想测的是"品牌能不能被 AI 自然推荐",那问题里千万不要主动出现品牌名。
应该问:"两个月幼猫适合吃什么猫粮?"
不要问:"两个月幼猫适合吃 A 品牌猫粮吗?"
前者测的是 AI 在没有提示的情况下,会不会把你纳入考虑;后者只能测 AI 对这个品牌已经有多少了解——两个问题完全不是一回事。
加了品牌名,AI 大概率会顺着你的问题聊你,这不叫"被推荐",这叫"被点名回应"。
06 | 每次回答,至少记录这八项
别只存截图——截图适合发朋友圈、做案例展示,但做统计、做对比、做复测,全靠结构化记录。每一条 AI 回答,至少记这些:
1. AI 平台与回答模式
2. 测试时间与测试轮次
3. 完整回答内容
4. 有没有提到品牌或具体产品
5. 推荐角色:明确推荐 / 条件性推荐 / 候选 / 未提及
6. 核心事实:AI 到底说了品牌什么
7. 竞品出现的情况
8. 引用来源:官网、媒体、电商还是社交平台
另外再加一条:这次回答里的主要缺口是什么?缺了哪些关键信息,哪些问题没说清。
07 | 问题和平台多了,用工具批量跑
当问题清单涨到几十上百条、平台也有三四个的时候,人工一条条跑就不现实了。这时候用 GEO 监测工具,流程一般是:
导入问题 → 选 AI 平台 → 批量测试 → 看完整回答 → 统计品牌与竞品表现 → 分析引用来源。
但这里有一个关键提醒:别只看工具给的"可见度""推荐率"这些汇总数字。
工具确实能提效,但它判断不了事实对不对、推荐理由是否符合你的策略、这个产品能不能承接这条问题。所以一定要抽查原始回答,尤其是高优先级问题。
08 | 拿到回答后,重点看 5 个维度
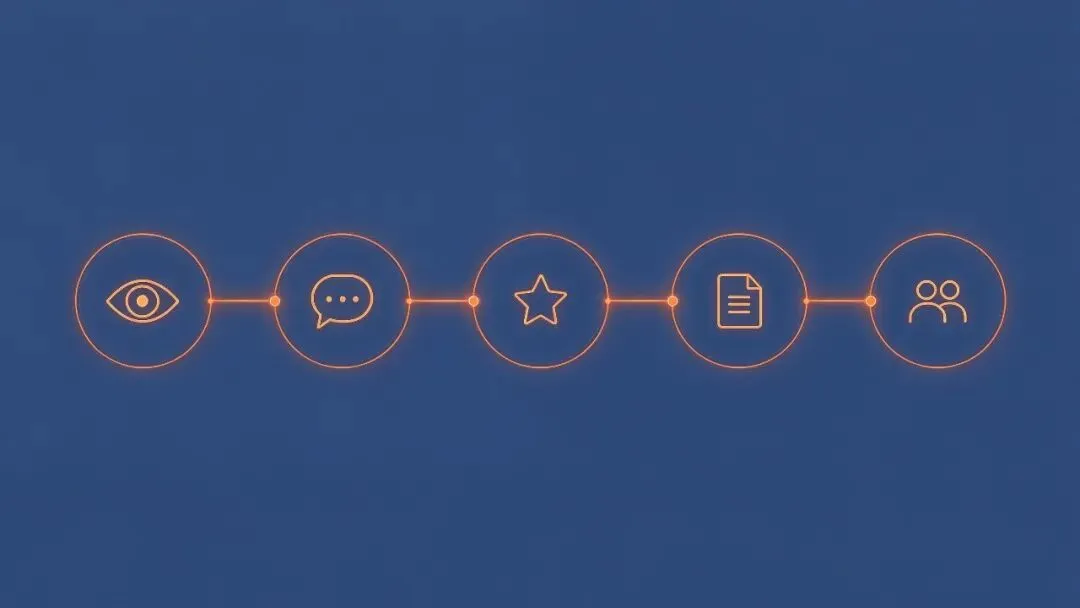
这是整篇文章最核心的部分。不管人工还是工具,最终都要回到这五个维度上:
五个维度,从"提没提"一直看到"为什么是它"。
维度一:AI 有没有提到品牌
先看最基础的:品牌名有没有出现,具体产品有没有被点名。再看品牌出现在了哪些问题里、哪些平台长期没提、多次测试表现是否稳定。
这里要特别提醒一句:品牌被提到,只能说明 AI 觉得你和这个问题相关,不等于形成了推荐。
维度二:AI 有没有把品牌说对
这是最容易被忽略、但杀伤力最大的一维。要逐条核对:
品牌名、产品名准不准?产品系列有没有被混淆?参数、配方、规格对不对?适用人群和场景说准了吗?信息是不是过时的?有没有出现没依据的功效表达?
事实判断分三类:准确、错误、无法验证。
"无法验证"这条最值得警惕——它往往说明品牌内部没有统一、公开、可被 AI 抓取的资料,先补事实依据,比急着做内容更重要。
维度三:AI 有没有形成推荐
品牌出现在回答里,角色是不一样的:
明确推荐——直接建议你考虑;条件性推荐——在特定人群、特定场景下推荐;候选——只是作为比较对象出现;中性提及——仅作为案例被带一句。
除了看角色,更要看推荐理由讲没讲清楚。真正有用的回答,会同时包含:用户需求、选择标准、品牌事实、推荐理由这四样。
维度四:AI 引用了哪些来源
看回答里有没有展示来源、引用的内容准不准、有没有引用品牌官网、有没有引用媒体/电商/社交平台、哪些来源在多个问题里反复出现、竞品主要靠哪些来源进入。
要清楚:回答来源不能代表 AI 的全部信息,但它是你能摸到的那部分,能直接帮你发现信源缺口。
维度五:竞品为什么能进入答案
别只看谁提得多,要看它凭什么被提。
竞品出现在哪些问题里?AI 用什么理由推荐它?哪些产品事实被反复引用?竞品在哪些场景有优势?背后是哪些来源在支持它?
分析竞品不是为了焦虑,而是为了判断一件事:AI 回答这类问题,到底需要什么依据?我们现在缺什么?
09 | 诊断结果,要回到具体问题看
跑完一圈,千万不要只看一个"整体可见度 50%"这种数字就结束。整体数据好看,不代表你的核心问题被覆盖了。
要把每条问题按结果分类,不同情况对应完全不同的动作:
稳定被提及和推荐——说明有基础优势,保持信息更新、持续监测就行。
有提及但推荐弱——大概率是缺场景关联和推荐理由,要补产品事实和选择依据。
有提及但信息错误——最高优先级,先纠错、统一对外资料口径。
产品能承接但没被提到——公开信息和信源不足,要补官网内容和外部信源。
单平台表现好、其他平台差——不同平台信息生态不一样,分析那个好的平台靠什么来源。
回答波动大——信息不一致或样本不足,增加测试轮次、检查信源一致性。
10 | 用"五道门"定位问题卡在哪
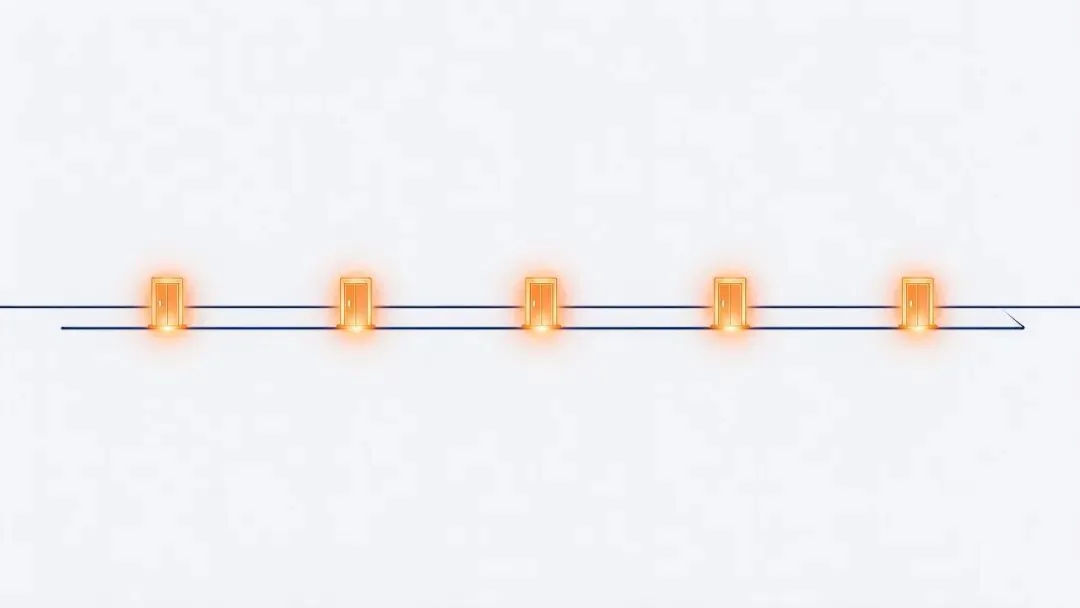
分类之后,再用一个更简单的框架定位问题到底卡在哪一层。我们叫它"五道门":
五道关卡,一道一道过,问题位置自然清楚。
问题门——问题本身离业务目标太远,这个问题不值得继续优化。
信息门——有产品,但 AI 长期找不到品牌信息,等于线上不存在。
信任门——不同来源说法冲突,AI 回答不稳定。
理解门——有公开信息,但 AI 理解错了品牌。
匹配门——AI 知道品牌,但很少在目标场景里推荐。
一个真实案例
举个例子。一个猫粮品牌,我们诊断时发现它在"幼猫粮推荐"这类问题里被提到了,但在"两个月幼猫吃什么"这种更具体、更靠近转化的问题里完全缺席。
按五道门一卡,这是典型的匹配门:AI 知道这个品牌,但缺少"适用于两个月幼猫"这个具体场景的事实支撑。
对应的动作不是急着加内容,而是去补:试用阶段(适用月龄)、营养配方、喂养方式,以及配套的可信来源。补齐之后再测,答案就会变化。
所以诊断不是为了给品牌贴一张"表现不好"的标签,而是把问题拆到具体颗粒度:哪条问题有问题、缺什么依据、下一步该做什么。
写在最后
第一次 GEO 诊断,不管人工还是工具,核心就盯五件事:
有没有提到品牌、有没有说对、有没有形成推荐、引用了哪些来源、竞品为什么能进。
这一次诊断不是终局,而是品牌 GEO 的"基线"——它给你一张当前的成绩单,也是后续所有监测、优化、复盘的起点。
更重要的是,它会逼着你回答一个问题:每一个核心问题,我们到底缺什么事实依据?
下一篇我们会讲:诊断完之后,怎么系统搭建品牌的问题库和知识库。
——云罗互动 · 专注 AI 获客领域研究
封面图
写给每一家想知道"自己在 AI 回答里长什么样"的品牌。
备选标题
1. 第一次 GEO 诊断,到底要做什么?一份品牌可照做的完整清单
2. AI 都开始推荐品牌了,你却不知道自己在答案里长什么样
3. GEO 诊断别上来就买工具:第一次先跑完这 5 个维度
4. 品牌做 GEO,先回答这两个问题,再谈优化
5. 被 AI 提到 ≠ 被推荐:第一次 GEO 诊断的 5 个判断维度