本地部署大模型怎么选?先理清需求,看懂 4 条主流技术路线
- 更新时间 2026-09-29 10:14:47
NO.010 · 折腾手记 · AI,在你身边(第 7 篇)
本地部署大模型怎么选?先理清需求,看懂 4 条主流技术路线
文 / 陈又夏 · 2026.09.29 · 约 8 分钟
这阵子,我把家里的群晖 NAS 当成「第五口人」的中枢,让 ta 替我收文档、写公众号。但有一件事,到现在都不敢让 ta 干——把工作文档、私人笔记、家人的照片喂给云端 API。隐私这根弦,绷在每个工程师的指尖。忍了一阵子,我决定换个思路:把大模型搬回家。不是云端跑不动,是有些数据不配出家门。这一篇,先讲清楚本地部署的底层逻辑——4 条主流路线,每条的代价与边界。不贩卖焦虑,是本号祖训。
(图:本地部署大模型怎么选——4 条主流路线,代价与边界一次说清)
一、为什么放弃云端,坚持本地部署大模型?
当下个人、工作室、小团队用 AI,普遍面临四大云端痛点,也是本地部署的核心价值来源:
1. 数据隐私完全自主可控
工作文档、私人资料、业务方案、原创内容一旦上传云端 API,存在平台缓存、日志留存、合规抽检、数据外泄风险。本地部署所有推理、知识库问答、微调计算均在本地硬件闭环完成,不上传外网,从根源规避隐私泄露问题。
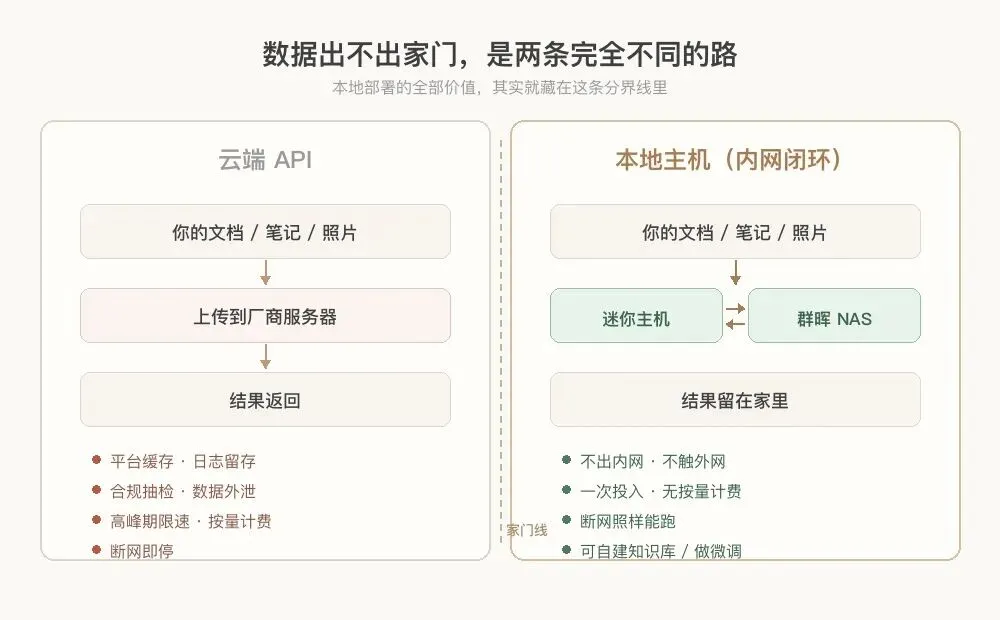
(图:数据出不出家门,是两条完全不同的路——左边交出去,右边留在家里)
2. 彻底摆脱网络与 API 计费限制
云端大模型存在高峰期限流、响应延迟、突发宕机、地区网络波动等问题;高频调用场景下,长期 Token 计费成本极高。本地硬件为一次性投入,后续推理、微调、知识库使用无任何按次、按量收费。
3. 完全自由的自定义与微调能力
云端平台模型固定、参数锁死、微调权限受限、无法自主部署小众开源模型。本地部署可自由加载任意 GGUF、HF 开源模型,可自建私有知识库、自定义 Prompt 工作流、定期做 LoRA 轻量微调,适配个人专属工作场景。
4. 离线可用,适配内网/断网场景
居家、工作室、内网办公环境,断网状态下依然可以稳定推理、问答、生成内容,不受外网服务稳定性影响。
一句话总结:云端是租来的方便,本地是买来的自由。 想要自由,就要把账算清楚、把硬件挑明白、把生态踩透。
二、业内公认:本地大模型 4 大主流部署方案(权威对比)
结合 llama.cpp、Ollama、AMD ROCm 官方开发文档 与行业通用落地范式,目前本地大模型仅有四条成熟技术路线,无第五种通用方案。
记住一个比喻就够了:本地大模型推理,本质是「模型分层 + 显存搬运」——把几十 GB 的模型权重按层拆开,一段一段塞进显存里跑。不同的硬件路线,区别只在「谁来当这个搬运工」。
方案一:NVIDIA 独显台式机(CUDA 生态路线)
原理:依靠 NVIDIA 独立显卡显存承载模型分层推理,是目前生态最完善、适配度最高的专业 AI 方案。
✅ 优势:CUDA 生态全覆盖,微调、推理、Agent、绘图全适配,速度上限最高、社区教程最全。
❌ 劣势:高端显卡溢价极高、单卡显存容量有限,70B 及以上大模型需要多卡并联;整机功耗、噪音、电费成本高。
👉 适合:专业 AI 开发者、工作室重度微调、追求极致推理速度的用户。
方案二:Apple Mac Studio(统一内存封闭路线)
原理:Apple Silicon 架构统一内存设计,CPU/GPU/NPU 共享内存空间,原生适配大模型推理。
✅ 优势:系统极致稳定、低噪音、低功耗、开箱即用,无需复杂环境配置。
❌ 劣势:硬件价格昂贵、生态封闭、不支持 CUDA,部分微调框架适配缺失;硬件无法后期升级扩展。
👉 适合:纯苹果生态用户、仅做推理、无深度微调与硬件扩展需求。
方案三:AMD 锐龙 AI Max 迷你主机(本次选型最终路线)
原理:Zen5 CPU + RDNA3.5 核显 + XDNA2 NPU 三合一架构,全芯片统一内存架构,128G 大内存可稳定划分 96G 显存用于大模型推理。
用生活化的比喻讲清楚:AMD 锐龙 AI Max 像是把一个小型机房塞进了 1L 机箱——CPU 是调度员,核显是搬运工,NPU 是质检员,三个人共用一个超大仓库(统一内存),既能跑模型又能日常办公,一台机器顶过去一整套工作站。
✅ 优势:同规格内存价格远低于 N 卡、苹果方案;体积小巧、功耗低、静音可控;支持 LoRA 轻量微调;部分机型支持 OCuLink/USB4 外接显卡扩展算力。
❌ 劣势:ROCm 生态成熟度弱于 CUDA,部分环境需要基础手动配置;单芯片算力上限低于专业多卡工作站。
👉 适合:个人、工作室,主力 7B/13B/34B 推理、偶尔 70B 量化推理、月度轻量微调、预算 1–2.7 万、追求综合性价比用户。
方案四:多机分布式集群(企业级路线)
原理:多台算力主机通过高速网络互联,模型拆分分布式推理,横向堆叠算力。
✅ 优势:算力无限扩展,可承载 200B+ 超大模型推理。
❌ 劣势:组网复杂、运维门槛极高、设备与交换机成本高,个人完全不适用。
👉 适合:企业研发团队、专业 AI 实验室。
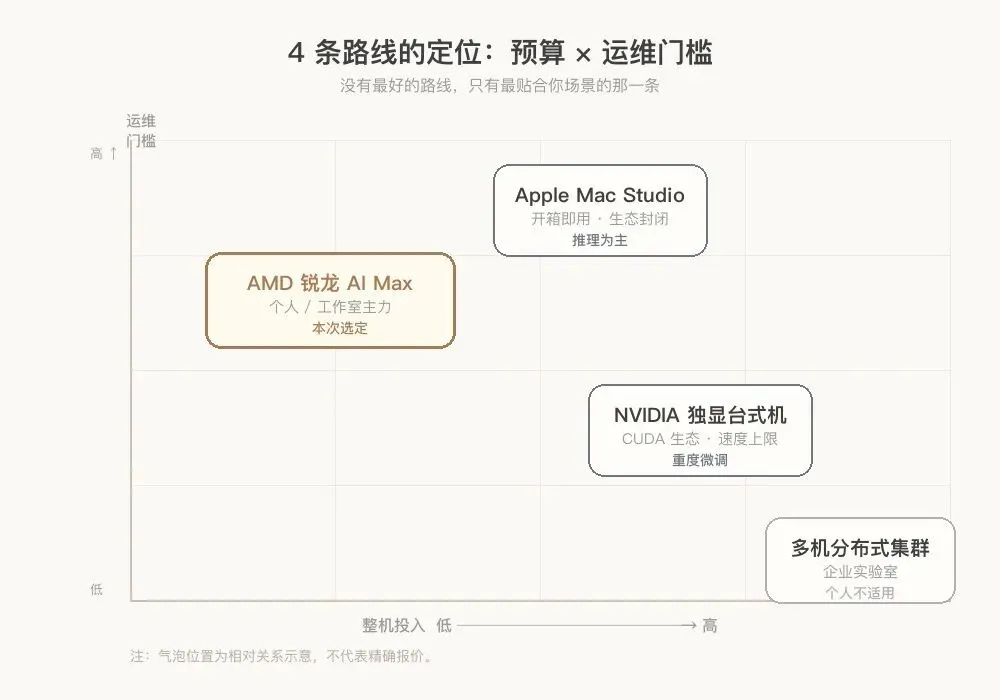
(图:4 条路线的定位——没有最好的路线,只有最贴合你场景的那一条)
三、本次真实落地需求(精准、可复用的个人 AI 工作站标准)
结合长期实测与场景打磨,本次选型需求完全落地、无虚标、无冗余:
1. 运行环境
书房静音放置,支持 7×24 小时不间断待机推理。
2. 模型负载
主力 7B/13B/34B 日常推理,偶尔 70B 4bit 量化推理,每月 1–2 次 LoRA 轻量微调。
3. 存储分工
群晖 DS920+ 承担冷模型、数据集长期存储,本地主机仅存放高频常用模型。冷热分层——本地不是 NAS,是 NAS 的算力搭档。
4. 硬件底线
必须 128G 统一内存,支持显存划分,预留后期算力扩展能力。
5. 明确取舍
不关心体积、系统版本、万兆网口、多屏输出,拒绝无效溢价。
6. 预算区间
10000–27000 元,优先全生命周期性价比。
7. 新品判断
AMD 495 为同架构小幅迭代,CPU/GPU 提升仅 2%–3%、NPU 提升约 10%,仅新增 192G 大内存支持,常规 70B 以内用户完全无升级必要,新品存在首发溢价、适配不成熟、交付慢等问题。
一句话总结:这是一份「够用就好、留足扩展」的克制清单——少 1G 内存不够用,多 1G 内存都是浪费。
四、最终技术路线锁定
综合成本、难度、稳定性、扩展性、长期运维成本,AMD 锐龙 AI Max+395 迷你主机是个人与小工作室最优解。
但同平台十余款机型硬件参数接近,软件生态、售后、扩展能力、易用性差距极大。
下篇文章将横向拆解所有主流厂商方案,并详细说明:为什么硬件性价比极高的奋微不是最优解,最终选择极摩客 EVO-X3。
📋 一屏速查卡(建议截图收藏)
| AMD 锐龙 AI Max 迷你主机 | 性价比天花板、扩展灵活 | 个人/工作室主力 | |
写在最后
回头看,本地部署大模型,硬件只是门槛的一半。门槛的另一半是「生态成熟度」和「长期运维成本」——硬件可以一次性买到位,环境适配和踩坑排查却是日复一日的事。
选型有三个判断习惯值得留下:
先想场景再选硬件。 不要被跑分牵着走,先列清楚你要跑多大的模型、跑多久、要不要微调、要不要扩展——硬件是结果,不是起点。
算全生命周期账,不算单次账。 一台 2 万的机器能稳稳服役 5 年,比一台 1 万的机器 2 年后被迫升级更便宜。
预留扩展位比堆满配置重要。 内存多 16G 你不会用上,但 OCuLink/USB4 扩展口早晚能救场。
以及最重要的一条:本地部署不是云端的廉价替代,是另一种自由的开始——你的数据,你的模型,你的节奏,全部自己说了算。
下一篇,10 款 AMD 锐龙 AI Max 主机横向对比,告诉你为什么硬件参数几乎一致、体验天差地别,以及最终为什么放弃奋微、选了极摩客 EVO-X3。
(P.S. 跟媳妇汇报这件事,她说:「你折腾这么大阵仗,是不是为了让 AI 帮你干活,自己偷懒。」我沉默了三秒,因为被说中了——不是偷懒,是让 ta 能干那些以前不敢让 ta 干的事:工作文档、家人的照片、私人笔记。本地部署之前,这些东西连云端 API 都不敢碰。)
· · ·
【陈又夏】
一个有技术底蕴、热爱生活、重视家庭、且不断进化的爸爸。
十几年的 IT 底子,从前端到后台,从架构到产品;现在最着迷的事,是用 AI 重新打量生活——让家更智能,让琐事有人记,把重复的事交给机器,余下的时间留给家人。
标签:#AI实践者#折腾手记#本地大模型#AI硬件#私有化部署#AMD锐龙AIMax#技术老兵#终身学习者#孩子的人生路由
往期推荐
合集入口
📚 本文参考文献 / 官方资料来源
[1] AMD 官方锐龙 AI Max+395 处理器技术白皮书与规格文档(AMD Official)
[2] AMD ROCm 官方开发者部署文档、统一内存调度技术说明
[3] llama.cpp、Ollama 官方本地大模型部署规范与量化参数标准
[4] AMD 锐龙 AI Max+495 新品官方参数迭代说明与性能对比资料
[5] OCuLink 外设高速传输协议官方技术文档、外接显卡性能损耗基准数据
点「收藏」让更多人看到 · 谢谢你的支持!
