《AI应用测评培训课》21 · 一致率 85% 看着不错?挤掉水分只有 0.70——Kappa 一致性系数
- 更新时间 2026-09-29 08:57:24
小周和小郑的第一次双人标注:
规范 v1.0 时代,两人各判同一批 20 题。结果:一致 17 题,分歧 3 题。一致率 85%,看着不错?
但小周偏严(判过 55%)、小郑偏松(判过 50%)——两人的判定倾向本身就贡献了不少"碰巧一致"。挤掉水分后,真实一致性 κ 只有 0.70。
规范迭代到 v1.2 后复测:κ 升到 0.74,分歧降到 2 题。两个 κ 值的差距,就是规范迭代的价值量化。
01 为什么一致率会骗人
一致率 85% 的问题在于:两个人都偏向判"过",即使各自随机猜,也会"一致"不少——这是碰巧一致,不是真实一致。
Cohen's Kappa 做的事就是把这部分水分挤掉:
κ = (实际一致率 − 碰巧一致率) ÷ (1 − 碰巧一致率)
小周和小郑的例子:实际一致率 85%(Po=0.85),碰巧一致率 50%(Pe=0.50,按两人的边际比例算)。κ = (0.85−0.50) ÷ (1−0.50) = 0.70。
一致率 85%,挤掉水分后真实一致性只有 0.70。
02 Kappa 怎么解读
κ ≥ 0.81——几乎完全一致,优秀。
κ 0.61~0.80——高度一致,合格。工程上的常用及格线是 κ ≥ 0.6。
κ 0.41~0.60——中度一致,预警:排查规范歧义。
κ ≤ 0.40——偏低,不合格:规范有问题或培训不足,暂停标注先修规范。
关键原则:Kappa 低的第一嫌疑人永远是规范,不是标注员。 规范有歧义,两个人对同一输出的理解不同,Kappa 就低。先查规范、修歧义、补边界案例,再复测——而不是急着培训标注员。
小周的 κ 从 0.70 升到 0.74,靠的不是培训,是规范从 v1.0 迭代到 v1.2——补了阈值、补了边界案例。
03 三个控制手段
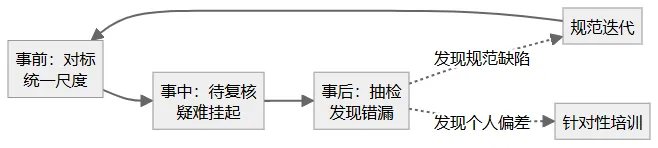
事前:对标(标注对齐会)。 标注前,两人一起判一批题,统一尺度。分歧题讨论定标,进边界案例集。
事中:待复核。 拿不准的题挂起,不硬判。宁可挂起让复核人裁定,也不要硬判后被发现判错。
事后:抽检。 按比例复核(如 20%),发现错漏。抽检发现的问题,要么是规范缺陷(进修订清单),要么是个人偏差(进针对性培训)。
三个手段形成闭环:发现规范缺陷 → 规范迭代 → 重新对标 → 一致性提升。
04 金标集:标注员的"上岗考试"
金标集是一组由专家标注的基准题,用于考核标注员和校准尺度。
用法:标注员判金标集 → 与专家结论比对 → 算 Kappa 和正确率 → 达标才能上岗。
金标集的题不在正式评测集里(防止"背过"),但覆盖典型场景和边界案例。标注员换了、规范改了、裁判模型换了——都要重新过金标集验证。
一句话记住:一致率会骗人,Kappa 挤掉水分——Kappa 低的第一嫌疑人是规范,不是标注员。先修规范再培训,顺序不能反。
如果你手上正有一个 AI 应用,自测 3 件事:
① 你的标注有没有两个人独立做?还是一个人判了就定了?如果只有一个人,一致性无从谈起。
② 你有没有算过 Kappa?还是只看了"一致率"?一致率 85% 可能掩盖了 0.70 的真实一致性。
③ Kappa 低的时候,你是先查规范还是先怪标注员?如果先怪标注员,方向可能反了。
三个答完,你就知道你的标注质量可不可信——而不是泛泛地"要标注准确"。
《AI应用测评培训课:方法、工具与实战》这门课 30 节要教的全套方法。它专为有意转入 AI 测评方向的传统测试工程师而写——你熟悉的用例思维、缺陷管理、回归意识全部带得走,需要补的是评测集、标注规范、统计分析三块新能力。
📢 购买完整课程 PDF
《AI应用测评培训课:方法、工具与实战》30 节全文 PDF,29.9 元。加微信 laoli7500(备注"测评"),付款后发 PDF 全文。
下篇预告:六类问题怎么分类、怎么定级——内容错误/语义偏差/合规风险/场景不匹配/回复异常/稳定性问题,合规一票 P0。
标签:#AI应用测评 #大模型 #AI客服 #软件测试 #测试工程师 #AI质量保障 #人工智能 #AI应用 #大模型应用 #AI落地
