客户在 AI 里问「哪家好」:73% 的提问在比价,你的资料能比吗
- 更新时间 2026-09-29 07:59:19
QUOTE
客户在 AI 里问的是「哪家好」,不是「你是谁」。你交上去的材料能不能比,决定了你在不在那份名单上。
过去客户找供应商的做法是先搜关键词,再一条条翻网页。现在越来越多人换了个做法:把完整的处境一次性讲给 AI 听。预算多少、用在哪、要解决什么问题、哪些条件不能让步,一口气说完,然后等一段整理好的答案。
位置就这样换了。以前是客户在你的网页里翻信息,现在是客户在 AI 那里先拿到结论,再决定要不要找你。有份调研覆盖了十个行业、五十个品牌、一千次问答,把提问方式拆开看过:问得最多的不是品牌名,是对比。73.2%属于对比选择类,比如「这两家到底差在哪」;59.8%属于匹配推荐类,比如「预算就这么多,推荐哪家」。
顺着这两类问题往下,客户真正盯着看的东西也变了。被提到最多的是产品和服务详情,占 74.8%;品牌口碑排在后面,占 66.4%。客户要的是能拿来比的东西,不是一段品牌介绍。
本文看点:客户在 AI 里问的是什么 · 什么样的内容会被拿走 · 五个平台的口味差在哪 · 这周能动的三件事
01
客户在 AI 里问的,不是你的名字
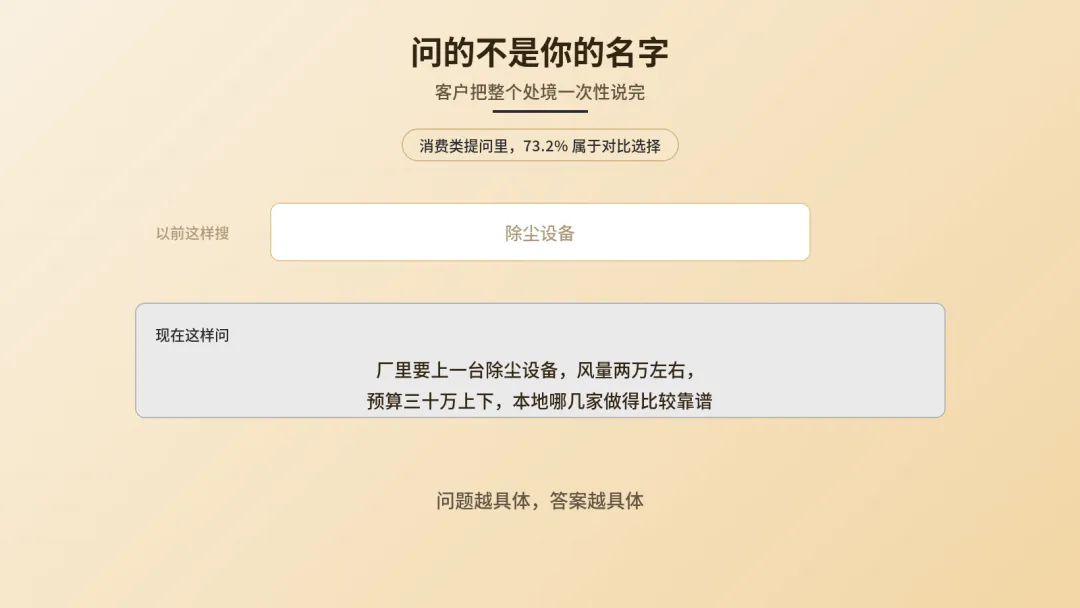
把这件事放回日常经营里,会更清楚。一个要换设备的小老板,以前会搜「某某设备厂家」,翻几页官网,挑一家打电话问价。现在他打开豆包,打一句:「厂里要上一台除尘设备,风量两万左右,预算三十万上下,本地哪几家做得比较靠谱」。
这句话里没有供应商的名字,也没有关键词。它是一个完整的处境。AI 拿到之后要做的,是从能被读到的材料里拼出一份候选名单,再附上理由。你在名单上,才有后面的事;不在名单上,价格谈得多细都到不了你这里。
对企业客户来说,这个变化来得更早。企业任职用户里,有 55.31% 经常用 AI 查供应商,另有 35.87% 偶尔用。他们查的目的集中在三类:对比技术参数和成本差异,占 64.4%;了解行业与技术趋势、找解决方案,占 61.8%;按业务需求找合适的供应商,占 56.0%。三类加起来覆盖了七成七的提问。
同一家公司,会被不同角色反复问。采购关心成本和合同条款,技术关心部署方式和接口,业务关心落地效果,管理层关心方案和经营目标对不对得上。这几拨人会在几个月里交叉核对。你在某一轮里把参数说过一次,后面每一轮都要重新解释一遍。
还有一点值得留意:客户不会只问一家。答案不合预期的时候,56.6% 的人会换到电商或社媒继续查,52.5% 会换一种问法再问一遍,50.6% 干脆换一个 AI 平台。同一家公司在几个平台上得到的描述,他们可能都看过,也会拿来互相对照。
02
AI 拿走的是能直接用的那一段
接着要问的是:AI 拿什么回答。它不会把你的官网从头读到尾,也不会因为你的文章写得漂亮就多看一眼。它找的是一种更具体的东西:能直接拎出来、不用改写、也不太会出错的那一段。
围绕这件事的做法,业内有个名字,叫 GEO,全称是 Generative Engine Optimization,生成式引擎优化。说白了就一句话:AI 替人回答的时候,调取的是哪几条关于你的信息。它和搜索排名不是一回事。排名管的是谁能被翻到,GEO 管的是谁能被念出来。翻不到最多是少一次曝光,念不出来是连被比较的资格都没有。
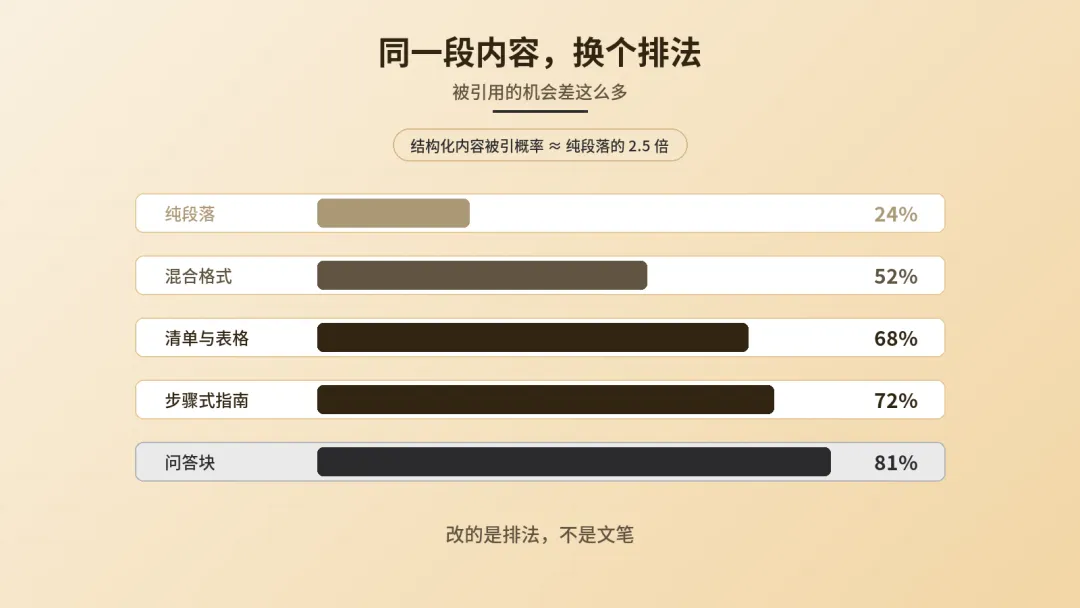
同一份内容,写成大段文字被引用的机会是 24%;排成问答块,是 81%。差的不是文笔,是形状。
这个差距有一份一万页的基准研究量过。纯段落的内容被引用率 24%,混合格式 52%,清单和表格 68%,步骤式指南 72%,问答块 81%。结构化内容的被引用概率大约是纯段落的 2.5 倍;再补上文章层的结构化标记,还能再加 45%。
另有一组对比更直白:同一批数据,用表格排出来和被写成大段文字,被提取的比例是 81% 对 23%。被引用的页面里有 61% 带了结构化标记,同期排在搜索结果前面的页面只有 25% 带。从这个角度看,AI 在选材料的时候,更像是在过一道「这段好不好用」的关,而不是在评谁的文笔好。
还有一件事容易被忽略。AI 会同时抓一批候选页面,最后只引其中一部分,按实测比例大约 15%,剩下的读了不用。决定它用不用的,是它能不能从这一页里干净地抽出一段话。换句话说,你的页面被打开过,不等于被用过。
位置也有讲究。被引用的内容,大头落在页面的前两到三成。答案要写在前面。开头先铺垫背景、铺垫完再给结论的写法,在人读的时候没问题,在被抽取这一步吃亏。同理,一段话写三百字才说到重点,不如开头一句话把结论给完,后面再补细节。这种写法在人看来略显生硬,在抽取这一步却是最省事的。
成本最低的一个改动是把数字加进去。有份同行评审过的研究显示,页面里加上具体统计数字,被 AI 引用的可见度提升约 41%。含糊的形容词拿不到引用,能核对的数字可以。「质量可靠」这四个字谁都能写,「平均故障间隔 8000 小时」只有你能写。8月GEO合规重构:铺量派出局,资产派上位
03
五个模型,五种口味
到这里还有一层:不同的 AI,读材料的偏好不一样。同一篇文章,在这家被引用,到那家可能完全进不去。《信任代码》蓝皮书用了一千次问答、十个行业、五十个品牌做过一轮,把五个主流模型引用来源的层级拆出来看。这件事说明,只在一个平台上出现是不够的。
DeepSeek 引用政府和教育官网的比例最高,占 22%;文心一言对权威媒体的依赖最重,占 42%,把四成多的引用交给了正规媒体;豆包和 Kimi 引到第四层及以下来源的比例都超过 23%,也就是更愿意用普通平台上的内容;腾讯元宝居中,权威媒体占 33%。
再看它们各自习惯待的地方。文心一言的底子以百度这一系为主,百科加百家号加知道,占去将近一半。腾讯元宝大半来自微信这一侧,公众号是其中最大的一块,客户在微信里问,答案更可能落在公众号的内容上。豆包早些年偏字节这边,头条和抖音占了大头,今年六月迭代之后可引入的外部站点数量涨了大约 15%,说明它在往外扩。DeepSeek 更认新闻源和知乎上的深度回答;Kimi 偏爱长文,引用内容里千字以上的文档占了六成多。
这里有个概念要分清:被收录和被引用是两回事。内容被索引进去了,和内容进到答案里,中间隔着一道挑选。有的企业发了一堆稿子,搜是搜得到,但客户一问具体问题,答案里就是不提。差别通常不在数量,在材料够不够清楚、够不够一致。
一致性这件事有数字:多源交叉验证的出现率平均 43%,最高的行业到 67%,最低只有 22%。同一个事实,官网写一套、平台页写另一套、老资料里还是旧的那一套,模型拿到会犹豫,结果可能是谁都不选。把口径统一这件事,比多发十篇稿子更值。微信也能问 AI 了:客户不再一条条翻你的公众号
AI 不是在挑谁写得好,是在挑谁说得清。
04
这周能动的三件事
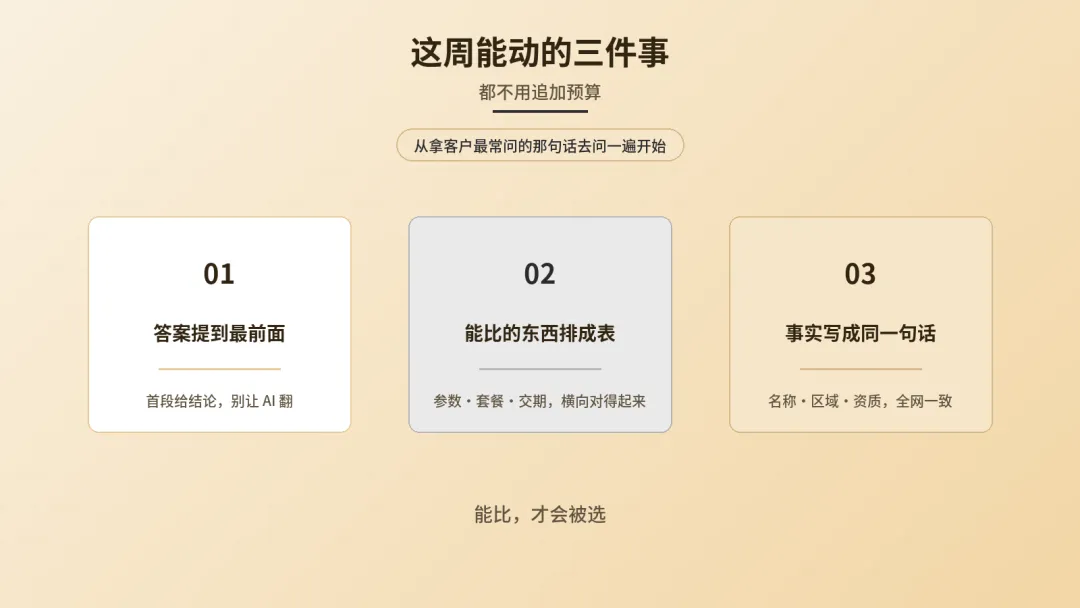
不用重做网站,也不用先买工具。GEO 落地不靠一次大改,靠的是把手上已经有的东西换个排法。下面三件事做完,一轮就能看出差别。
挑三到五个页面,先挑客户最常问到的那几个:产品或服务、报价口径、常见问题、服务范围。每个页面开头一段就把答案写清楚,别让读者(和 AI)翻到一半才看到结论。改动量不大,位置一挪,效果就不一样。
把参数、套餐、服务范围、交付周期这类能横向对照的信息做成表格,把客户最常问的十来个问题写成问答,一问一答,答案里带上具体数字。同一批内容,换个排法,被拿走的机会从 24% 抬到 81%,这中间的活是排版,不是重新写。
把公司全称、成立时间、服务区域、主营产品、资质这几项固定下来,在官网、公众号、百科、地图商户页上写成完全一样的一版。客户会跨平台核对,模型也会。写法不一致,扣的是信任分,而这个分数不在你手里。小红书日搜8亿次:本地老板的获客主战场,换地方了
判断标准很简单:拿客户最常问的那句话,去豆包、DeepSeek、千问里各问一遍,看答案里有没有你、说的是不是你、和你说的是不是一回事。
∞
入口换了,交上去的东西也得换
回到开头那句判断:客户在 AI 里问的是「哪家好」,不是「你是谁」。前者考的是能不能被放进那张对比表,后者考的是企业介绍写得好不好。这两件事之间,差着一整轮筛选。排在筛选之外的商家,连被比较的机会都没有。
改变不用从内容开始,可以从排法开始。手上已经有的产品说明、常见问题、参数表,换个排法就是给 AI 看的材料,比重新写一批更省,也比投一轮广告更便宜。先做最小的那件:把客户最常问的那句话,去 AI 里问一遍。客户还没搜你,AI已经替你回答了
/
关注【AI生成式营销】
免费帮你分析市场(含工具安装指导)教你用AI自动剪辑视频
