GPT-6 三兄弟怎么选?一篇看懂 Astra、Sol、Luna
先认识三个模型 · 不用背跑分,按任务选就行 · 省钱的真相:单价低 ≠ 总成本低 · 一个省 90% 的机制:提示词缓存
省钱的关键是把任务说清楚、把模型选对。
—— 坚硬的肉山
今年 9 月,OpenAI 补齐了 GPT-6 家族的完整阵容:
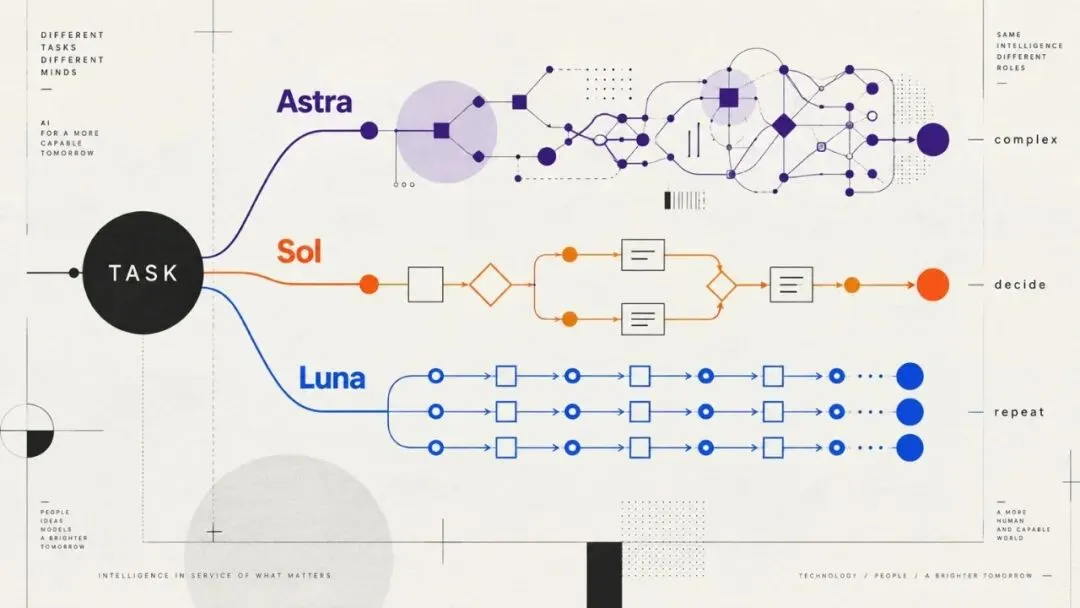
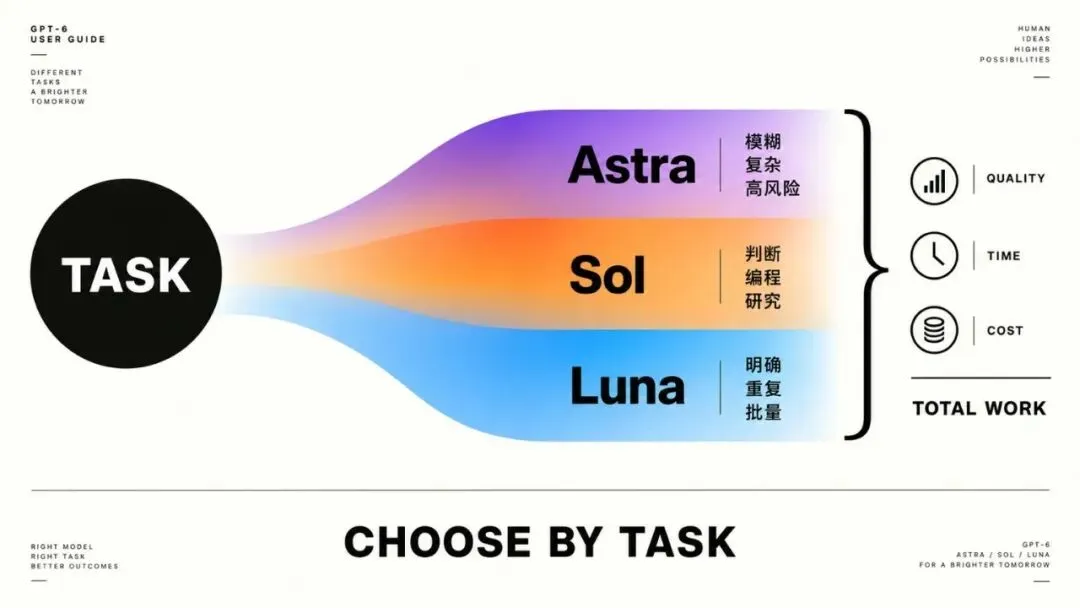
Astra(最强):能力天花板,适合最难、最重要、不能出错的工作。Sol(均衡):能力和成本之间的平衡点,面向日常编程、研究和需要判断力的专业任务。Luna(便宜量大):专门为目标清楚、数量大、重复频率高的任务而生。价格上,Luna 的输入输出费用是 Sol 的 1/20、Astra 的 1/100。便宜得足以改变批量任务的成本结构。
一个通俗的判断方法:
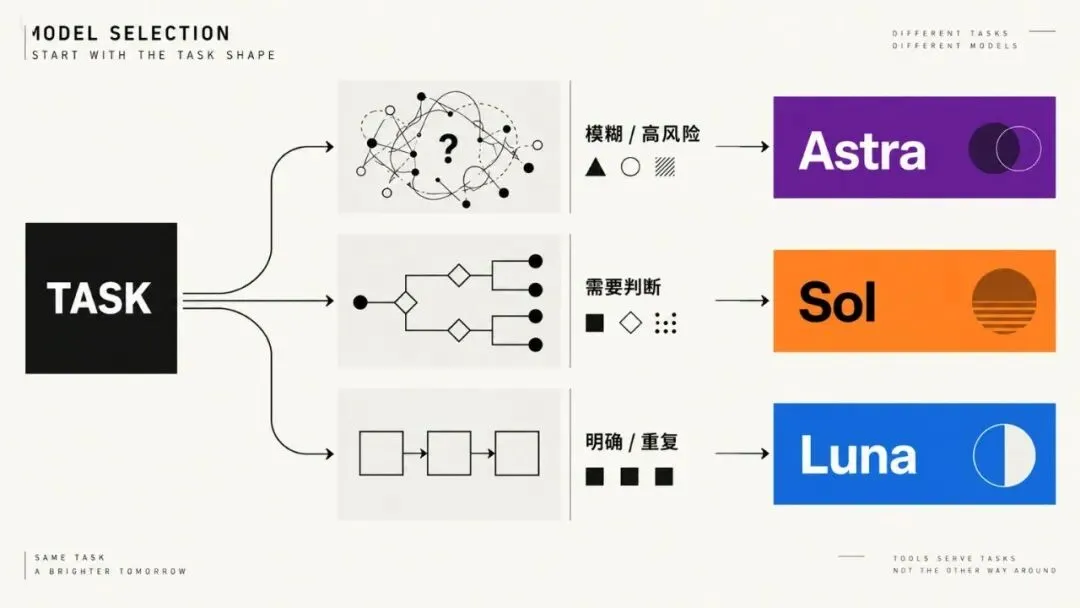
举个例子:把 200 条新闻按行业分类,用 Luna 就够了;但要从新闻里判断哪些会改变行业格局,就得换 Sol 甚至 Astra。
OpenAI 官方给出的 Codex 起点也很直接,只有两条。
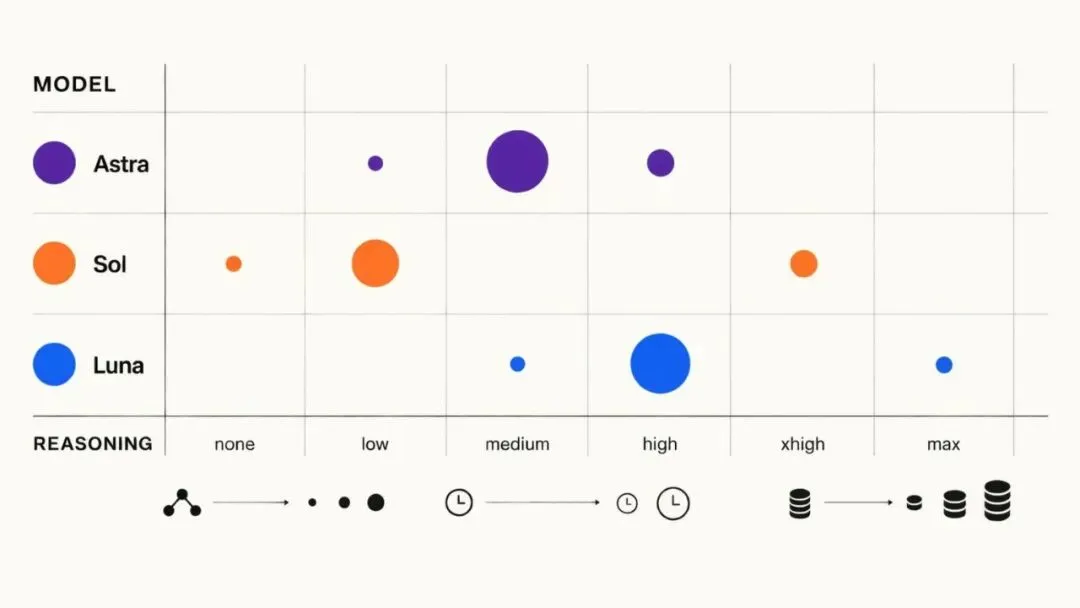
同一个模型还有多档推理强度(none 到 max)。别一上来就开最高档,先从官方建议的起点跑,不够再升。
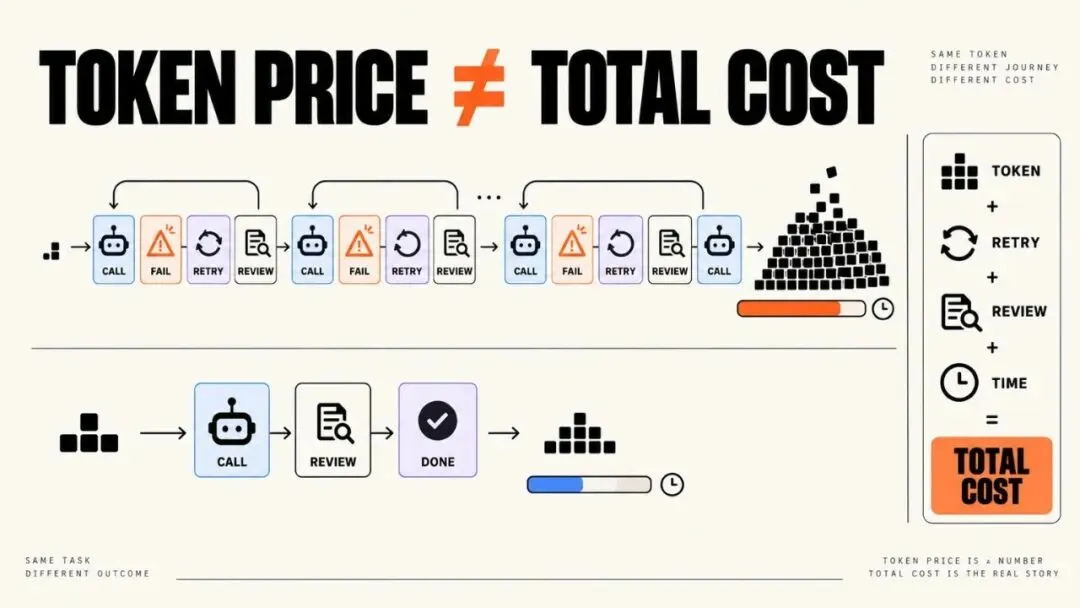
省钱的真相:单价低 ≠ 总成本低
CHAPTER 03
两个官方案例值得一看。
Airbnb 的用户反馈:用 Astra 处理战略文档,3~4 轮就拿到满意结果,其他模型要 20 多轮。视频平台 invideo:Astra 规划复杂视频编辑需要的推理轮次更少,调色任务成功率提高到原来的约 3 倍。少走弯路本身就是在省 Token。如果算整项工作的真实成本,还要把失败重试、人工检查和返工时间一起算进去。
所以 Luna 最适合的是标准说得清、结果好检查,而且需要反复跑的任务,比如批量提取信息、按模板生成一批文档,或者把会议记录整理成固定格式。
一个省 90% 的机制:提示词缓存
CHAPTER 04
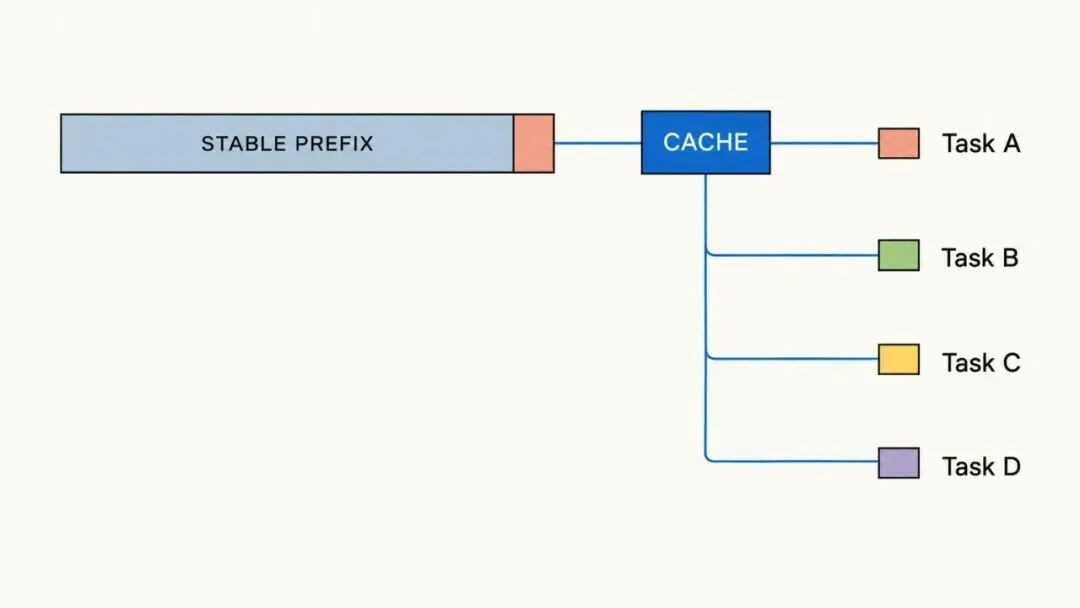
GPT-6 的 API 缓存输入价格是普通输入的 1/10,命中缓存最高能省 90%。
原理像印培训手册:第一次要做整套版面(缓存写入),之后每位员工的手册前 100 页都一样,只有最后一页任务不同,就不必每次重新制版。
想让缓存生效,记住三件事。
前缀要稳定:系统规则、工具定义、固定参考资料放前面;每次变化的问题放后面。频繁改写前面的规则会破坏复用。别动工具列表:本轮不用某工具,用 allowed_tools 限制范围,而不是删掉整套定义。相似任务集中跑:批量翻译、批量处理资料,别今天一条明天一条,集中处理更容易复用缓存。⚠️ 注意:这个“便宜 90%”是 API 计费的事,不能套到 ChatGPT 套餐额度上,两者的账单逻辑完全不同。
很多 Token 浪费,问题是任务没说清。“帮我优化一下”看着省字,却把目标、范围和验收标准全留给模型猜。
给 Luna 布置任务时,至少写清四件事。
对比一下。
❌ “检查这个项目” ✅ “只读检查 src/auth,找出仍在调用旧登录接口的文件。输出路径、调用位置和迁移风险,不修改代码,不扫描其他目录。”
指令写清楚,返工次数就少了,这比压缩字数省得多。
GPT-6 三个型号各有分工。
比起记住跑分,更有用的是知道什么时候该换挡,并且算的是完成整项工作的总成本。
ABOUT · 作者
我是 坚硬的肉山,热衷于分享 AI 编码一线实战
如果觉得今天这篇有收获,欢迎点赞、在看、转发三连,我们下篇见
