当前位置:首页>排行榜>中国科大机器科学家团队推出有机分子晶体评测基准 OMC-bench 与原子间势函数模型 AtomBit-OMC

中国科大机器科学家团队推出有机分子晶体评测基准 OMC-bench 与原子间势函数模型 AtomBit-OMC

  • 更新时间 2026-09-28 18:38:11
中国科大机器科学家团队推出有机分子晶体评测基准 OMC-bench 与原子间势函数模型 AtomBit-OMC

机器学习原子间势函数(MLIPs)近年来发展迅速,但在有机分子晶体(OMCs)中的可靠应用仍面临挑战。有机分子晶体的稳定性取决于非共价相互作用、分子构象柔性与多晶型竞争之间的微妙平衡,基于并非针对有机分子晶体的数据训练的现成模型,往往难以准确描述这些特征。

现有评测方式也可能掩盖模型在实际应用中的局限。以随机划分的数据开展能量和力的回归评测,可能让高度相似的结构同时进入训练集与测试集,从而明显高估模型面对新分子、新堆积环境和实际计算任务时的表现。

因此,制约这一领域进展的不只是模型架构,也在于缺少贯通数据、评测与诊断的研发基础:训练数据需要反映真实晶体的物理环境,分布外(OOD)评测需要贴近实际计算任务,模型诊断则需要帮助研究者理解模型如何利用局域化学信息。

围绕这些问题,中国科学技术大学机器科学家团队联合中国科学院计算技术研究所、华为MindSpore团队,在《npj Computational Materials》上发表研究,推出一个数据集、一个评测集和一个模型:以实验晶体为起点构建近3500万构型的OMC数据集,建立覆盖四类实际任务的OMC-bench评测集,并提出原子间势函数模型AtomBit-OMC,将化学与几何信息共同用于预测,并通过门控权重辅助分析模型行为。

一、从实验晶体出发构建近3500万构型

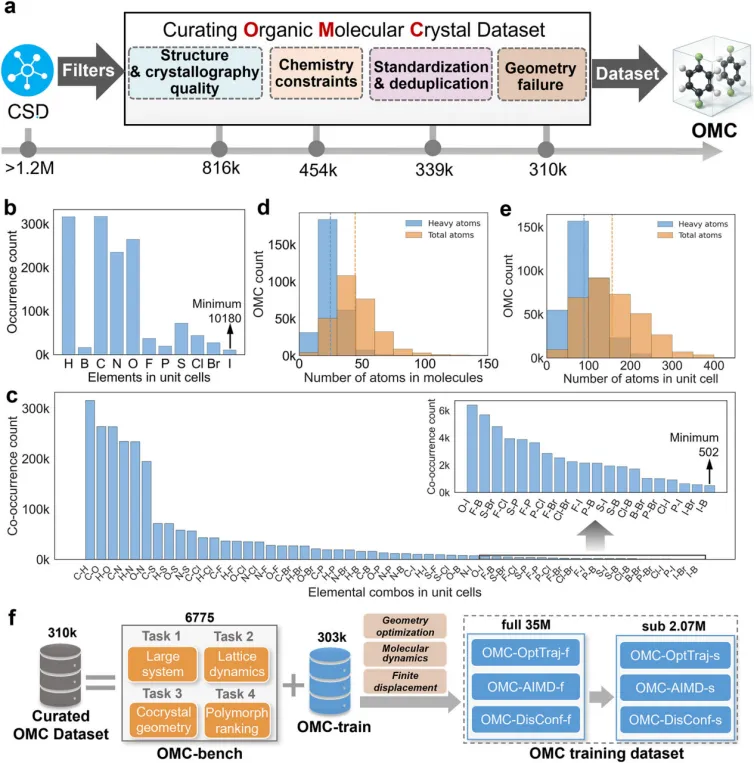
为使训练数据反映实际观察到的分子堆积环境,研究从剑桥结构数据库(CSD)收录的实验结构出发,经质量筛选、标准化、去重和密度泛函理论(DFT)优化,得到约31万条晶体记录,包含286872种不同分子,覆盖H、B、C、N、O、F、P、S、Cl、Br、I共11种元素。

图1|OMC数据的筛选、化学组成与规模分布。6775个独立晶体用于OMC-bench,约30.3万条晶体记录用于生成训练构型。

这些实验结构提供了实际观察到的分子堆积环境,也包含多组分晶体。其分子种类约为论文所比较的OMC25数据集的5.7倍,为学习不同化学组成与分子结构下的晶体相互作用提供了更广的覆盖。

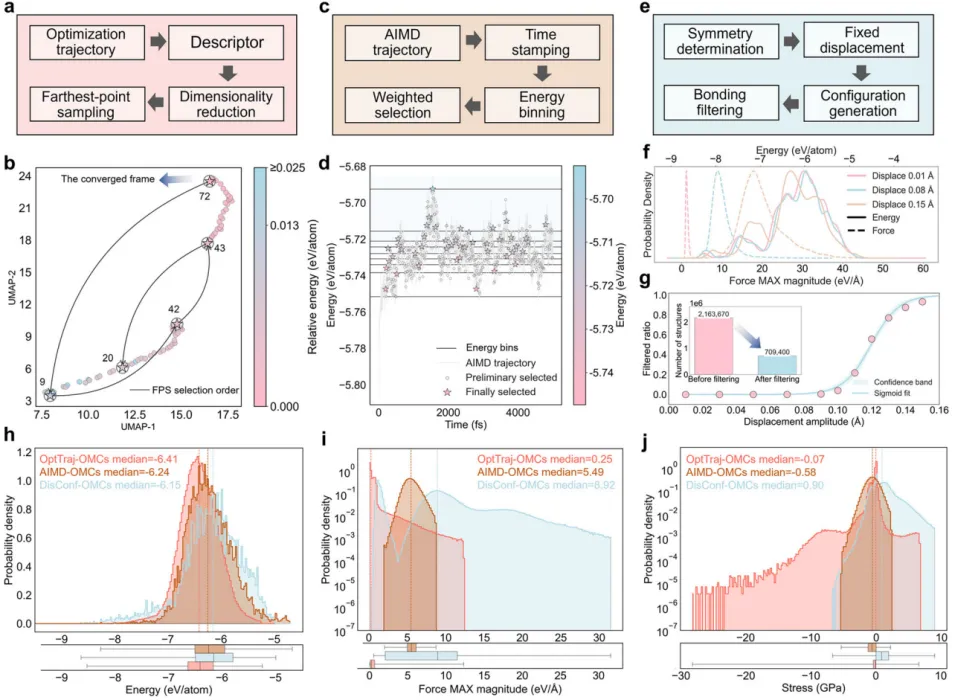
研究进一步从约30.3万条种子晶体出发,扩展模型需要学习的构型空间。优化轨迹记录结构走向平衡态的过程,高温第一性原理分子动力学(AIMD)补充热扰动下的构型,对称性感知有限位移则采样偏离平衡位置的响应。三种方式共同覆盖近平衡到较强扰动的区域,并通过采样与键长过滤减少冗余、剔除不合理结构。

图2|三类构型的生成、筛选及能量、最大原子力和应力分布。OptTraj、AIMD与DisConf分别对应优化轨迹、分子动力学与有限位移构型。

规模之外,训练与评测的独立性同样关键。OMC-train与OMC-bench在晶体和分子层面均无重叠,避免同一分子或同一晶体的近邻构型同时进入训练集与评测集。

近3500万条为完整构型资源总量,本文模型实际使用的是约207万条筛选子集,其中优化轨迹1218025条、AIMD 170103条、有限位移686093条。参考计算统一采用PBE-D3(BJ)方法,数据生成累计消耗约1300万CPU核时和20万GPU时。

二、用四类任务检验模型能否用于实际研究

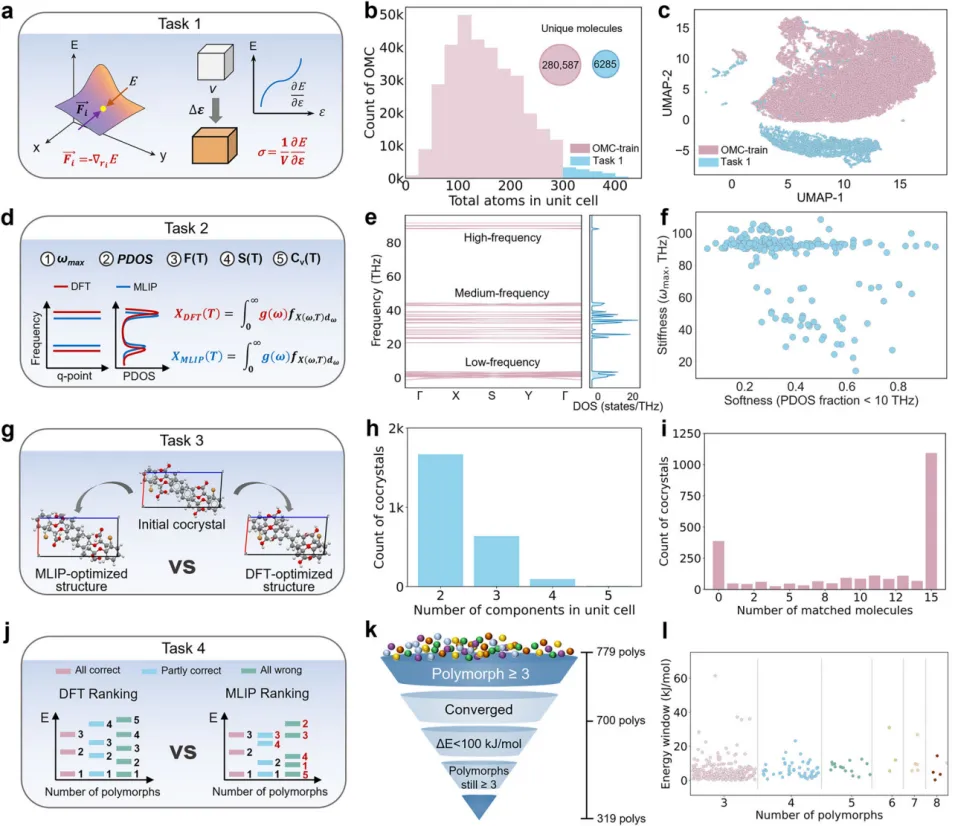
面向实际应用,OMC-bench将评测从单点预测延伸到结构优化、晶格振动与晶型能量排序,检验模型面对新化学环境和结构环境时的表现。评测集设置四类任务,共包含6775个独立晶体,部分结构用于多个任务。

图3|OMC-bench的四类任务。a—c:大晶胞力与应力预测;d—f:晶格动力学;g—i:共晶结构优化;j—l:多晶型能量排序。

大晶胞预测检验新环境中的迁移能力

第一项任务选取3099个独立晶体构型,每个晶胞含300—400个原子,而训练种子晶体均少于300个原子。研究基于SOAP结构描述符,采用兼顾与训练集的距离和测试样本多样性的采样策略,考察模型面对新分子与新堆积环境时的力与应力预测表现。

简单复制小晶胞也能得到大超胞,但局域环境基本不变。OMC-bench选取独立的大晶胞晶体,使评测覆盖化学环境与结构环境都发生变化的情形。

晶格动力学检验势能面局部形状

第二项任务包含200个经DFT声子计算确认动力学稳定的晶体,比较声子谱、声子态密度,以及由此得到的振动熵、自由能和热容。原子受到微小位移时,力如何变化,决定了势能面在平衡位置附近的曲率,也直接影响振动性质。

有机晶体同时具有高频的分子内振动和柔软的低频晶格运动。一个模型即使能在若干构型上预测准确的力,也未必能正确描述这些振动模式。因此,晶格动力学为单点力误差提供了重要补充。

共晶优化同时检验收敛与结构恢复

第三项任务包含2401个较难优化的共晶,来自21020个候选体系。筛选优先保留GFN2-xTB与DFT优化结果差异较大的结构,以考察模型在多组分、相互作用竞争更复杂的体系中的表现。

评测同时报告结构恢复失败率和几何偏差RMSD。失败率将优化失败与堆积不匹配都纳入统计,RMSD则衡量成功收敛结构与DFT参考结构的几何差异。两项指标结合,能同时考察几何精度与结构恢复的稳健性。

多晶型排序分辨微小能量差

第四项任务覆盖319个多晶型家族、1097个晶体,每个家族至少包含3种不同晶型。最低能与次低能晶型之间的PBE-D3(BJ)能量差中位数仅为1.49 kJ/mol,微小误差就可能改变排序。

任务采用两项互补指标:成对排序错误率KPE统计晶型两两比较时的逆序比例,完整排序准确率FRA则要求一个家族内的全部能量顺序均正确。它们衡量的是与PBE-D3(BJ)参考排序的一致性,不能直接等同于不同温压条件下的实验稳定性。

19个模型的比较显示不同任务需要不同能力

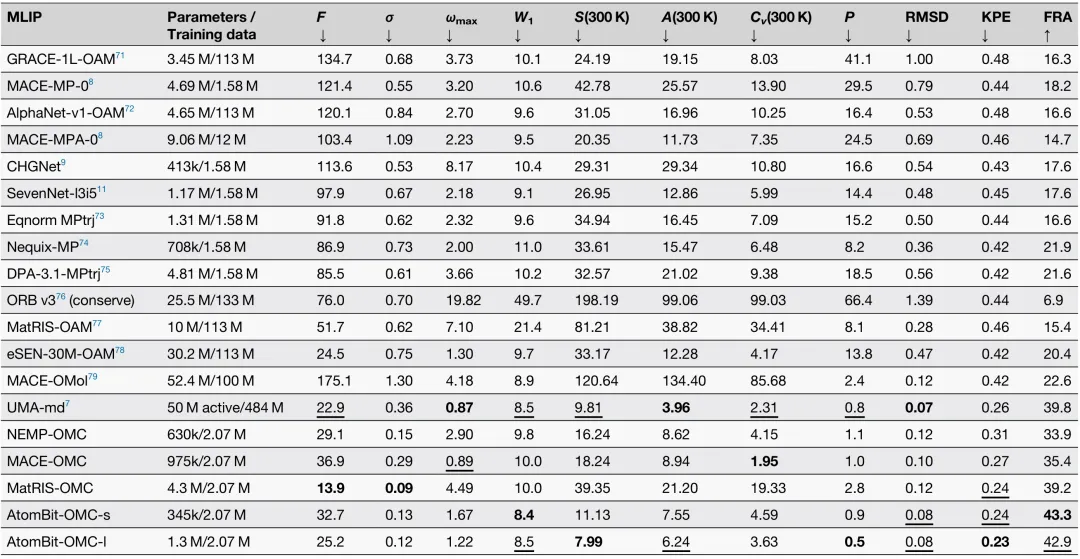
研究将现成预训练模型与在OMC数据上从头训练的专用模型放到同一组任务中加以比较。结果显示,有机晶体专用训练能让较小的模型获得有竞争力的表现;同时,各项指标的最优模型并不相同。

表1|19个模型在OMC-bench上的表现。F、σ为力与应力误差;ωₘₐₓ、W₁及S、A、Cᵥ分别衡量声子频率、态密度与振动热力学性质;P、RMSD衡量结构恢复;KPE、FRA衡量排序。箭头表示指标优劣方向,粗体和下划线分别标示最优、次优值。

单点力误差不能概括模型的全部表现。MatRIS-OMC的力平均绝对误差(MAE)为13.9 meV/Å,低于AtomBit-OMC-l的25.2 meV/Å;但在300 K振动熵上,两者误差分别为39.35和7.99 J mol⁻¹ K⁻¹。两项任务使用不同晶体集合,分别考察力值与势能面曲率,说明模型选型需要结合实际用途。

在共晶结构恢复上,AtomBit-OMC-l取得本次比较中最低的失败率0.5%,RMSD为0.08 Å。UMA-md的RMSD略低,为0.07 Å,失败率则为0.8%。对于批量筛选候选晶体,较低的结构恢复失败率意味着更多结构能够完成后续分析。

在多晶型排序上,参数量仅34.5万的AtomBit-OMC-s取得最高FRA,为43.3%,UMA-md为39.8%;AtomBit-OMC-l则取得最低KPE,为0.23。小、大两个版本分别领先不同排序指标,体现了紧凑模型在有机晶体专用训练下的潜力。

这些比较也标出了仍待解决的问题:即使最优FRA达到43.3%,仍有超过半数家族未能完整恢复DFT参考顺序。外部模型的训练数据、参考计算层级及与评测集的重叠情况也不尽相同,因此,这些结果反映综合任务表现,不能把差异单独归因于参数量或某一架构模块。

三、AtomBit将化学环境与空间方向纳入消息传递

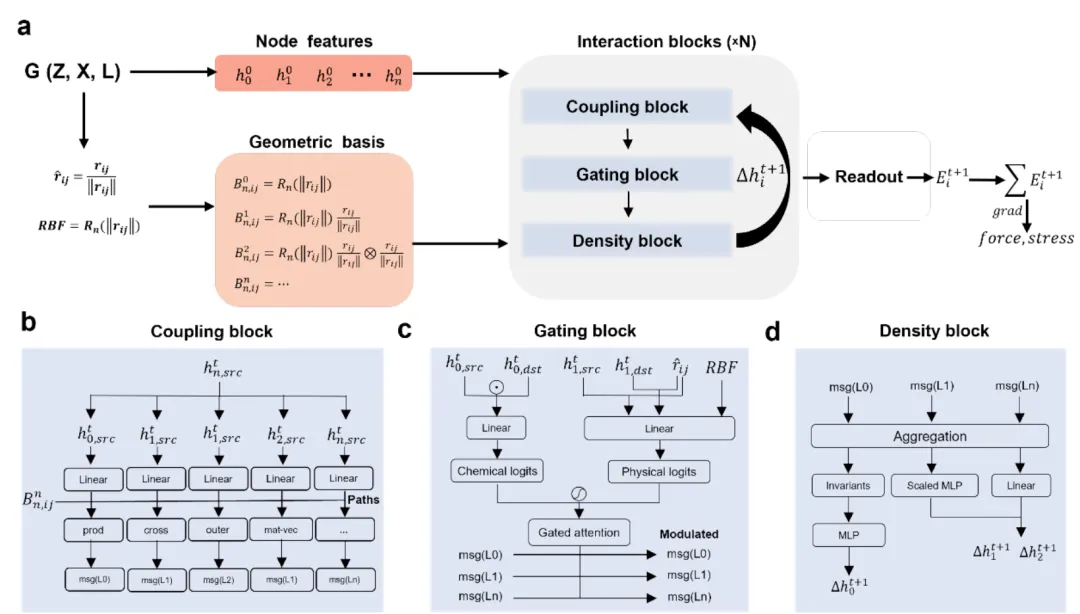
AtomBit是本研究提出的机器学习原子间势架构,以原子种类、位置和周期性晶胞为输入,学习体系势能,并由能量导数计算力与应力。在OMC数据上从头训练后,得到AtomBit-OMC-s和AtomBit-OMC-l两个版本,参数量分别为34.5万和约130万。

氢键、卤键等相互作用具有方向性,同样的原子间距离,在不同化学环境与空间取向下可能具有不同意义。为表达这些差异,AtomBit采用SE(3)等变的笛卡尔张量表示,并通过门控机制调节原子对之间传递的信息。

图4|AtomBit架构示意。原子与晶胞信息经张量耦合、门控及局域密度模块更新,再读出能量并求取力和应力。

低阶张量保留方向信息

模型使用标量、向量和对称无迹二阶张量三类通道。标量承载化学特征,向量和二阶张量表达方向信息。整体平移或旋转晶体时,能量保持不变,向量和张量按相应规律变换;这种等变设计将空间对称性直接写入模型,减少对不同朝向下同一物理环境的重复学习。

化学与几何共同调节消息权重

每个交互层先组合原子特征与原子间几何信息,生成不同阶的消息;随后,门控模块综合两端原子的化学特征,以及距离、方向等几何信息,为原子对赋予权重,增强或减弱对应消息。

这些权重以标量形式作用于张量消息,因此调节信息强弱时仍能保持等变性。门控由训练数据学习,并未额外加入一套显式的氢键或卤键作用能。

化学特征与方向特征在更新中相互作用

邻居消息汇聚为局域密度后,网络提取旋转不变量来更新标量特征,再由标量更新调节向量和二阶张量通道。这样,空间几何可以反馈到化学特征中,化学环境也持续影响方向性信息的表达。

消融结果支持门控与方向性表示

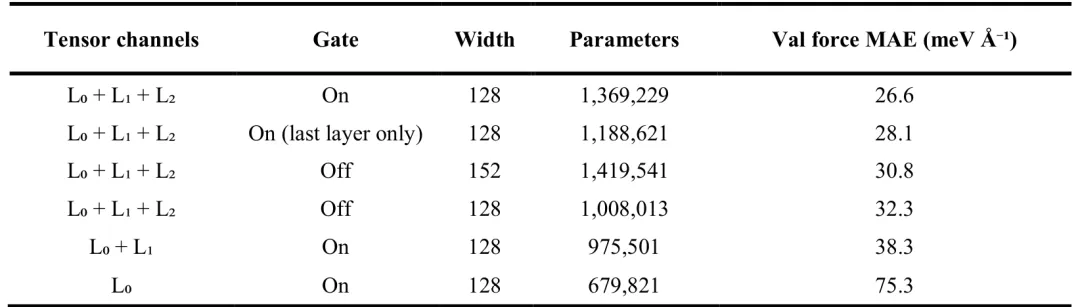
门控设计带来的收益能否由简单增加参数替代?补充材料表S10比较了不同门控与张量通道配置,评价指标为验证集力MAE,并与OMC-bench第一项任务的结果分别统计。

表2|不同门控与张量通道配置的验证集力MAE。L₀、L₁、L₂分别代表标量、向量和二阶张量通道,Width表示特征通道数。

完整配置的力MAE为26.6 meV/Å。移除门控后,同为128通道的配置误差增至32.3 meV/Å;将无门控配置加宽至152通道、使参数量略高于完整配置后,误差仍为30.8 meV/Å。完整配置相对这一加宽对照的误差低约13.6%,支持门控机制在该设置下的有效性。

仅在末层保留门控时,误差为28.1 meV/Å;去掉二阶张量通道后为38.3 meV/Å,仅保留标量时为75.3 meV/Å。这些结果支持逐层门控与方向性表示的组合,但不同通道配置的参数量也随之变化,应结合整体配置理解。

为适应不同晶胞带来的计算负载差异,研究还按原子数与连接边数估计样本成本,动态组织训练批次,改善负载均衡。除PyTorch实现外,AtomBit也支持基于MindSpore的Ascend NPU训练与推理。

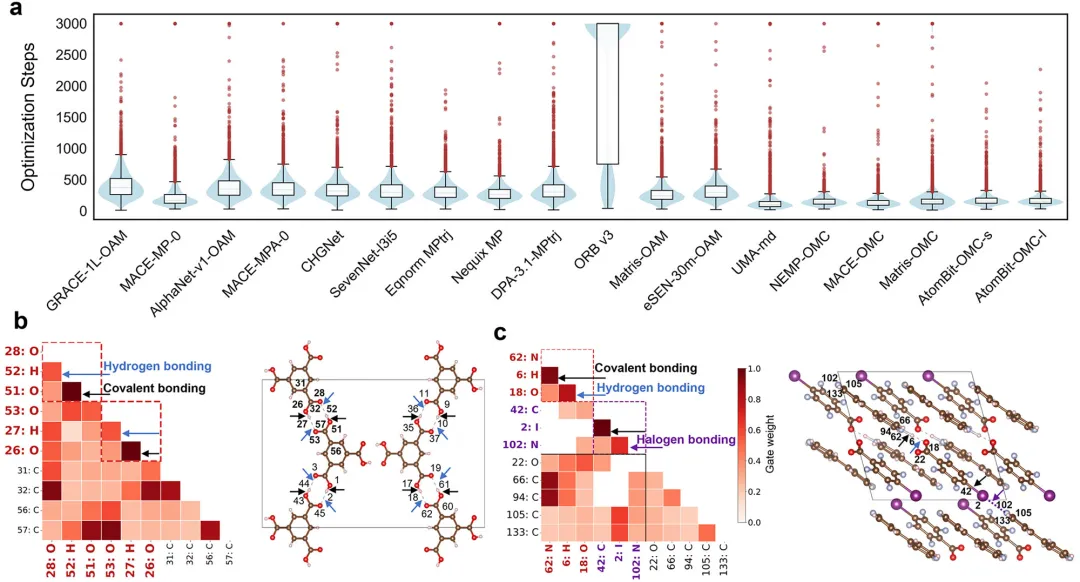
图5|AtomBit-OMC的优化收敛表现与门控权重。a:几何优化步数分布;b、c:代表性晶体中的门控权重及局域化学接触。

在实际结构优化中,两个AtomBit版本通常需要更少的收敛步数,迭代次数分布的长尾也更轻。对于需要反复弛豫候选晶体的工作流程,这种表现有助于减少耗费大量迭代的困难案例。

门控权重还提供了观察模型如何利用局域环境的窗口。在代表性晶体中,较高权重出现在部分共价接触,以及氢键和卤键区域。原子对分类分析显示,高权重连接中共价接触富集;删边分析进一步表明,移除高权重连接对力预测的扰动明显大于移除低权重连接。

这些结果支持将门控权重用于定性分析消息传递的重要性,帮助研究者理解哪些局域接触更影响预测。权重不能直接解释为单条化学键的作用能,也不等同于经过校准的置信度。

从实验结构构建数据,以实际任务检验模型,再用模型诊断改进设计,本研究为有机晶体机器学习势提供了可复用的研究基础。OMC-bench、OMC数据资源与AtomBit-OMC可支持候选晶体的结构优化、振动分析和能量排序;进一步提高竞争晶型微小能量差的预测精度,将是推进可靠晶体筛选的重要方向。

论文:Lu, M., Zhao, C., Hu, S., et al. OMC-bench and AtomBit-OMC: task-aligned benchmarks and robust, interpretable machine-learned interatomic potentials for organic molecular crystals.

期刊:npj Computational Materials (2026); DOI:10.1038/s41524-026-02315-3

数据集:CSD OMC MLIP Collection(CCDC 下载页面中的同名条目)

https://www.ccdc.cam.ac.uk/support-and-resources/downloads/

评测平台:https://aisci.ustc.edu.cn/mlip-omcs/#/

代码:https://github.com/pic-ai-robotic-chemistry/OMC-bench
随机文章