一个能主动干活的家用机器人,早上看你要做燕麦粥,提前把碗从柜子里拿出来放在台面上。听起来是好事。除非你本来打算端到餐桌上吃,现在得先去台面上找碗。
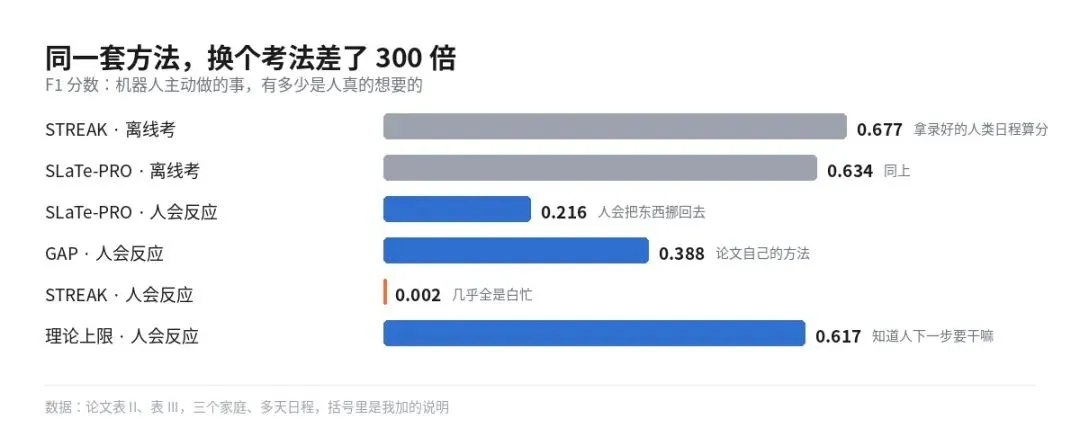
佐治亚理工交互计算学院的两个人 9 月 24 日往 arXiv 挂了篇文章,专门算了这笔账。他们把前人做的两套「主动帮忙」方法拉进一个会还嘴的评测环境里重跑了一遍,其中一套的分数从 0.677 掉到 0.002。
不是模型变差了。是考法变了。
以前的考法,人是不会动的
这类研究过去怎么评分?拿一份录好的人类日常行为记录,让模型去猜下一步人要干什么、该提前做什么,猜中算对。整个过程里,机器人做的事不会反过来改变记录本身。人还是按原计划把碗从柜子里拿出来,哪怕碗已经在台面上了。
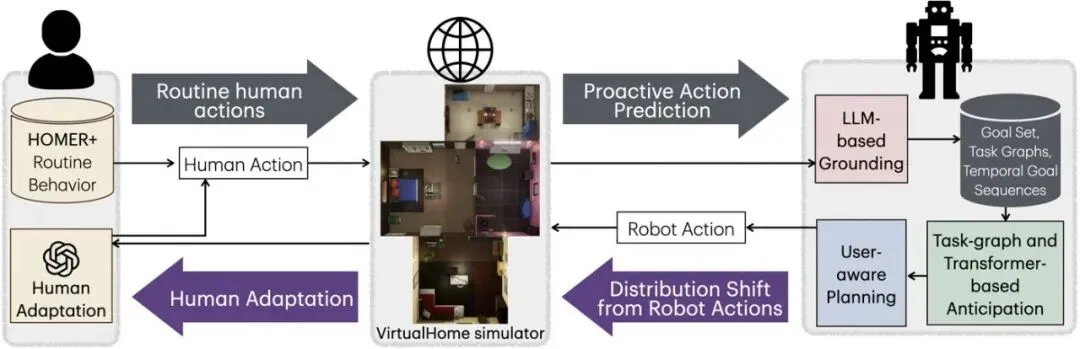
这篇文章把人换成了会反应的。他们在一个虚拟家庭环境里把这条链路接了起来:机器人放错了位置,住户可以接受、可以挪回去、也可以将错就错在台面上把粥冲了。住户的后续动作跟着变,机器人下一步看到的场面也跟着变。
论文图 3:紫色那两个箭头是新加的,机器人的动作会改变人的行为和后面的观测
代价是评测一下子变贵了,也变吵了。好处是它终于开始衡量一件真实的事:这个忙,帮完之后人是轻松了还是更累了。
有一套方法,越帮越忙
灰色是老考法下的成绩,橙色那条是同一个方法换成会反应的人之后
表里最刺眼的是 STREAK 那一行。离线 0.677,换成会反应的人 0.002。
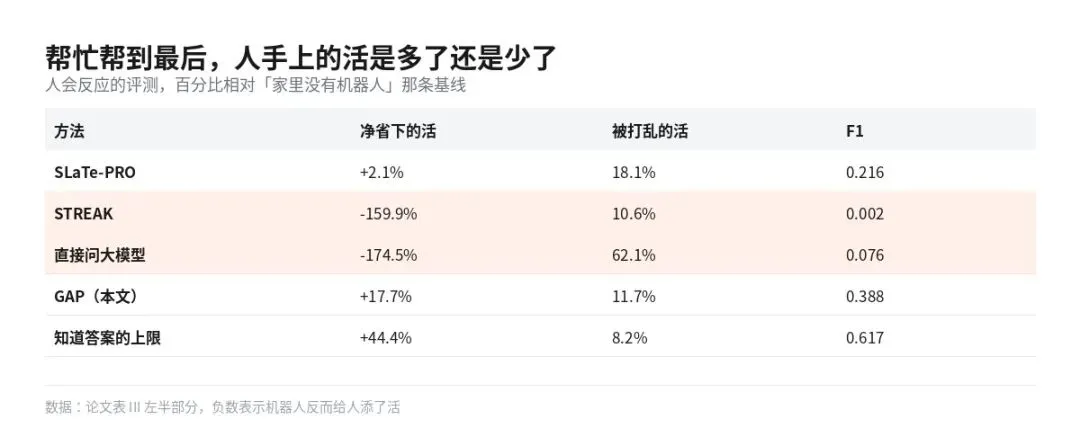
更直观的指标是「净省下的活」,算法是:人被省掉的动作,减去人为了纠正机器人而多做的动作。STREAK 在这个指标上拿到 -159.9%。翻译一下,机器人干预之后,住户要做的事比家里没这台机器人的时候多出了一倍半。直接拿一个通用大模型当决策器更惨,-174.5%,而且它弄乱了 62.1% 的动作。
橙色两行是净省下的活为负的,也就是帮倒忙
作者自己那套方法 GAP 拿到 +17.7%,被打乱的动作 11.7%,是唯一一个在新考法里还能站住的。但离知道答案的上限 44.4% 还差得远。这个数字我反而觉得是全文最有用的一条:主动帮忙这件事,就算作弊知道人接下来要干嘛,也只能省下四成多的活。
它到底测的是什么
我第一反应以为这是个老生常谈的「仿真和真实有差距」的故事,读完才发现不是。差距不在仿真器,在评分函数里那个不会动的人。这个人一旦开始适应机器人,原来排第一的方法就崩了,原来的分数不能拿来做任何推断。
作者在局限那节写得很直接:住户的反应模型是拿一个大模型当代理演出来的,目标集合也只能取自那份行为数据集,真正的人怎么适应机器人,需要长期的真人研究才知道。他们还假设每个动作的代价一样重,而「去找一个被机器人收错地方的碗」显然比「把碗拿出来」烦得多。
这个坦白很重要。它等于说,这篇文章给出的不是新的正确分数,是一个更难作弊的考场。
我在意的是另一层。家务这件事里,判断「现在该做什么」本身就是活,心理学上有个说法叫认知负担。机器人抢着做决定的时候,它其实是在替人做这部分判断。判断对了,人省一次思考;判断错了,人不光要收拾残局,还得先意识到残局是怎么来的。
所以我现在看到「主动」两个字会先问一句:这台机器做错了的时候,是谁来收拾。你家里那些会自己做决定的设备,有几个是你事后要去纠正的?
参考资料
论文:https://arxiv.org/abs/2609.28910