画面像照片,策略就买账吗?现有闭环仿真常「画得像」却「害决策」——DriveArena 比游戏引擎更照片级,策略分数反而更低。笔者这次读的是 UCLA 与丰田研究院的 DreamStream(CoRL 2026):物理仿真器管交通、自回归视频模型管画面,再用五个公开 E2E 策略的特征算 sim-to-real 距离 FDπ。NAVSIM 上 FDπ 比最强基线好 4.7 倍,还把静态基准改造成交互考场 Navhard-CL,暴露出 scorer 偏置、提案覆盖不足和视觉脆弱三大失败模式。
链接速览
📄 论文:DreamStream: Towards Policy-Oriented Generative Simulation for End-to-End Driving(UCLA & Toyota Research Institute,CoRL 2026)
🔗 https://arxiv.org/abs/2609.26792
🌐 项目页(三件套 TL;DR + 闭环工作流演示):https://vail.cs.ucla.edu/DreamStream/
🐙 代码(官方仓库,README 标注 Code Release: Coming soon,可先 star):https://github.com/VAIL-UCLA/DreamStream
先看结论
- 一句话定位:端到端(E2E)驾驶的闭环评测仿真器——物理仿真器管交通状态,自回归视频模型把状态「渲染」成策略真正吃的相机帧;配套 FDπ 指标 + Navhard-CL 基准。三件事一体成型。
- 核心洞察一句话:闭环评测要的不是「照片级」,而是「策略相关特征级」——车道线画歪、agent 位置漂 2 米,都会改变策略决策;FID 这类人眼感知指标会误判谁更保真。
- DreamStream 怎么做:三步循环 Plan → Simulate → Generate——策略出轨迹、仿真器只走 replan 周期并投影 HD map + 3D box 当 layout 条件、视频模型带 KV cache 自回归出帧。视频模型从预训练视频基座三段蒸馏(可控 → 少步 AR → Self Forcing 长时稳定),外加 traffic-guided distillation(layout 上做 CFG)和 diverse-scene distillation(合成片段保住天气多样性)。
- FDπ 是什么:对五个公开 E2E 策略(DrivoR、DiffusionDrive、LTF、RAP、SparseDriveV2),分别抽「真实帧 vs 生成帧」的 scene-context 特征算 Fréchet 距离,归一化后取平均。用策略自己的特征空间量 sim-to-real,0 = 完全对齐。
- 数字账本:FDπ 在 nuScenes 7.27(比最强基线 HUGSIM 11.68 好 1.6 倍)、NAVSIM 5.47(比 DriveArena 25.45 好 4.7 倍);与闭环驾驶分的相关性远强于 FID/FVD(held-out r=−0.65 vs FID +0.11)。
- Navhard-CL 暴露的失败模式:scorer 偏置(DrivoR 换 oracle scorer 涨 +14.17 DS)、提案覆盖不足(对抗场景下 DS 掉 12.98~16.66)、雨雪比夜晚更伤(DS 88.44→约 81.7)。
- 要泼的冷水:论文自认仍在仿真里评测、不上实车;长时 rollout 仍有漂移;GitHub 仓库代码尚未放出(Coming soon);FDπ 依赖策略面板,换面板会动数值。
背景:开环高分 ≠ 会开车,闭环仿真两头堵
E2E 策略把传感器直接映射成动作,所以靠谱评估必须闭环:环境要对动作有反应。但现有平台两边都差口气——
- 物理仿真器(MetaDrive、GPUDrive 这类):交通可控、物理自洽,但渲染有明显 sim-to-real 视觉缝,策略感知会被污染;
- 生成 / 重建仿真器:画面更真,但视觉域窄(多在 nuScenes 风格里打转),还常常牺牲可控性。
更麻烦的是尺子本身不准。FID 量的是「人眼/通用感知」的分布距离,在小域驾驶数据集上有偏;3D 检测、地图分割这类可控性指标,量的是模块对齐,未必是策略决策用到的那部分信息。
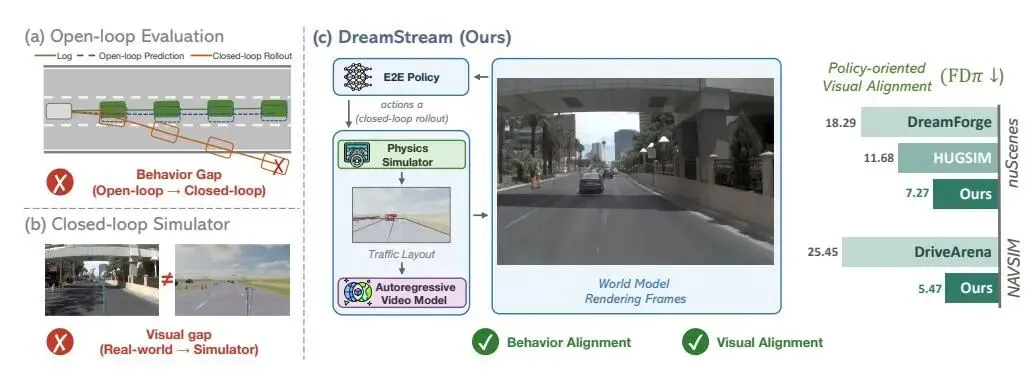
▲ 论文题图(Figure 1):现有基准要么不做行为测试,要么因 sim-to-real 失真评测不忠实;DreamStream 用「策略导向的视觉对齐 + 有根交通」补上闭环
笔者读到这里最在意的一个观察藏在实验里:DriveArena 比游戏引擎 BridgeSim 更照片级,策略在 DriveArena 下的分数反而更低。这直接打了「画质越高评测越真」的脸——也解释了为什么这篇论文要先造尺子、再造仿真器。
核心内容
DreamStream:仿真器管状态,视频模型管像素
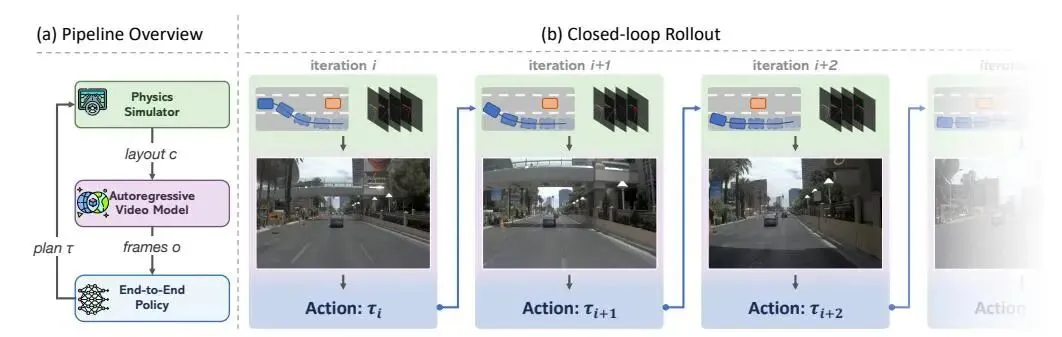
▲ 框架总览(Figure 2):闭环每轮 Plan → Simulate → Generate,layout 条件来自物理仿真器的 HD map 透视投影 + agent 3D box
三方解耦:
- 物理仿真器 S:维护 ego 位姿、周车、HD map;周车可走 log-replay、IDM 或对抗策略;
- 自回归视频模型
 :把符号状态翻译成相机帧——策略根本看不见仿真器内部,只吃生成的观测;
- 被测 E2E 策略 π:最近
 帧 → 规划
 步轨迹;仿真器只执行前
 步(replan 周期),然后重新问策略。
场景起点两种:真实驾驶日志转进仿真器( 取对应日志帧),或图像模型合成的安全关键变体。
视频模型三段蒸馏 + 两个保真开关
从预训练视频基座出发(消融用的是 Wan 2.1):
| | |
|---|
| 训可控条件生成器(layout + 首帧锚点 → 未来视频) | |
| teacher→student,用真值历史蒸成少步 AR | |
| | |
两个关键组件:
- Traffic-guided distillation(TGD):Stage-1 以
 把 layout 换成
 (去掉交通 layout、保留首帧 CLIP),推理时按 CFG 把有条件/无条件预测外推,不加数据、不训分类器,就让车道和 agent 贴住仿真状态。消融:FDπ 从 12.18 压到 9.50。
- Diverse-scene distillation(DSD):驾驶日志天气太窄,学生会「忘记」基座的天气先验。用现有场景合成多样外观 clip 喂 Stage 2/3。消融(rollout 第 100 步与天气文本的 CLIP 相似度):Night 0.2679→0.2796、Snow 0.2516→0.2722、Rain 0.2421→0.2475;没有 DSD 时模型会快速跌回训练集的「晴天脸」。
长时稳定靠 早期 latent 当 KV cache:漂移被压住(nuScenes 缓解 68%、NAVSIM 48%),但仍非零——论文如实列为 limitation。
FDπ:用策略的尺子量策略的世界
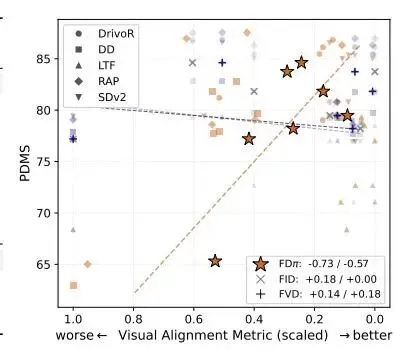
▲ FDπ / FID / FVD 与开环 PDMS 的相关性(Figure 3):FDπ 与驾驶表现负相关且明显更紧,FID/FVD 几乎躺平
做法很直接:对策略面板里每个  ,从真实帧和生成帧各抽一份它做决策用的 scene-context 特征,当成两个高斯算 Fréchet 距离,再除以
 做跨架构归一,最后对五个策略取平均。
为什么这比 FID 靠谱?三个证据:
- 相关性:held-out 设定下(特征和行为来自不同网络)FDπ 与 PDMS 仍
 ,FID 平均
 、FVD
 ——后两者基本不相关甚至反向;
- 难例敏感:Navhard 540 条挑战场景上 FDπ 比随机子集多涨 20%;
- 局部错误敏感:1,517 条 nuScenes 注入「agent 挪 2 米 / 抹掉车道」后,FDπ 反应是 FID 的 2.3 倍。
Navhard-CL:把 NAVSIM 从「静态录像」变成交互考场
三桶场景:Navhard-Base(真实 log)→ AdvBehavior(对抗 agent,制造安全关键交互)→ AdvWeather(同场景换恶劣天气/光照/路面)。
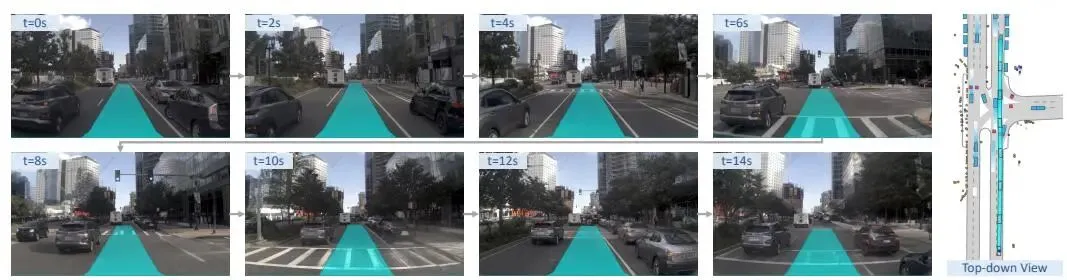
▲ 闭环评测定性示例(Figure 5):策略在 DreamStream 渲染的观测上滚动,周边车可 IDM/对抗控制
核心公式
Traffic-guided distillation 的 CFG 外推(Eq. 1):
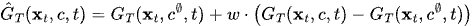
大白话:有条件和无条件两次预测外推,把去噪往「更贴 layout」的方向拧——和 Stable Diffusion 的 CFG 同构,但条件是交通 layout 而不是文本。
策略特征的 Fréchet 距离(Eq. 2):
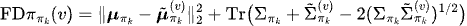
大白话:标准 FID 那把尺,但特征换成策略自己用的 scene-context 特征——量的是「策略看见的世界被改了多少」。
跨策略平均(Eq. 3):
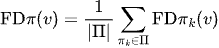
大白话:五个公开 E2E 策略各量一把再平均,避免「只讨好某一个架构」。报告时  。
数据与案例
FDπ 主表(Table 1 节选,越低越好; 表示基线在评测集上训过):
| | |
|---|
| | |
DriveArena | | |
HUGSIM (nuScenes 最强基线) | | |
| 7.27 | 5.47 |
nuScenes 上 11.68→7.27 就是标题里 1.6 倍的出处;NAVSIM 上 25.45→5.47 约 4.7 倍。注意 FID 列并不总跟 FDπ 同步(DreamStream FID 19.58 并非最低)——尺子不同,排名就不同,这正是论文的论点。
闭环分数随观测来源变(Table 2a,Navhard-Base,DS 越高越好):
四个策略全线:DreamStream 观测下分数最高;更照片级的 DriveArena 反而普遍低于游戏引擎 BridgeSim——「画得像」不等于「评得真」。
失败模式拆解(Table 2b/2c):
- Scorer 偏置:把学习 scorer 换成 oracle scorer,Base 上 DrivoR 就能 +14.17 DS,AdvBehavior 下 DiffusionDrive 再 +8.98——打分头本身就在坑自己;
- 提案覆盖不足:即便 scorer 是 oracle,从 Base 到 AdvBehavior 仍掉 12.98~16.66 DS,连无打分头的 LTF 也掉 14.61——轨迹解码器提不出安全选项;
- 视觉脆弱:高分场景(DS≥80)下 DrivoR 遇雨雪掉到约 81.7(原 88.44),比夜晚更伤,且集中在可行驶区域合规、车道保持——窄视觉域基准根本测不到这一刀。
效率(Table 5,单张 RTX PRO 6000):生成约 20.2 fps、显存 32 GB(开 KV cache;关 cache 则 59 ms/帧、16.9 fps、67 GB),仿真侧约 10.1 fps;全文训练成本约 200 A100 GPU-days。
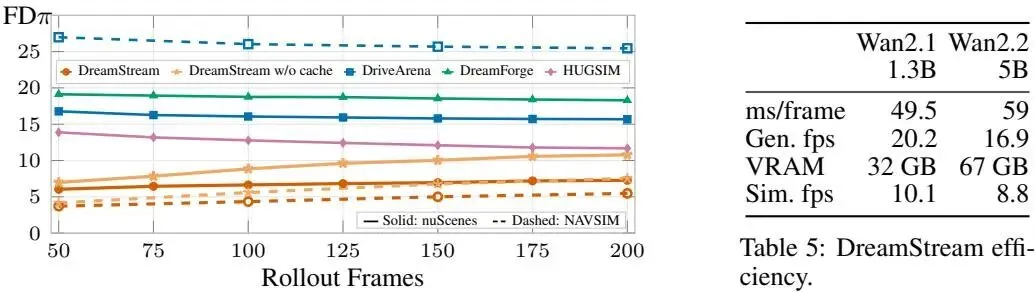
▲ 长时 rollout 的 FDπ 漂移(Figure 7):DreamStream 有界且始终低于基线,KV cache 进一步压漂
思考与启发
- 「策略导向保真」是世界模型评测被漏掉的第三条轴。前几天写的 WorldCrafter 在视频世界模型里认真填「持久状态」,这篇在驾驶仿真里填的是「下游决策可用性」——两者都在说:感知质量指标(FID/VBench)不够,要问「消费者」认不认。笔者预计这个思路会渗到具身仿真、游戏引擎世界模型的评测协议里。
- FDπ 的构造方法比分数更可迁移:找一个(或一组)下游消费者的特征空间,在这个空间上量生成分布距离。把它换成机器人策略的 observation encoder、换成 LLM 的 logit 分布,都是同一个 shape。真正难的是选谁当消费者——论文用五个公开策略组成 panel,held-out 实验(特征与行为来自不同网络)是为了防「自己量自己」,这一步设计得很干净。
- TGD 是「不加数据就补可控性」的巧劲。layout CFG 和文本 CFG 同构,却对准了车道几何/agent 位置这类策略敏感但人眼不敏感的误差。消融 FDπ 12.18→9.50 说明蒸馏时「听话」比「好看」更值钱。DSD 则反过来保住基座的外观先验——蒸馏既是压缩也是遗忘,驾驶小数据会把天气先验洗掉,这坑做任何领域蒸馏的人都会踩。
- Navhard-CL 比 DreamStream 本身更「可持续」。把 NAVSIM navhard 从静态开环掰成对抗 + 天气闭环,暴露的 scorer 偏置、提案覆盖、视觉脆弱三条,都是能直接指导训练改进的 failure mode。benchmark 的生命力在于「测出别人测不出的病」——和 WorldCrafter 的闭环重访协议一样,评测协议往往比单点模型活得久。
- 给想上手的朋友:项目页信息密度够用(三件套 TL;DR + 工作流动图),但 GitHub 目前只有 teaser 和 bibtex,README 写着 Code Release: Coming soon——复现还得等。可先对着 arXiv 附录 B 的三段蒸馏公式和 B.3 的 DSD 合成流程搭架子;配套的 BridgeSim(同组,arXiv 2604.10856)是理解「开环-闭环缺口」的好前置阅读。
- 两点保留:其一,FDπ 的绝对数值绑定策略面板,换 panel 排名可能动,横向比要用同一 panel;其二,「闭环」仍是在生成观测里闭环,真车、硬件在环(HIL)的成本与安全问题论文明确留白——仿真里更像真,离路上真还差一层。
参考资料
- 论文:DreamStream: Towards Policy-Oriented Generative Simulation for End-to-End Driving(arXiv:2609.26792):https://arxiv.org/abs/2609.26792
- 同组前置工作 BridgeSim: Unveiling the OL-CL gap in end-to-end autonomous driving(arXiv:2604.10856):https://arxiv.org/abs/2604.10856
- NAVSIM 基准(navtest / navhard 来源,CoRL 2024):https://arxiv.org/abs/2406.15349
