为什么一定要做大模型 评测?
为什么一定要做大模型 评测?
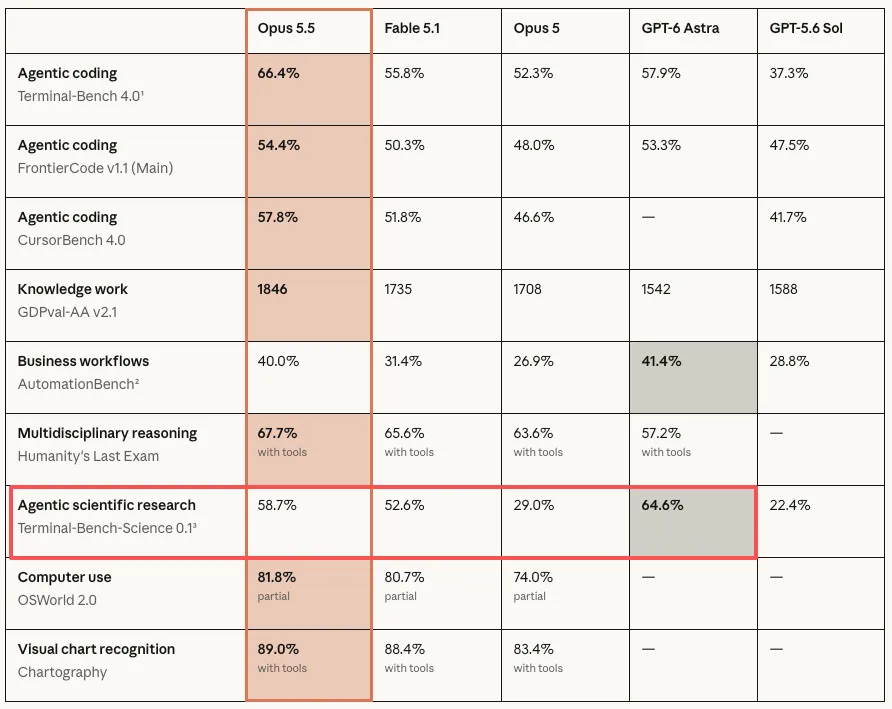
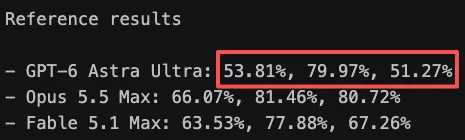
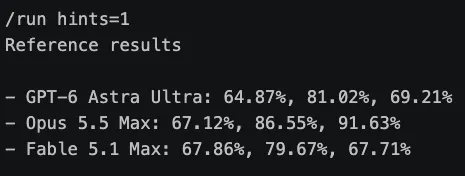
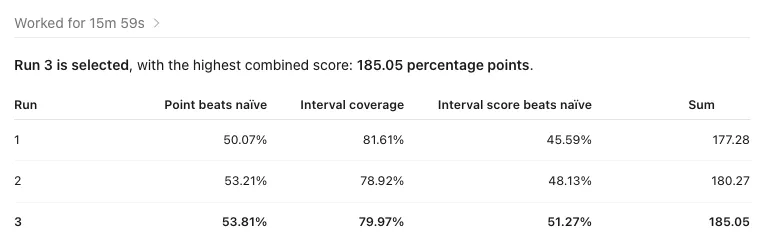
先说个好消息, 我们Sponsor 的第一个Final Approved 的PR刚刚诞生了! 尽管我自己的还没PR呢, 但不妨碍为这么有才华的年轻人感到高兴呀. 而且更巧的是, 世界如此之小, 居然和我当年的博士生导师在一个Department! 几件事凑到一起, 感觉我可以北上一趟了.好了, 回到标题的问题. 答案特别简单: 大模型的能力不是均匀的! 而这个对于应用层极为重要. 大家一定要从“战略角度”看这个问题, 可以说对于所有做应用层的人/公司都必不可少的一点. 一定要自己针对自己的问题做Specific评测, 然后再在上面“盖房子“. 下面举个非常非常实际的例子. 想搞资本市场的经济/金融数据预测. 用啥大模型? 在不同模型给你不同答案的当下, 到底听谁的? 我们先看Anthropic最新Opus 5.5发布时候的稿件 www.anthropic.com/claude-opus-5-5. Anthropic 自己说Opus 5.5 在科学上比Fable 5.1强, 但弱于 GPT-6 Astra. Wow, Anthropic自己都说别人家的模型更好, 我要搭建这个经济/金融预测模型是不是就应该直接上Astra了? 看似不复杂的问题吧?Until, 因为搞Terminal Bench Science, 我过去这么多天 天天跟它搅到一起, 下面是结果 (几组数值越大越好):Specifically 在我这个应用问题上, Astra不仅翻车, 而且翻大车了.在没有Hint的情况下严重偷懒, 15分钟就给我交差, 哪怕用Ultra Reasoning也是一塌糊涂.然后我提供Hint, 让它干满了几个小时, 有了显著提高, 但也还是不行!最好的反倒是Opus 5.5, 也不是更贵/”普遍更先进“的Fable 5.1.所以回到核心问题: 如果我想在经济/金融数据上做预测产品, 应该用什么底层模型? Opus 5.5, 而非人云亦云/Anthropic自己都说好的Astra!为什么会这样? 因为在模型的Post Training 阶段, 可以说吃什么长什么. 而数据这个东西其实是没谁可以吃下全部的. 那么自然, 如果它在某一个领域吃的多/好, 自然能力强, 反之亦然~. 另外也不是吃的好东西越多, 训练出来的结果越好, 有些时候不同领域数据会有互相干扰问题. 最好就是Focus+吃好的.而且评测这事一定得自己做, 别人的评测是别人的问题. 直接抄作业不Fit自己的任务啥用都没有.所以我个人为啥对这个事这么有热忱? 按理说我也不需要刷Paper呀, 那还非得自己亲自去搞? 因为, 这个事, 远不止表面刷Nature/Science Paper+高Citation 这么简单, 而是有极为实际的科研/产品用途. 可以说是下面whatever近一步应用层/自动化科研/Smart Router 的核心地基之一.
本文来自网友投稿或网络内容,
如有侵犯您的权益请联系我们删除,
联系邮箱:wyl860211@qq.com 。