AI产品今年最该补的能力:不是原型,是评测体系
过去做产品,习惯先把功能做出来,再靠灰度和反馈兜底。但AI产品不一样:模型会变、提示词会变、知识库会变、工具调用会变、权限边界还会跟着角色变。
真正决定AI产品能不能上线的,不再只是交互和原型,而是你有没有能力提前定义什么叫好、什么叫稳、什么叫可控。
01 为什么评测变成主战场
传统软件问题通常是确定的:按钮错了、接口挂了、字段映射错了。AI产品的问题是:同样一个问题换个说法,结果可能不一样;知识库更新一次,回答质量可能就变了。
所以AI产品真正要回答的是三个问题:这东西在真实场景里好不好用?它在哪些场景会失控?每次更新之后是变好了还是悄悄退步了?
02 传统指标为什么不够用
DAU、留存、满意度这些指标当然有价值,但它们是结果层指标,解释不了AI为什么好或为什么坏。
AI产品最容易出现局部失败:整体数据看起来没问题,关键场景错一次,用户信任就掉了。
03 四层评测框架
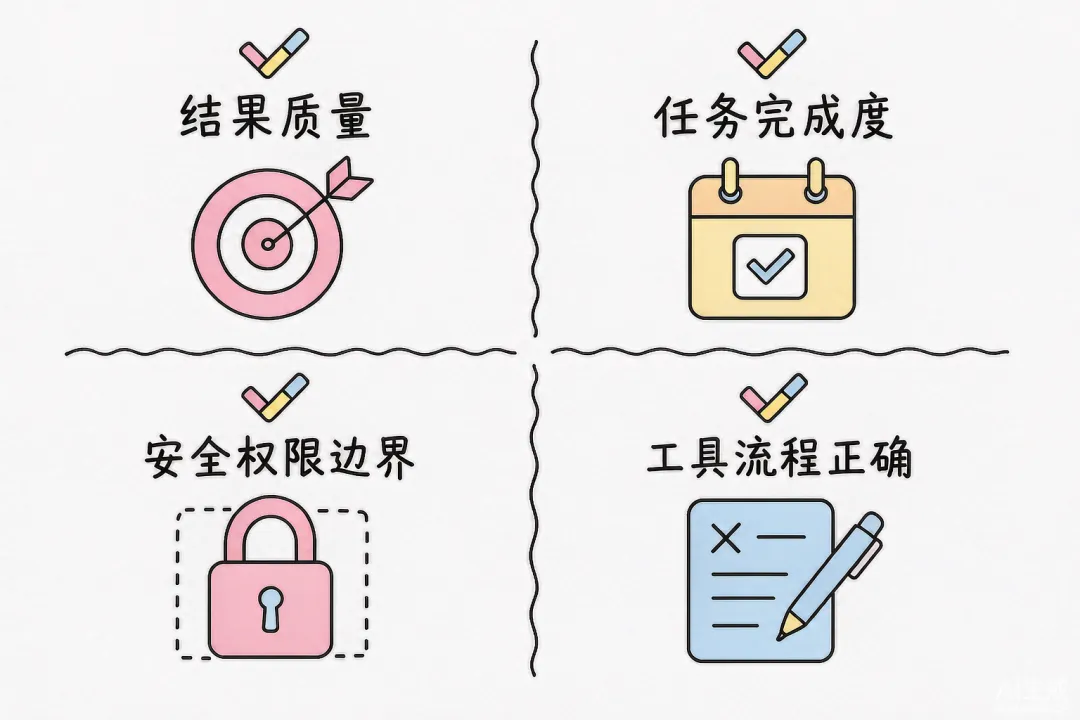
第一层,结果质量。回答有没有解决问题,是否完整、准确、清楚。
第二层,任务完成度。有没有真正把事情做完,而不是答得像。
第三层,工具与流程正确性。调用的工具对不对、顺序对不对、该升级人工时有没有升级。
第四层,安全与权限边界。不同身份拿到的知识和可触发动作本来就不一样,评测不带身份上下文,高分可能是假高分。
04 从场景开始,不是从指标开始
有效的评测应该先找高价值真实场景,再补真实表达,最后定义每类场景的成功标准。测试集不是技术附件,而是需求定义的一部分。
05 上线前后分别该做什么
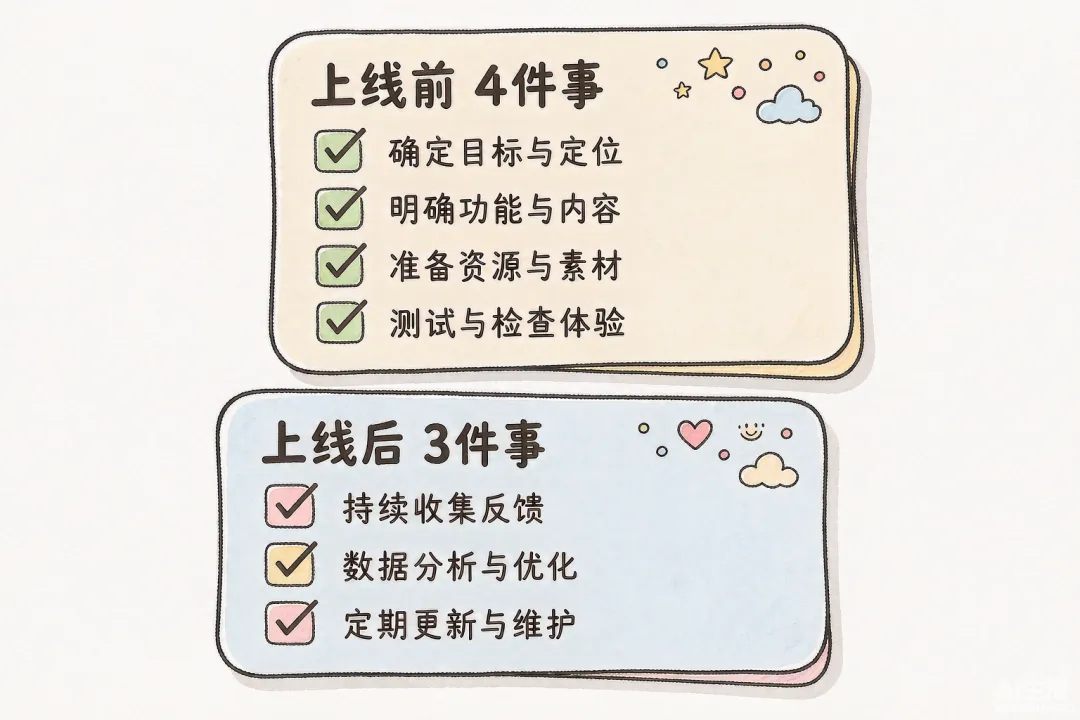
上线前:选出20到50个高价值真实场景;为每个场景定义通过标准;配置质量、能力、工具流程三类评分逻辑;用不同身份跑一遍。
上线后:每次改提示词、模型、知识库或工具都跑回归;不只看平均分,更要看失败是否集中在高风险场景;把评测结果接到迭代优先级。
06 可复制指令
让AI帮你生成一个最小评测集:
你是一个AI评测设计师。请针对以下AI助手/Agent的场景,生成20个高价值测试用例,每个用例包含:场景描述、用户输入、预期成功标准、可能的失败模式。覆盖模糊表达、混合意图、半截问题、权限边界等情况。用中文输出。
写在最后
AI产品经理的竞争力,正在从做功能转向做可信的能力系统。如果你的团队已经在做AI助手、知识问答或自动化Agent,先别急着加功能,先问一句:你们有没有一套每次更新后都能证明自己确实变好了的评测体系?
收藏这篇文章,下次更新模型前先把评测集跑一遍。