MySQL 应用实战(66):分片键怎么选,选错分片键等于白拆
- 更新时间 2026-09-27 21:04:57
大家好,在上一篇文章中有这样一个案例:有个团队把订单表按订单号 hash 分了 8 片,数据分布非常均匀,表面看起来非常完美,但结果 C 端用户想要“查我的订单”时,却没办法在一个分片中查询出来,而是要到 8 个库中,因为这个场景下,知道的是user_id,而不知道订单号,分片反倒是帮倒忙了。
从这个案例暴露了一个问题:数据均匀 ≠ 分片键选对了。分片键是分库分表里唯一一个“上线后几乎不可能改”的决定,因为表都拆了、数据存进去了、业务也跑起来了,再想换分片键,等于把整个集群重新搬一遍家(重新做分库分表,这重复工作领导肯定不批)。
针对这个问题,今天就业讲讲水平拆分最核心的问题:分片键和路由算法到底各管什么、选分片键的四条标准、卖家和买家两个维度都要查怎么办(基因法)、大卖家把数据压歪了怎么办,以及几个选错等于白拆的真实事件。
一、分片的策略
在实施分库分表前,先来看看什么是分片键和路由算法。很多人经常混淆这两个概念,在这时有必要搞清楚。以 ShardingSphere 的术语体系为准(第 64 篇说过,它是分片中间件的代表),分片策略 = 分片键 + 分片算法:
分片键(sharding key):即是用哪个字段的值来划分库与表。比如订单表的 user_id、order_id、created_at等都可选一个;路由算法(sharding algorithm):根据选择的分片键的值算出新值,并确定如何映射到库与表中。比如 user_id % 32、按时间切范围、查表映射,任选一种。
分片键决定用什么算,路由算法决定怎么落到片(库/表),两个都是一次性的架构决定,但分片键的优先级远高于路由算法:路由算法选错了,扩容时难受;分片键选错了,每一天都难受。
这里有一个分片第一性原理要记住:SQL 里带了分片键,中间件才能把请求精确路由到一个片;不带分片键,就会退化成全分片广播,即把所有片都查一遍,归并结果再返回。ShardingSphere 官方文档原话:SQL 中如果无分片字段,将执行全路由,性能较差。所谓选对分片键,本质上就是让绝大多数 SQL 天生带着它。
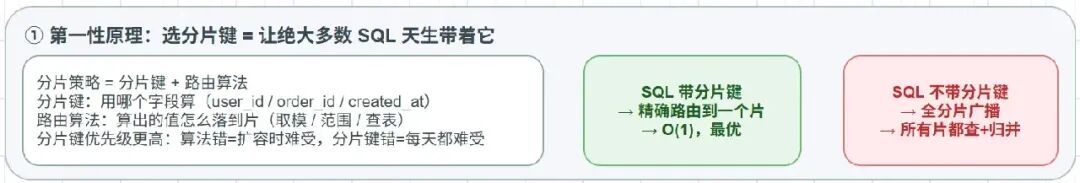
二、分片键的四条选型标准
把第一性原理展开,一个好的分片键要同时满足四条:
(1)贴着最高频的查询维度,核心 SQL 必带它: 这是最重要的一条标准,直接决定广播次数。统计一下你的核心 SQL:80% 的查询 WHERE 条件里都带 user_id?那 user_id 就是天选分片键。反过来,如果高频查询五花八门(按商家、按时间、按状态),先想清楚哪个维度不能忍广播,再定分片键。
(2)基数要高: 分片键的取值范围必须远大于分片数,数据才能摊开。拿性别、省份、订单状态这些字段当分片键,几个片永远空着、另外几个片挤爆(这是低基数陷阱),这种键是不能当分片键的。
(3)离散均匀,且业务上不扎堆: hash 之后均匀只是第一步,还要防业务热点,某个值对应的业务量天然巨大(下节细说热点账户)。
(4)值不可变: 分片键的值决定了数据住在哪个分片。用户改昵称没事,用户换手机号,如果分片键是手机号,这条数据就得跨片搬家,跨片搬家涉及删除 + 插入 + 事务一致性,全是麻烦。所以分片键要选生命周期内不变的值,user_id 这类生下来就不改的主键最合适。
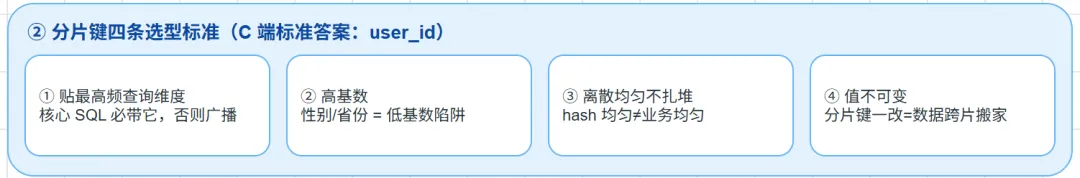
四条合起来看,像 C 端业务的分片可以:按 user_id 分片。
三、按 user_id 分片是C 端业务场景应用
在一些面向用户的应用系统中,由于用户经常查询属于用户的数据,即很多查询都会带个user_id,因此,在这些业务中,选择按 user_id hash 分片是一种比较策略,如果选择其他分片键,可能会涉及全片查询,比无分片性能还并。下面是三个典型的按user_id查询的场景:
① 用户查我的订单:带分片键,精确路由,最优
SELECT * FROM t_order WHERE user_id = 9527ORDERBY created_at DESC;② 用户查订单明细:JOIN 的表也按 user_id 分片,同片 JOIN
SELECT * FROM t_order o JOIN t_order_item i ON o.order_id = i.order_idWHERE o.user_id = 9527;③ 客服按订单号查详情:不带 user_id……广播 32 片?
SELECT * FROM t_order WHERE order_id = 'TB202609210001';①和②都很美。②能同片 JOIN,靠的是 ShardingSphere 的绑定表(binding table) 机制:订单表和订单明细表用同一个分片键、同一条分片规则,两表绑在一起声明,关联数据必然落在同一个片里,JOIN 不产生笛卡尔积式的跨片归并。凡是主子表关系(订单/订单明细、用户/地址),都该配成绑定表。
还有一类小表不用分片:字典表、地区表这种数据量小又要跟大表 JOIN 的,配成广播表(broadcast table), 每个片都存一份完整副本,写入时全片同步,查询时本地 JOIN,彻底不跨片。
但③露出了马脚:若按 user_id 分片,那么按 order_id 查询就没有分片键了。这就是接下来要解决的双维困境。
四、双维困境与基因法
困境:一个业务,存在两个都要查的维度
这在面向对客的系统中经常存在的,即需要按用户 user_id 来查询,也需要按 业务id 或者商家维度来查询等。比如订单表,当在做分片时就会面临这样的问题:买家查我的订单(user_id 维度),客服查订单详情(order_id 维度)。一个只能选一个分片键,另一个维度怎么办?业界主要有三个解法:
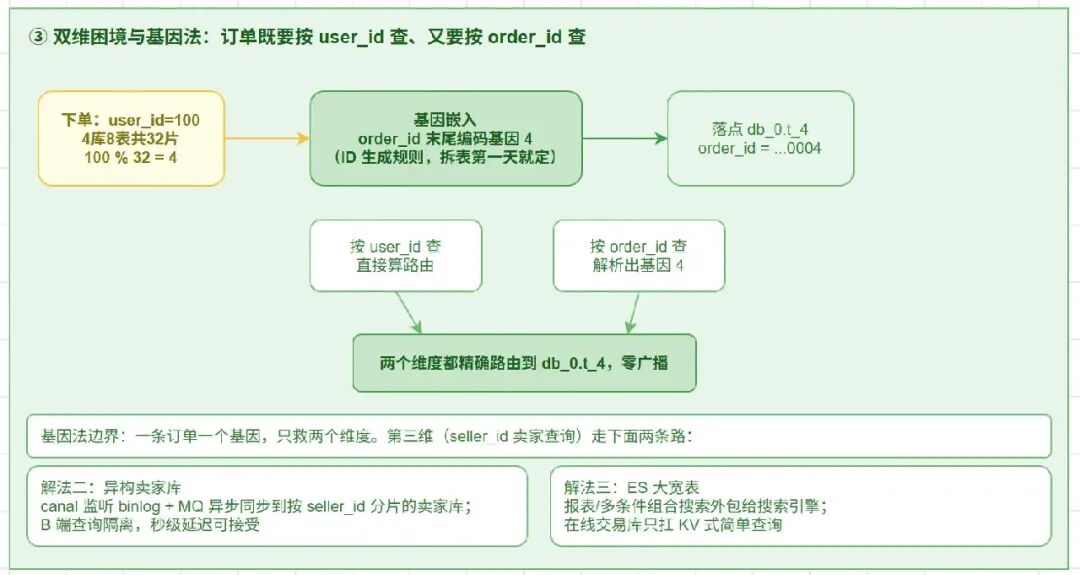
第一:基因法,在业务ID中植入分片键
这是最优雅的一种解法,思路大致是:在生成业务ID时,别采随机策略,而是把 分片键(如user_id)的基因嵌进去。比如需要对订单业务进行分片,可以将订单分成 4 库 8 表,共 32 个分片。下单时先按 user_id 算出落点(比如 user_id % 32 = 4,是 db_0 库 t_4 表),再把这个分片号作为“基因”编进 order_id(比如 order_id 末尾编码 4)。之后:
按 user_id 查: 直接算路由,精确到片; 按 order_id 查: 从订单号里解析出基因,同样精确到片,一次广播都不用。
两个维度的查询都精确路由,这就是基因法的全部秘密。它不新增存储、不引入同步延迟,纯靠 ID 生成规则的设计,所以它必须在系统拆表第一天就定下来,后补的代价是全量刷一遍订单号。
基因法法虽好,但是它只能救两个维度,太多维度就难以实现了。比如再接入第三个维度,卖家查“我卖出的订单“(seller_id 维度),基因法就无能为力了。一条订单只有一个订单号、一个基因,装不下第三个维度的路由信息,若要支持卖家查询,需走另外两个解法。
第二:异构索引库
这种方式适合于对客的交易平台,即有用户,也有商家,还有平台,各自都有本身的查询需求,采用多套分片策略来满不同的用户群体需要。比如 C 端在线交易库按 user_id 分片(基因法),扛住高并发的下单和查单;同时订单数据通过 canal 监听 binlog、经 MQ 异步同步到一套按 seller_id 分片的卖家库,商家后台全部查询走卖家库。读写彻底隔离,B 端的复杂查询永远不影响 C 端下单,代价是几秒级的同步延迟(商家刷新一下才看到新订单,业务上完全可接受)。
第三:引入 ES 大宽表,解决复杂查询
运营侧的报表、多条件组合搜索(比如昨天售出的 iPhone 订单这种),不要指望分片后的 MySQL。在这种需要下,可以采用订单数据经 binlog 同步到 ES 大宽表中,所有复杂组合查询全部外包 ES 中,这也是当初分片后,为满足运营的需要而采用的一措施。这就是第 65 篇六笔账里跨片查询的标准还法:在线交易库只扛简单的 KV 式查询,其他一律异构。
三个解法组合起来,即可解决一般对客系统的分片的标准:user_id 分片 + 基因法订单号 + 异构卖家库 + ES 宽表。
五、数据倾斜
在分片键的四条标准中,如何让数据分布均衡,这是一个难道。若分片键或路由算法选择不对,将会导致数据倾斜。
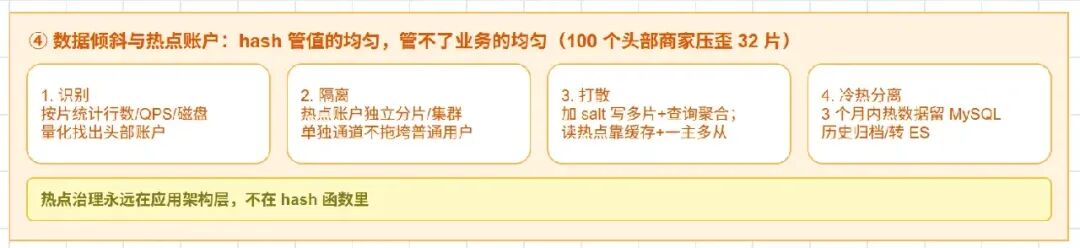
虽然 hash 取模可保证值的分布均匀,但即不一定能保证业务量的分布均匀,比如:
平台上有 1000 万普通用户,每个几千条订单;有 100 个头部商家,每个几千万条,如果某天你把分片键选成了 seller_id,那 100 个大商家的数据就把 32 个分片压成了少数几个热点片;社交场景的大 V、金融场景的高频交易账户、IoT 场景的高频上报设备,同理。
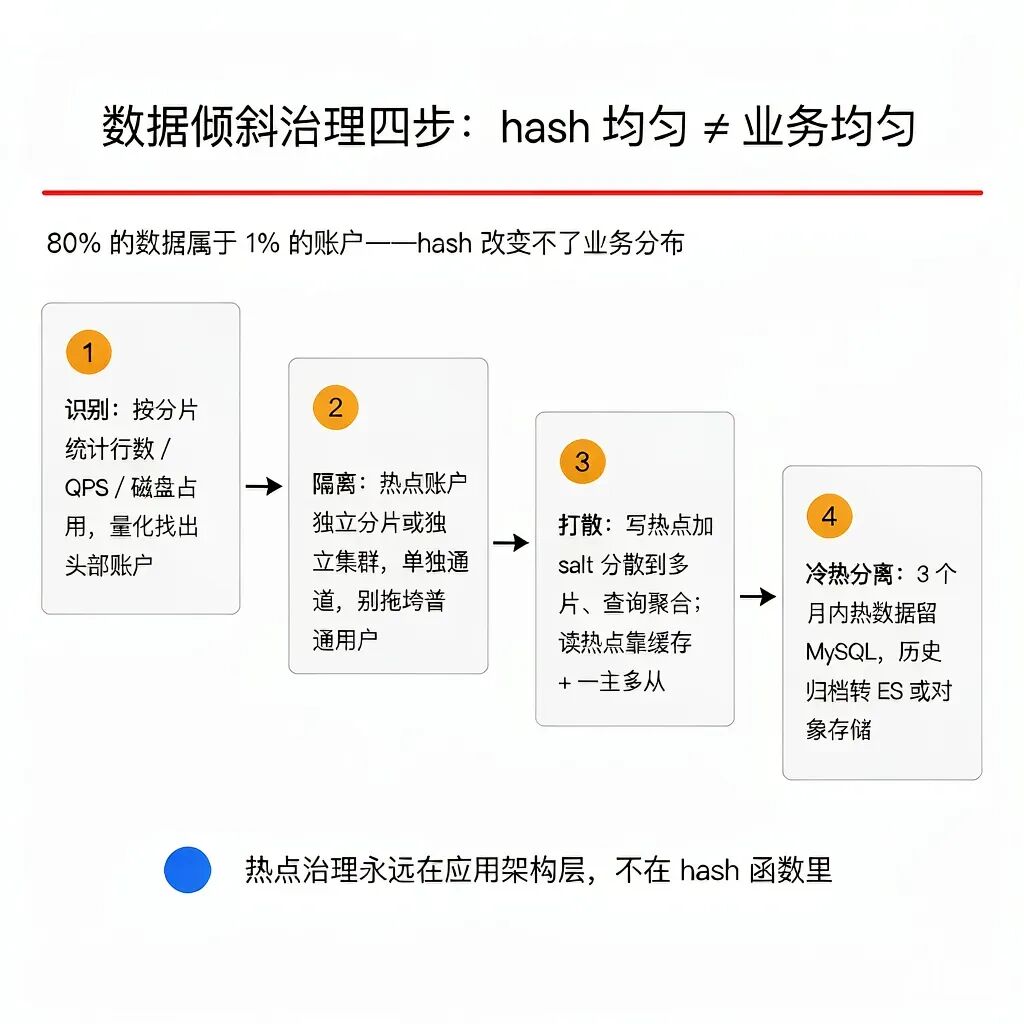
热点数据不是选对算法就能消灭的:它是业务分布的不均匀,hash 再均匀也改变不了 80% 的数据属于 1% 的账户 这个事实。面对这样的场景,业界一般按下面的顺序思路来处理:
识别:先量化分片的数据量,按分片统计行数、QPS、磁盘占用,找出头部账户。没有量化就没有治理的权利。 隔离:头部热点账户单独放(独立分片或独立集群),平时账号数据走常规路由,热点账户的流量单独通道,别让一个头部商家拖垮一片普通用户。 打散:读多写少的热点,靠缓存和一主多从扛读(第 64 篇的路由思想);写集中的热点(秒杀账户),数据加 salt 打散到多个分片、查询时聚合——用多片并行写换掉单片排队写。 冷热分离:3 个月内的热数据留在 MySQL,历史数据归档(第 65 篇提过的 DROP PARTITION 思路,或转 ES/对象存储)。
六、路由算法如何取舍
分片键定了,路由算法怎么选?业界有三种比较主流的选择算法,它们各有优势,来看下表::
user_id % 32 | 扩容要大规模迁移 | |||
created_at 按月切、按 ID 号段切 | 最新片扛全部写入 | |||
id → 分片号 |
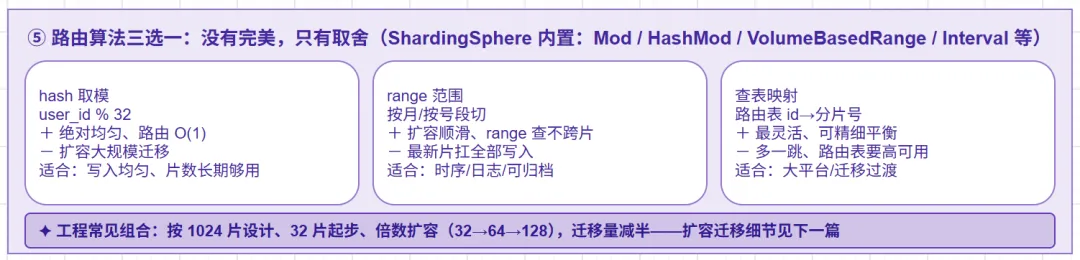
ShardingSphere 内置算法和这个分类对得上:Mod/HashMod(取模/哈希取模)、VolumeBasedRange/BoundaryBasedRange/Interval(基于容量/边界/时间范围)、Complex/ClassBased(复合/自定义)。工程上最常见的组合是:hash 取模起步 + 预留倍数扩容空间,比如目标容量按 1024 片设计,初期只建 32 个分片,扩容时按倍数翻(32,64,128),迁移量减半(下一篇展开)。
七、分片选择有那些反例
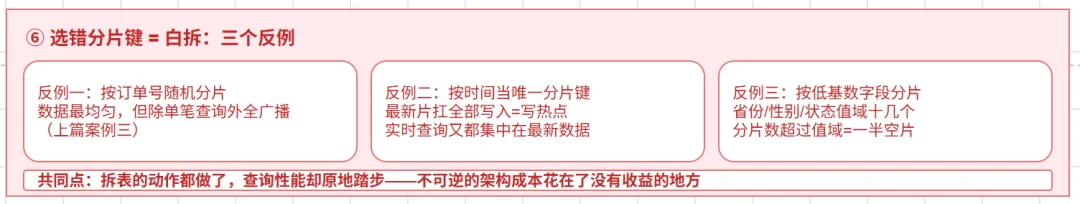
把分片键选择的标准反过来看,就是三个典型反例:
(1)按订单号随机分片: 数据最均匀,但除了单笔订单查询,其他所有查询全部广播(上一篇案例三,白拆)。
(2)按时间分片: 本月片扛住全部写入流量,变成单片热点;而绝大多数实时查询恰好集中在最新数据,即 range 的冷热不均和业务读写分布正撞个满怀。除非业务是写历史、查任意的归档型(账单、日志),否则别用时间当唯一分片键。
(3)按低基数字段分片: 分片禁选择省份、性别、订单状态等,国类一个值就那么十几个,分片数超过值域,一半的片是空片的(不满足标准二)。
这三个反例的共同点是:拆表的动作都做了,查询性能却原地踏步甚至更差,这就是白拆二个字的含义。分片键选错,错的不只是一个字段,是把不可逆的架构成本花在了没有收益的地方。
写在最后
回顾这一篇,你会看到一个反复出现的模式:分库分表里最难的问题,答案几乎都不在分片本身——双维查询靠基因法和异构,热点靠缓存和隔离,复杂查询外包给 ES。分片中间件解决的是 :怎么把数据摊开,而摊开之后怎么查得快,靠的还是 ID 设计和架构分层。 这也是为什么上一篇反复强调:拆之前要做足功课,比拆本身更重要。
下一篇我们将正面迎击六笔账里最难还的一笔:扩容与数据迁移,为什么 hash 取模扩容要大规模搬家、"按 1024 片设计 32 片起步"的倍数扩容怎么把迁移量减半、以及不停机双写迁移的完整步骤。拆是开始,扩是常态,迁是必修课。
本篇参考:Apache ShardingSphere 官方文档(Sharding 概念:分片键/分片策略/绑定表/广播表、Built-in Sharding Algorithm List);基因法、异构索引库、热点打散等方案为业界公开实践(阿里/蚂蚁等电商场景广泛使用),非 MySQL 官方文档内容。
---全文完---
