过去半年,几乎所有团队都在做同一件事:把 Agent 推到生产。但紧接着就会撞上第二个问题——它到底行不行?
这个问题比想象中难回答。Agent 由模型、Prompt、规划、知识、记忆、Tool/Skill 和工程流程共同构成,任何一个环节出问题,都会沿着执行链一路传递,最后表现为一个“难以理解、难以复现”的异常。只看最终回复,你甚至无法判断任务是否真的完成了。
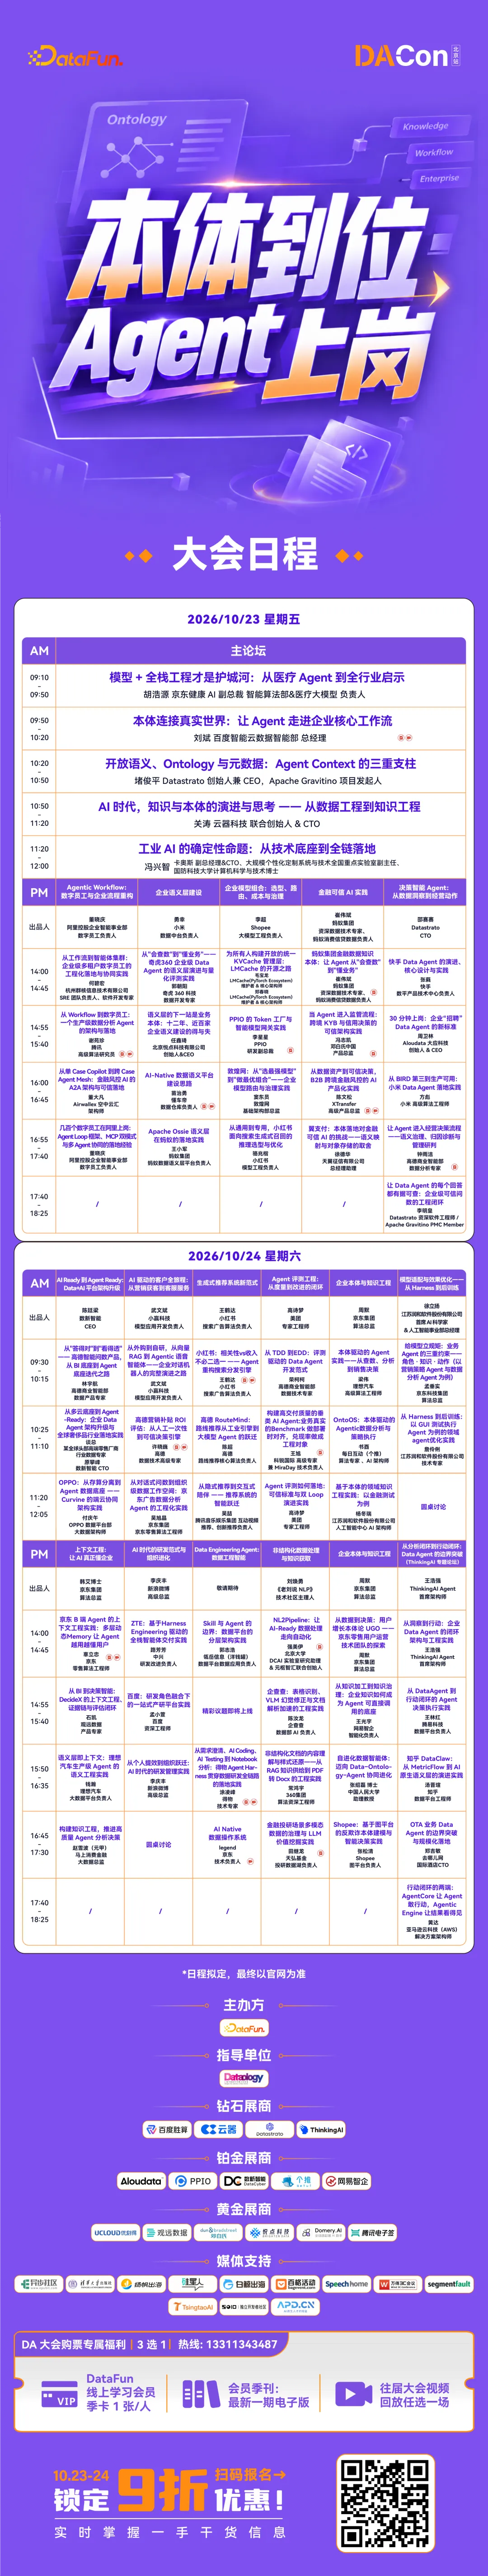
10月23-24日,DACon 2026北京站,三家企业将给出三种不同的答案。
第一种|美团:把评测做成“精密量具”,用两个 Loop 咬合
美团专家工程师高诗梦带来《Agent 评测如何落地:可信标准与双 Loop 演进实践》。
她的判断很直接:评测体系的核心不是堆叠指标,而是在模型能力、Agent 能力、任务目标和业务目标之间建立可解释的连接。落地上有五个难点——执行链路复杂导致根因难定位、主观标准容易漂移、机器评测不一定可信、离线评测存在天然覆盖边界、Bad Case 说不清该改 Agent 还是该校准评测。
她的解法是“四个模块、三种能力、两个 Loop、一套资产”:离线评测、在线评测与监控、Case 挖掘与归因、观测基建;发现问题、定位问题、驱动演进;一个 Loop 改进 Agent,一个 Loop 校准评测体系。而可信标准的建立要走两步——先“人人一致”(质量口径负责人 + 背靠背标注 + 可执行 Rubric),再“人机一致”(用校准后的人工结果验证 Judge)。
第二种|高德:学术基准不适合生产,自建“建—管—CI—归因”流水线
高德数据技术专家荣柯柯带来《从 TDD 到 EDD:评测驱动的 Data Agent 开发范式》。
他先解释了为什么不直接用 BIRD / Spider——学术基准有三点不适配:静态题集 vs 口径持续演进;单一 EX 指标 vs 业务口径判定(结果对 ≠ 口径对);标准单库 vs 真实数仓规模。
他的答案是自建流水线:以任务完成度 45% 为核心权重的四维评分体系(任务完成度 / 推理规划 / 工程效率 / 安全鲁棒),基于线上真实问题构建 4 大业务方向千题级评测集、14 天滚动更新,用聚合守恒、场景路由、SQL 一致性细化单一 EX 判定,再用并行调度 + 答案隔离实现无人值守评测 CI。结果是评测周期从 24h 缩到 12h,人力成本降低约 30%。
第三种|科锐国际:用业务真实 Benchmark 做部署时对齐,把“兑现率”做成工程对象
科锐国际高级技术专家、MiraDay 技术负责人王旭带来《构建高交付质量的垂类 AI Agent》。
他的观点最直接:“大家的能力上限在快速趋同,兑现率才是垂类 Agent 的主战场。”交付质量的瓶颈不在模型能力,而在兑现率。
为此他们构建了 MiraBench 做部署时对齐(deployment-time alignment),并把“停止”识别为兑现率最大的单一损失源,在 Harness 层做专项处理——用外部证据校准 continue / ask / commit,减少早停、空转、过度执行和错误交付。重构后,MiraBench 综合分从 40.1 提升到 75.2。
三家共同面对的三个难题:
- 没有真值:开放业务场景缺少稳定标准答案,Judge 也会漂移
你能带走什么:
- 三种可迁移的评测路线:双 Loop 演进 / 四阶段流水线 / 部署时对齐,按自己团队所处阶段选
- 一套四维评分框架与权重设计思路(任务完成度 45% / 推理规划 25% / 工程效率 15% / 安全鲁棒 15%)
- 三场演讲对同一个问题的诚实回答:哪些坑至今没有完美解法
前五篇专题都在讲 Agent “怎么建”,这一篇讲“怎么验”。如果只建不验,迭代就是盲飞。
📅 时间:2026年10月23-24日
📍 地点:北京希尔顿逸林酒店
🎫 报名:点击「阅读原文」或访问 https://h.datafuntalk.com/WybvdW
☎️ 票务咨询:13311343487
🔥 9 折优惠购票火热进行中……DACon 2026 北京站,15 个分论坛,60+真实应用案例,2 天沉浸式学习交流,现场还会组织闭门会、晚场圆桌交流,讲师们会围绕具体的技术点进行介绍,旨在丰富大家在参会体验,希望大家不虚此行,满载而归。