JEV-as-a-Judge:让评测模型知道何时该相信自己
LLM-as-a-judge 已经成为大模型评测的重要基础设施:它可以替代部分人工偏好判断、事实性检查和成对比较,但每一次调用更强的生成式模型都会带来额外费用与延迟。更棘手的是,评测模型并不总能可靠地知道自己什么时候判断错了。
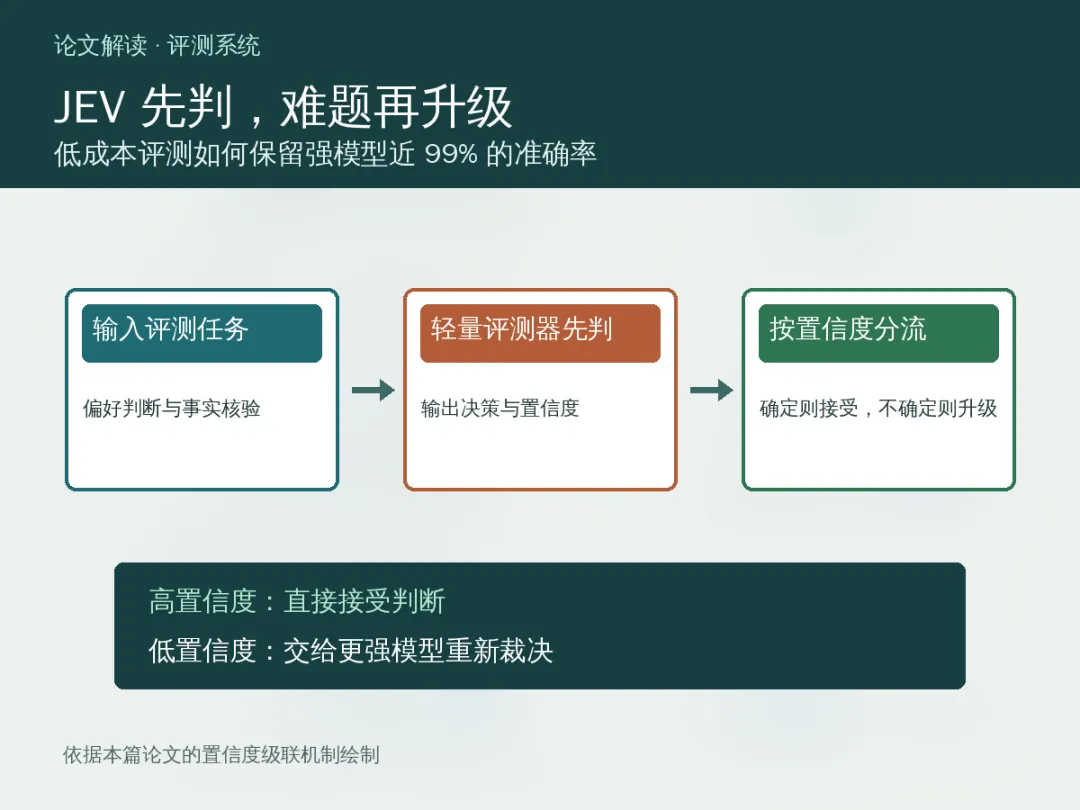
论文 “JEV-as-a-Judge: Accept When Confident, Escalate When Unsure” 研究了一个更务实的问题:能否让一个只输出决策和概率的轻量评测器先处理大多数样本,只把低置信度案例交给更强的 LLM?作者 Yubo Li、Yidi Miao、Ramayya Krishnan、Rema Padman 比较了 JEV 与 16 个生成式和奖励模型评测器,并使用盲法人工裁决进行核验。论文给出的答案不是让廉价模型全面替代强模型,而是让它成为一个带有“升级出口”的第一道门。
https://arxiv.org/abs/2609.26550
JEV 的关键变化:输出决定,不输出解释
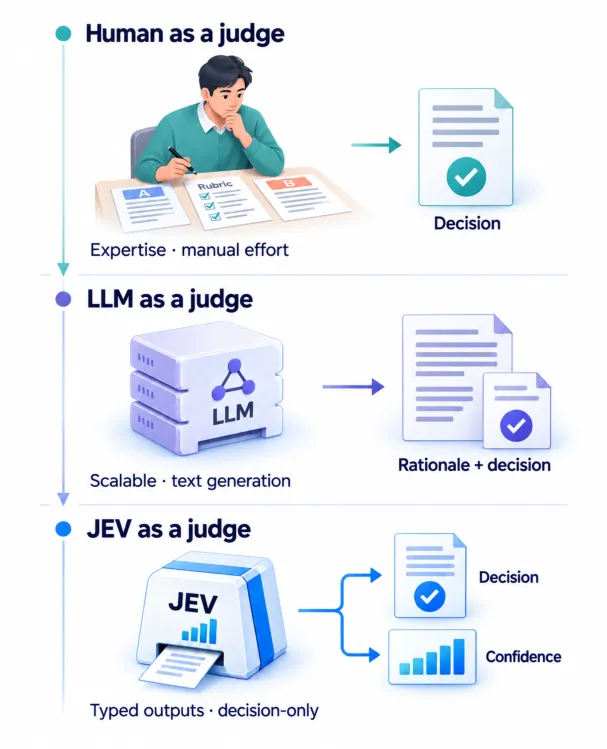
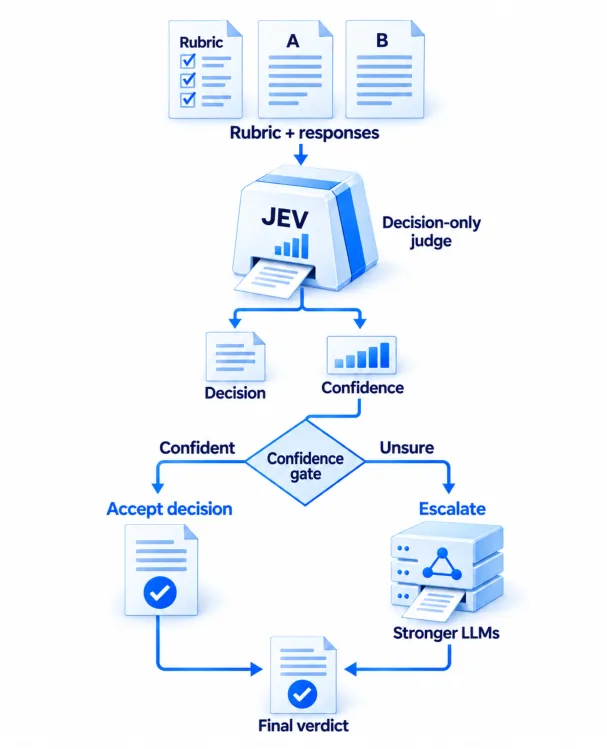
传统的生成式评测器往往要求模型先阅读候选答案,再生成理由,最后给出结论。JEV 采用 decision-only judging:直接暴露类型化决策和标签概率,用最大标签概率概括当前判断的置信度。它不把一段看似完整的解释当作可靠性的证明,而是把“选择了什么”和“有多确定”拆成两个可以用于路由的信号。
这种设计有两个现实意义。第一,输出契约更窄,减少了生成理由所需的 token 和失败面。第二,概率信号可以进入调度逻辑:高置信度判断直接接受,低置信度判断则交给更强的评测器重新裁决。对于成对偏好判断,论文还会对两个候选答案的顺序进行概率对齐并取平均,再用这个信号决定是否升级,避免仅由展示顺序造成路由偏差。
从人工评测到决策型评测器的接口变化
便宜并不等于全面相同
论文的对比结果显示,JEV 在普通偏好判断和证据支撑的事实性评测上已经接近更强的生成式评测器,但能力差距会随任务类型变化。以表中列出的 JEV 1.13 为例,RewardBench 准确率为 92.2%,HaluEval 为 87.5%,而 JudgeBench 只有 78.6%。对照的 GPT-6 Astra 在三个任务上的结果分别为 93.5%、86.7% 和 93.1%。
这组结果说明,JEV 并非简单地“弱模型全面落后”。在 RewardBench 上,它距离 GPT-6 只有 1.3 个百分点;在 HaluEval 上反而高出 0.8 个百分点。真正明显的差距出现在 JudgeBench,这类判断更容易涉及推导核验,或者识别一段表达流畅但结论错误的答案。论文摘要也明确指出,当任务要求检查 derivation,或抵抗精心包装的错误答案时,差距会变大。
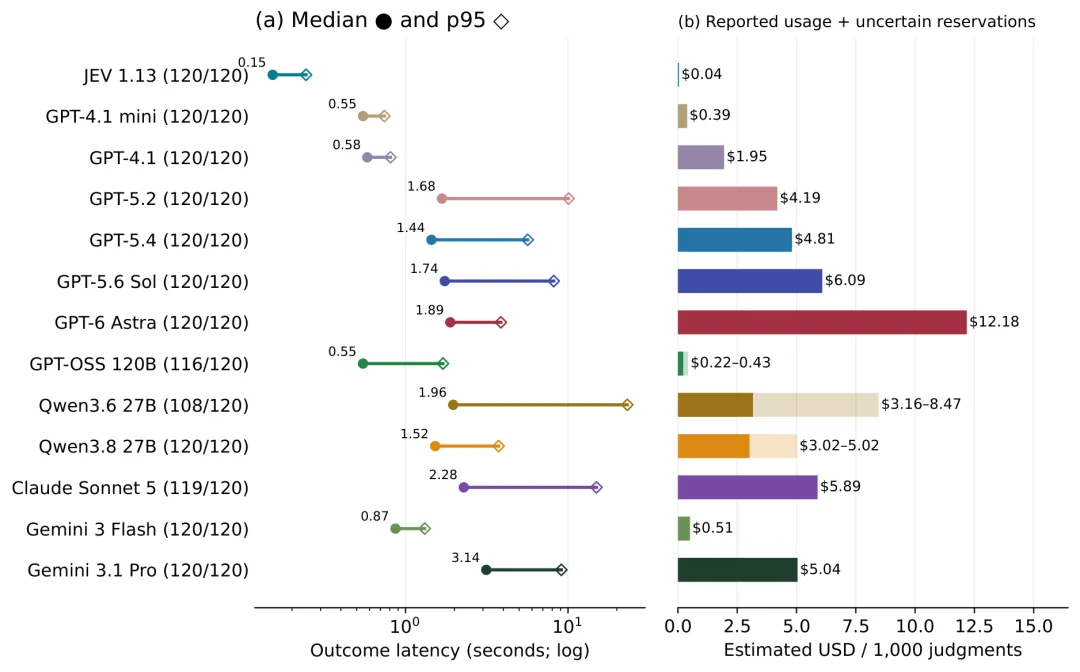
代价方面,论文报告 JEV 在代表性对比中以约 0.36% 的 comparator fee 达到接近的总体效果。不过费用数字依赖服务商和用量口径,扩展实验也特别区分了报告用量与保守预留,因此更准确的解读是:JEV 适合作为低成本筛选层,而不是在所有场景中替代最强评测器。
不同托管评测配置的延迟与每千次判断费用
置信度可以把错误集中到少数样本
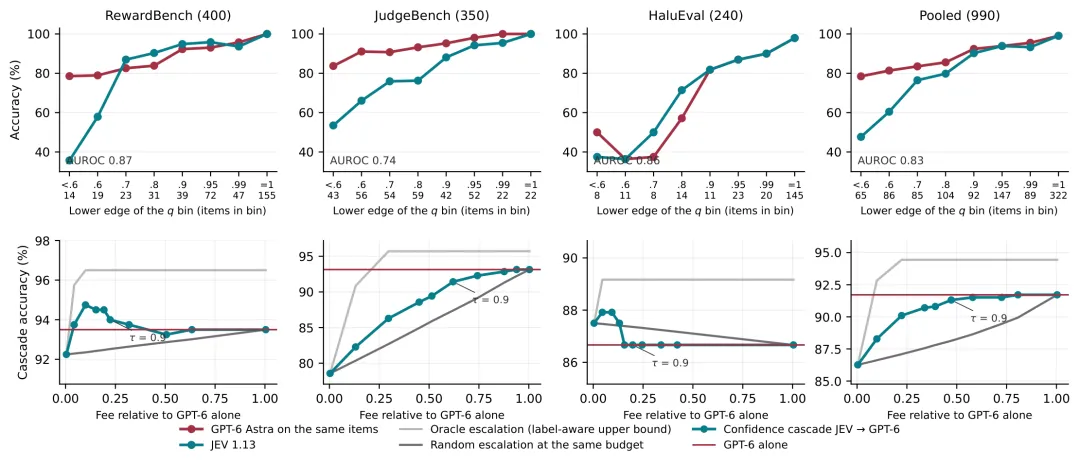
级联策略的核心假设是:JEV 的错误不是完全随机分布的,低置信度样本中应当聚集更多风险。论文的置信度分布和可靠性曲线正是用来检验这一点。实验以 JEV 的最大标签概率 q 作为路由分数,并观察不同 q 区间的正确率与错误排序能力。
结果表明,置信度门控确实能让系统在成本和准确率之间取得连续折中。以 pooled 结果为例,阈值 τ 从 0.8 提高到 0.99 时,升级比例从 23.8% 增加到 58.5%,级联准确率从 90.7% 提升到 91.5%,费用比从 0.34 增至 0.73。RewardBench 上,τ=0.8 时只升级 14.0% 的样本,准确率为 94.5%,高于 GPT-6 对应的 93.5%;JudgeBench 则需要更高的升级比例,τ=0.99 时升级 87.4%,准确率达到 92.9%,仍略低于 GPT-6 的 93.1%。
这也解释了为什么不能只给级联策略一个“平均节省成本”的宣传数字:任务越需要细致推理和反事实核验,就越需要把更多样本交给强模型。阈值必须按 workload 验证,而不是跨任务复用。
按置信度分箱后的基础准确率与级联成本折中
冻结策略比事后调阈值更接近真实部署
图表中还区分了 post hoc 阈值和 frozen policy。前者是在看过结果后挑选最漂亮的阈值,适合分析置信度是否有排序能力,但不能直接当成上线承诺。冻结策略则需要在部署前按 workload 验证阈值,之后固定执行,才能反映真实系统面对新样本时的成本与效果。
论文给出的级联结果支持这一部署思路:在多个基准上,级联可以保留约 99% 的强评测器准确率,同时显著减少强模型调用。表中 pooled 的 τ=0.9 设置升级 34.3% 的样本,准确率 91.3%,费用比 0.47;τ=0.95 时升级 43.6%,准确率 91.5%,费用比 0.58。对于 RewardBench,低升级比例就能达到很高的保留准确率;对于 JudgeBench,级联收益更多来自逐步缩小差距,而非完全消除差距。
工程上,这意味着路由器需要保存每个任务的阈值、有效样本覆盖率和失败处理规则。评测服务还要把 provider generation、HTTP-200 contract、transport 等异常和“判断错误”分开统计。扩展表显示,GPT-5.6 Sol 与 GPT-6 Astra 的有效响应率为 1312/1312,而 Qwen3.6 27B 只有 1206/1312;如果不区分无效响应,费用和准确率比较都会被污染。
JEV 置信度驱动的接受或升级流程
适用边界:先问任务是否能被置信度排序
这项工作的价值在于把评测调用从“每个样本都找最强模型”改写成了风险分层问题。但它也提出了明确边界。
首先,置信度只是 JEV 的内部信号,不等于事实正确性证明。若错误样本也能得到高概率,级联就可能直接接受错误结论。其次,阈值不能只看一个综合平均值:JudgeBench 与 RewardBench 展现了完全不同的升级需求。再次,强模型自身也会失败,级联只能把不确定性转移给更强的后端,不能替代人工抽检和离线校准。
因此,更合理的落地方式是把 JEV 放在大量、重复、成本敏感的评测任务前面;对高风险领域、复杂推导、容易被语言包装误导的答案,设置更高升级比例,或直接保留人工复核。论文的结论并不是“便宜评测器取代强模型”,而是:让轻量评测器负责筛选,让强评测器集中处理它最值得处理的少数案例。 只要阈值按任务冻结、失败类型单独监控,这种分层评测就能在可控风险下换取显著的成本与延迟收益。
关注我们,加入行业交流
扫描下方二维码关注公众号,持续获取前沿论文解读;也可添加小助手,加入行业交流群,与同行交流最新进展。