今天筛选了12 篇具身智能相关论文,覆盖失败恢复评测、世界动作模型加速、接触感知、持续学习与安全控制等方向。
本期导读:如果你只想抓重点,先看RoboRecover和Streaming-WAM;一个检验出错后能否继续,一个处理推理期间机器人仍在运动的问题。如果你做接触交互,CoPRE和TactileStep也值得放进跟踪列表;如果你在补适应与泛化,流式强化学习分析和KeyGen更适合对照阅读。
1. 正常起点接近满分,出错之后还能救回来吗?
🔬 RoboRecover: Benchmarking Robot Policy Recovery under Execution Deviations
📌 为什么读:
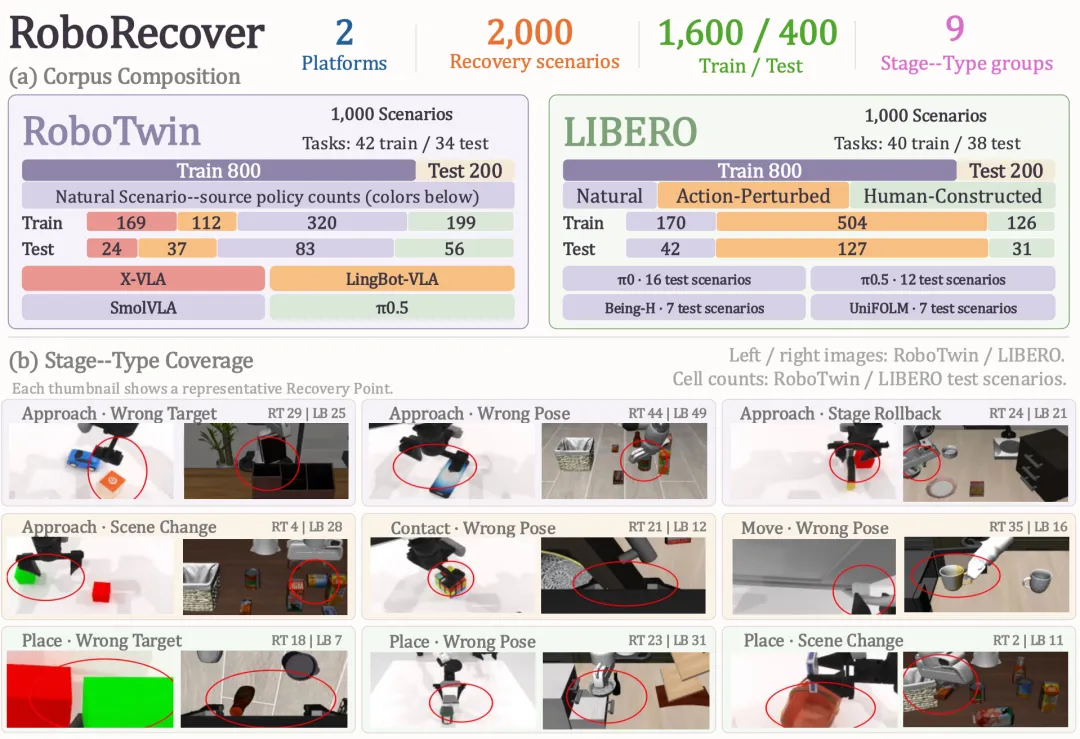
机器人顺利完成标准流程,不代表物体滑脱、目标放错后还能继续。RoboRecover把评测起点移到执行偏差发生之后,检查策略能否修复关系并完成原任务,为部署团队补上“失败恢复”这一维度,也让策略选型不再只依赖正常起点成绩。
✨ 核心收获:
① 固定偏差状态再比较:通过动作前缀回放重建场景,保留原指令和成功判据;评测时先算各场景恢复率,再等权平均。
② LIBERO固定测试集含200个场景:UniFOLM从正常起点的98.83%降至恢复评测的48.00%;π₀.₅则为94.17%与64.40%,说明两种排名不能互相替代。
③ 按偏差类型诊断:除总体恢复率,还可对九类阶段—偏差组合等权统计;筛选过的困难场景不代表自然部署中的故障频率。
📖 摘要精读:
现有评测多从预设初态出发,难以单独衡量执行偏差后的恢复能力。RoboRecover从自然失败、动作扰动和人工构造中筛选场景,以动作前缀回放重建恢复起点。基准覆盖RoboTwin与LIBERO,各含1000个场景并按800/200划分训练与测试。实验发现正常起点表现与恢复排名并不一致;结论对应筛选后的仿真偏差状态。
💡 关键创新:
把交互产生的中间状态设为可重复的评测起点,并结合阶段与偏差类型诊断,将“从头完成”与“出错后继续完成”拆成两个可比较的能力维度。
🔗 论文地址:https://arxiv.org/pdf/2609.28952
🔗 开源代码:https://github.com/RUCKBReasoning/RoboRecover
2. 推理还没结束,机器人已经动了:如何接着规划?
🔬 Streaming-WAM: Action-Conditioned World–Action Model for Asynchronous Robot Manipulation
📌 为什么读:
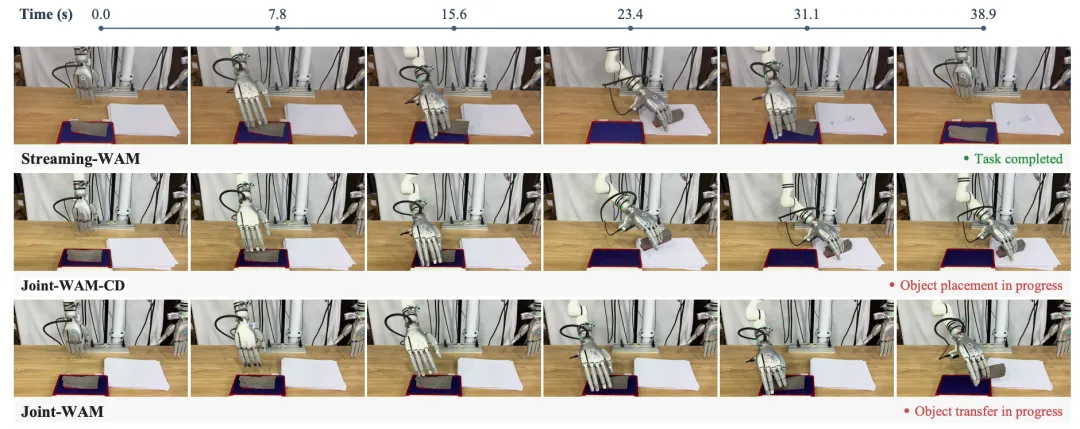
异步推理能减少等待,但旧观测可能跟不上正在执行的动作。Streaming-WAM把已排定动作作为世界预测条件,使后续动作基于即将发生的场景变化,适合研究控制节拍。
✨ 核心收获:
① 以已排定动作前缀同时约束视觉预测与动作续接,让推理与运动重叠;加速还结合蒸馏和运行时优化,不能全归于异步执行。
② 论文真机盖章任务中,平均回合耗时从Joint-WAM的90秒降至38秒;每方法评估30次,使用RTX 5090和30Hz动作执行,不能直接外推到其他硬件。
🔗 论文地址:https://arxiv.org/pdf/2609.28927
🔗 开源代码:https://github.com/SJTU-DENG-Lab/Streaming-WAM
3. 不加力传感器,低成本机械臂怎样发现轻微碰撞?
🔬 CoPRE: Improving Sensitivity in Proprioceptive Contact Detection for Low-Cost Robot Arms
📌 为什么读:
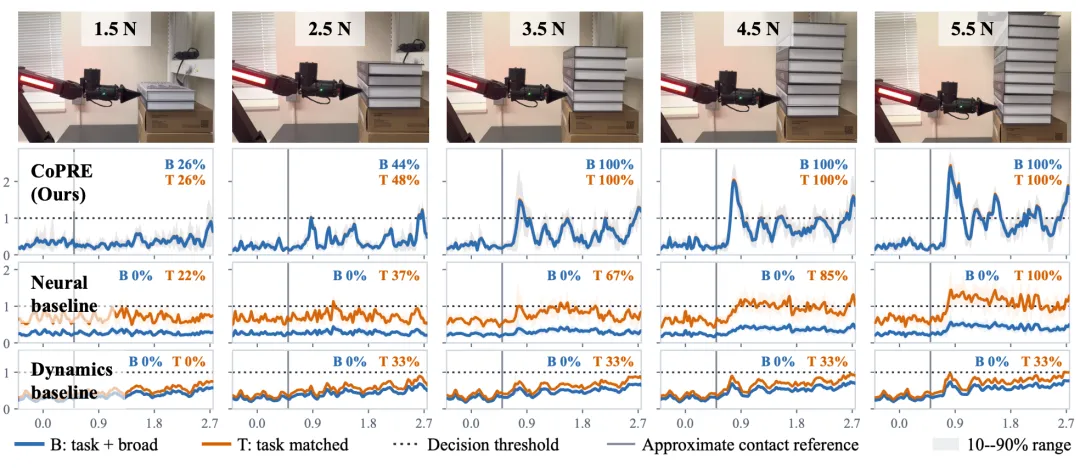
低成本机械臂的本体信号里,轻微接触容易被运动噪声淹没。CoPRE学习无接触响应,再用噪声加权残差发现异常,适合探索接触反馈辅助放置、插入与重试的团队。
✨ 核心收获:
① 预测无接触关节力矩时,排除可能已受接触影响的近期观测,避免模型把碰撞变化也当作正常响应吸收。
② 结合噪声加权雅可比,将残差转为接触分数;在ARX与G1手臂上验证,但该分数用于检测,精确测力与接触定位尚未验证。
🔗 论文地址:https://arxiv.org/pdf/2609.27381
项目页面:https://copre-arm.github.io/
4. 能跨过去还不够,落脚能否更轻、更稳?
🔬 TactileStep: Sole Tactile Learning for Regulating Foot-Terrain Interaction in Humanoid Locomotion
📌 为什么读:
TactileStep将足底压力提炼为法向力、接触面积和压力中心,再按步态阶段设计奖励。G1实验关注落地冲击与支撑质量;对可变形地面及长期传感器漂移尚缺验证。
🔗 论文地址:https://arxiv.org/pdf/2609.28959
项目页面:https://tactilestep.github.io/
5. 插接差一点,可能是视觉关注点偏了
🔬 ActGaze: Learning Action-Grounded Gaze through Counterfactual Visual Interventions for High-Precision Manipulation
📌 为什么读:
ActGaze通过反事实视觉干预判断哪些区域影响动作预测,再把空间监督传回策略。四项真机精密操作检验了这一思路;训练不需外部注视标签,评测仍用人工区域标注。
🔗 论文地址:https://arxiv.org/pdf/2609.28955
项目页面:https://anonymous.4open.science/w/ActGaze/
6. 扩散规划太慢?把动力学推演搬到升维空间
🔬 Koopman-Accelerated Model-Based Diffusion for Real-Time Robot Control
📌 为什么读:
BK-MBD每个控制步只做一次状态升维,再用双线性动力学批量推演候选。双线性结构保留随姿态变化的输入作用,值得关注采样规划时延与学习模型误差的读者研究。
🔗 论文地址:https://arxiv.org/pdf/2609.28920
项目页面:https://rcilab.khu.ac.kr/bkmbd/
7. 换一个同类物体,策略还能找到对应位置吗?
🔬 KeyGen: Unsupervised Keypoint based Object-Centric Representations for Category-Level Policy Generalization
📌 为什么读:
KeyGen从点云学习规范化三维关键点,结合物体中心几何为扩散策略提供条件。实验检查同类新实例、姿态和尺寸变化;有助于区分类别内泛化与跨类别泛化的边界。
🔗 论文地址:https://arxiv.org/pdf/2609.28818
项目页面:https://robo-keygen.github.io/
8. 世界模型每次都看整幅图,能否只更新变化部分?
🔬 DeltaWAM: Delta World Action Models for Bimanual Manipulation
📌 为什么读:
DeltaWAM联合预测视觉增量与动作,并用缓存锚点和增量更新减少重复计算。阅读时要分清默认十步去噪的成功率与单步推理加速实验,两组结果不能拼成同一性能点。
🔗 论文地址:https://arxiv.org/pdf/2609.28811
🔗 相关资源:https://github.com/AIGeeksGroup/DeltaWAM
项目页面:https://aigeeksgroup.github.io/DeltaWAM
9. 只用最新经验持续学习,适应之后会不会再退步?
🔬 An Analysis of Streaming Deep Reinforcement Learning for Adaptive Continual Learning in Robotics
📌 为什么读:
这项研究分析流式强化学习如何适应目标、环境和身体变化。仿真四足任务显示潜力,但操作任务会出现先恢复后退化,提醒读者同时看峰值表现、长期均值与训练稳定性。
🔗 论文地址:https://arxiv.org/pdf/2609.28807
🔗 开源代码:https://github.com/tjvitchutripop/stream-rl-robotics/
10. 知道要写字,还得知道笔尖怎样跟着手臂动
🔬 Know Your Body: A Harness for Direct and Self-Improving Robot Control with VLMs
📌 为什么读:
KnowBody为冻结的VLM提供可查询、可修订的身体关系模型,用交互证据连接末端指令与实际效果。跨回合更新先经验证;身体估计改变时,依赖它的经验规则也需重查。
🔗 论文地址:https://arxiv.org/pdf/2609.28530
🔗 相关资源:https://github.com/Loule0-0/KnowBody
项目页面:https://loule0-0.github.io/KnowBody/
11. “去加入那群人”,机器人该站在哪、朝向哪里?
🔬 Where Should I Join? Robot Group Joining via Language-Guided Goal Prediction
📌 为什么读:
给定语言描述,方法先识别目标群体,再预测多个合理的加入位置与朝向。群体定位与目标姿态预测分别评测,覆盖交谈、排队和观众场景,为社交导航补充目标生成环节。
🔗 论文地址:https://arxiv.org/pdf/2609.28467
项目页面:https://robot-join.github.io/
12. 安全过滤放进训练,机器人能否学会更好地竞争?
🔬 Turning Safety into Competence: Minimally Exploitable Robot Policies via Safety-Filtered Reinforcement Learning
📌 为什么读:
S2C先学习鲁棒安全过滤器,再在过滤后的环境中训练竞争策略,并在部署时保留过滤器。达阵游戏检验胜率与可利用性;理论结论依赖完美过滤等假设,不等于现实绝对安全。
🔗 论文地址:https://arxiv.org/pdf/2609.27312
项目页面:https://alliance-ai.cs.jhu.edu/s2c/
关注本号,持续跟进具身智能开源论文前沿动态。
整理不易,欢迎点赞、转发,留言交流。