手里只有几十个站点的观测值,却想画一张连续分布的图?空间插值就是把「点」变成「面」的方法。这篇对比最常用的 IDW 与克里金:原理各一句话、参数怎么定、什么场景选谁,让你第一次用插值就不踩坑。只有 20 个雨量站,怎么画全省降水图
这是做气象、水文、环境分析最常见的问题:站点只有几十个,但需求是一整张连续的降水分布图。
答案是空间插值:用已知点的值,估计未知位置的值,输出一张覆盖整个研究区的栅格面。
插值方法很多,日常最常用的是两个:IDW(反距离加权)和克里金(Kriging)。这篇把它们的区别讲透,你就能按需求直接选。
为什么要插值:散点 → 连续面
观测永远是离散的,但很多现象在空间上是连续的——气温、降水、PM2.5 都是。
插值干的事就是:依据附近已知点,推算每个未采样位置的值,最后得到一整张面。至于「附近点怎么影响未知点」,不同方法答案不同——这正是 IDW 与克里金的分水岭。
IDW:近的说了算
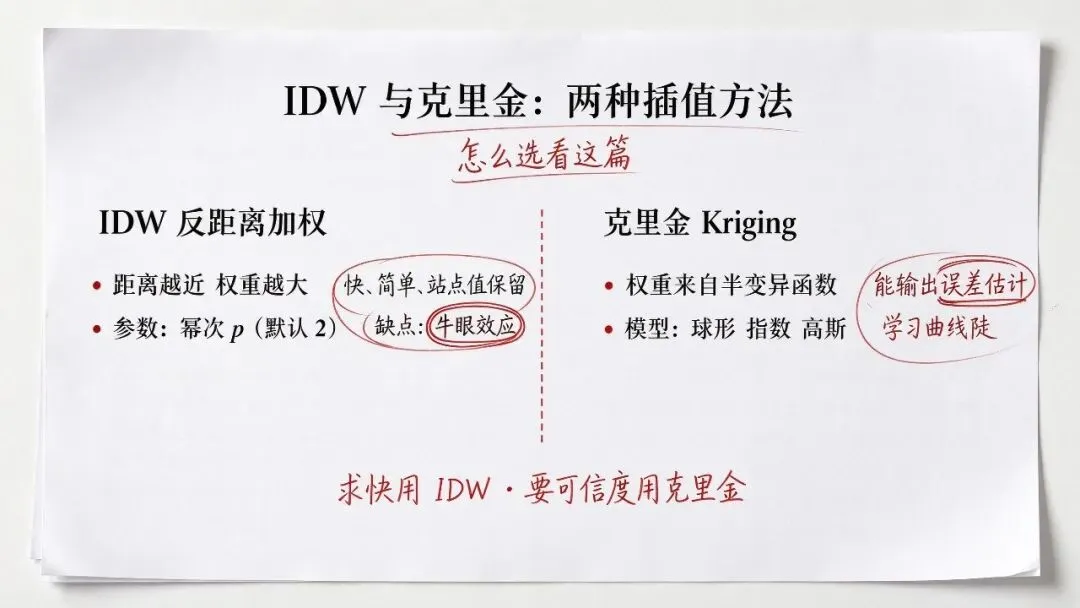
IDW 的思路一句话:离得越近,影响越大。
它以待估点周围若干个已知点的加权平均作为估值,权重与距离成反比(距离 d 的 p 次幂倒数),所以叫「反距离加权」。
两个参数决定结果:
- 幂次 p越大,近点越「霸道」,表面越接近站点值;一般默认取 2
- 搜索半径/参与点数
IDW 是确定性方法,运算快、思路直白,站点处的值原样保留。缺点是不考虑数据本身的空间结构,容易出现「牛眼」效应(站点周围一圈圈同心圆)。
克里金:用空间相关性说话
克里金的思路也是加权平均,但权重不是简单按距离,而是来自半变异函数——用数据自身的空间相关性建模,算出统计上最优的权重。
它和 IDW 最大的区别是:克里金能同时输出误差估计。每个位置的预测值都带着一个可信度(克里金方差),这在风险评估、决策场景里非常有用。
代价是复杂:要选模型、拟合半变异函数、理解参数,学习曲线明显更陡。常见模型有球形、指数、高斯几种,本质是描述「随距离增加,相关性怎么衰减」——日常用球形模型起步即可。
如果看不懂半变异函数,就先别用克里金——硬上只会得到一个「看起来很科学」但参数没调对的图。
IDW 还是克里金:怎么选
一句话建议:只求快、数据点够多分布均匀 → IDW;要做评估、要可信度、样本有明确空间结构 → 克里金。别一上来就上克里金,多数日常场景 IDW 已经够用。
QGIS 实操:两步出图
- IDW处理工具箱搜索「IDW 插值」(插值 → IDW interpolation),选点图层、值字段、幂次与输出范围,运行即得栅格
- 克里金QGIS 自带的克里金要走 SAGA/GRASS 工具(普通克里金),工具箱里同样能搜到,参数比 IDW 多一截
两个工具的输出都是栅格,跑完记得顺手裁剪到研究区边界(叠加分析那篇的裁剪正好用上),再配个像样的色带出图。
两种方法原理与适用场景两栏对比
三个最容易踩的坑
- 坑一:样本太少。十几个点硬插一张大图,结果基本是「画着玩」。样本稀疏时先补数据,或者缩小研究区
- 坑二:参数乱调。IDW 的幂次、克里金的半变异模型都影响结果,改一个参数就出不同图,调参前先想清楚「我在优化什么」
- 坑三:不验证。留一部分点不参与插值,拿预测值和实测值对比(交叉验证),这是判断「参数调对没有」的唯一标准
结尾:从插值到一张能用的图
插值只是第一步,出来的是栅格面,还要做裁剪(研究区边界)、配色、出图——这些前面几篇都讲过,正好串成完整流程。
插值不是把点连起来,是让数据替没测过的地方说话。选对方法,这张「面」才可信。你平时插值用的什么方法?遇到过什么坑?评论区聊聊。