开源推理引擎怎么选:vLLM、SGLang、Ollama、llama.cpp 的机制与部署
部署大模型,第一个要做的选择不是"用哪个模型",是"用哪个推理引擎"。
同一张卡、同一个模型,换个引擎,能扛的并发可能差好几倍——因为引擎决定了 KV Cache 怎么管、请求怎么排队。
这篇讲清主流开源引擎的技术机制差异和选型逻辑,每个都给出部署命令。看完你就能对着一张卡、一个场景,直接定下来用哪个。
一、推理引擎到底在优化什么
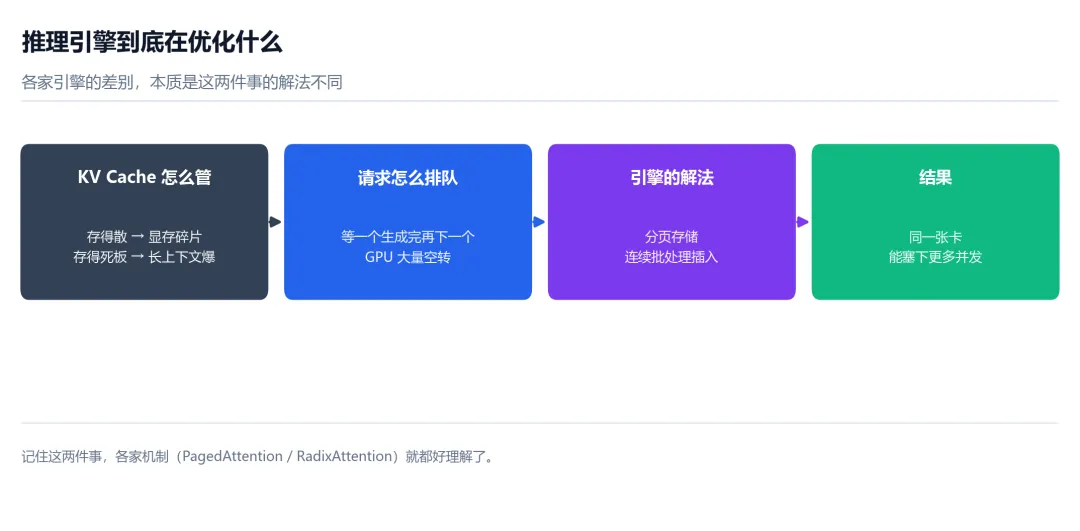
大模型推理有两个绕不开的开销,引擎的功夫全花在这两件事上:
一是 KV Cache 怎么管。 生成过程中,每个 token 的历史 Key/Value 都要存着。存得散、碎片多,显存就浪费;存得死板,长上下文就爆。
二是请求怎么排队。 一个请求生成到一半,GPU 在等它;如果非要等它生成完才处理下一个,GPU 大量时间在空转。怎么把多个请求"插空"塞进 GPU,是吞吐量的关键。
各家引擎的差别,本质就是这两件事的解法不同。 记住这一点,后面的机制就都好理解了。
二、四大主流引擎的技术机制
先看全景对比:
| | | | |
|---|
| PagedAttention | RadixAttention | | |
| | | | |
| | | GGUF | GGUF |
| | | | |
| | | | |
vLLM:把操作系统的分页思想搬进显存
核心是 PagedAttention。 它借鉴操作系统的虚拟内存分页:把 KV Cache 切成固定大小的"页",存在非连续的显存空间里,用一张表记录映射关系。
解决的问题:传统做法要求每个请求的 KV Cache 在显存里连续存放,长度不一就会产生大量显存碎片,利用率常常只有 60% 左右。分页之后,碎片问题被消掉,显存利用率能上到 95% 以上——同一张卡能塞下更多并发。
再叠加连续批处理(Continuous Batching):请求不用等整批做完,生成完的立刻退出、新的立刻插入,GPU 持续保持忙碌。
适合:企业级高并发 API 服务、线上客服、需要吞吐的场景。
pip install vllmpython -m vllm.entrypoints.openai.api_server \ --model Qwen/Qwen2.5-7B-Instruct \ --tensor-parallel-size 2 \ --gpu-memory-utilization 0.9
启动后就是一个 OpenAI 兼容接口,原来的 OpenAI SDK 直接改 base_url 就能用。
SGLang:用前缀树复用 KV Cache
核心是 RadixAttention。 它用基数树(前缀树)管理 KV Cache,把多个请求相同的前缀共享起来。
为什么这个设计重要:在多轮对话、Agent 多步任务里,大量请求的前缀是重复的(比如同一个 system prompt、同一段对话历史)。传统做法每个请求都重算一遍前缀,浪费巨大;RadixAttention 让它们复用同一份缓存。
另一大特色是结构化输出的 DSL:可以用领域特定语言强约束模型输出 JSON、函数调用或自定义格式,在多步协调上是最强的。
适合:Agent 应用、工具协作、多步骤任务、高吞吐多轮对话。
pip install "sglang[all]"python -m sglang.launch_server \ --model-path Qwen/Qwen2.5-7B-Instruct \ --port 30000
Ollama:易用性优先的本地管理器
它的定位不是"最快的引擎",是"最好用的本地入口"。 底层封装 llama.cpp / ggml / gguf 生态,用 Go 重新包了一层,做到一键部署、开箱即用。
核心价值在模型管理:Modelfile 可以自定义模型、系统提示与参数,多模型一键切换。完全离线运行,数据不出本机。
适合:个人开发、快速原型、隐私敏感场景、Apple Silicon 上跑。
ollama run qwen2.5:7b # 一条命令拉起ollama serve # 起本地 API 服务(默认 11434)
注意它的边界:Ollama 面向的是"单人/小规模",多并发需要显式配置(OLLAMA_NUM_PARALLEL、OLLAMA_MAX_LOADED_MODELS),默认配置下并发能力远不如 vLLM。别拿它扛生产级并发。
llama.cpp:纯 C++ 的极致轻量
纯 C/C++ 实现,依赖极低,能编译成单个二进制文件,可移植性极高。深度支持 GGUF 的 4/5/8-bit 量化,把内存占用压到最低。
独有的 GBNF 语法约束:可以在生成时严格约束输出格式,边缘端生成结构化数据很实用。还支持 CPU、CUDA、Apple Metal,甚至 WASM。
适合:硬件资源受限、边缘设备、需要极致可移植或离线的场景。
./llama-server -m qwen2.5-7b-q4_k_m.gguf -c 8192 -ngl 99 --port 8080
三、还有哪些值得知道
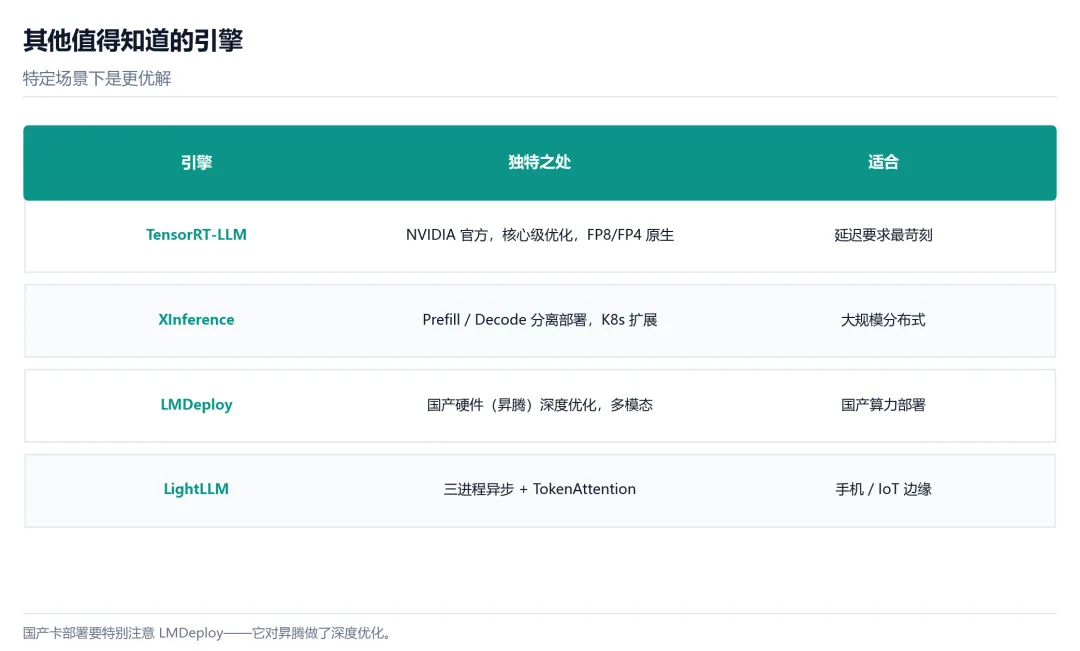
主流之外,这几个在特定场景下是更优解:
| | |
|---|
| NVIDIA 官方,核心级优化,FP8/FP4 原生 | |
| Prefill / Decode 分离部署 | |
| 国产硬件(昇腾)深度优化 | |
| | |
Prefill / Decode 分离是这两年一个明确的方向:把"处理输入"和"生成输出"拆到不同 GPU 上,因为两者的瓶颈不同(一个吃算力、一个吃带宽)。XInference 是这方面的代表。
国产硬件这条线要注意 LMDeploy:它对昇腾等国产算力做了深度优化,如果你的部署环境是国产卡,这是绕不开的选项。
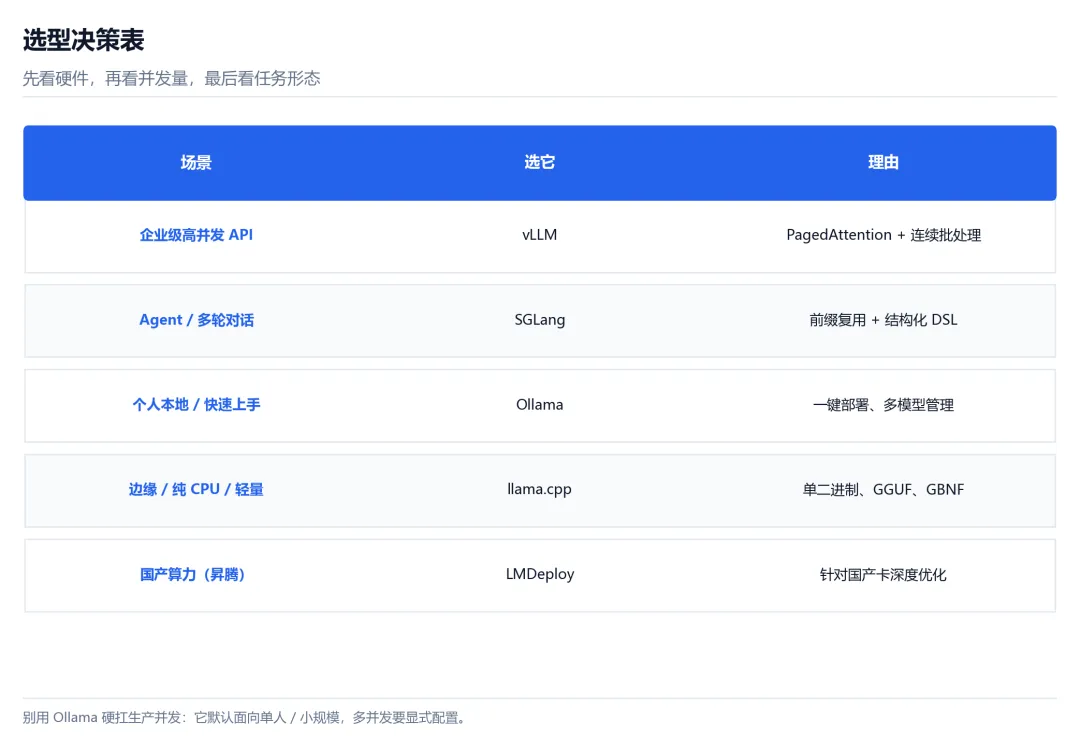
四、怎么选:一张决策表
| | |
|---|
| vLLM | PagedAttention + 连续批处理,吞吐最优 |
| TensorRT-LLM | |
| SGLang | |
| Ollama | |
| llama.cpp | |
| LMDeploy | |
| XInference | |
三条选型原则:
- 先看硬件。 有 NVIDIA 卡走 vLLM/SGLang;纯 CPU 或边缘走 llama.cpp;国产卡走 LMDeploy;Apple Silicon 走 Ollama 或 llama.cpp;
- 再看并发量。 单人到几个人用,Ollama 够了;要扛并发,必须上 vLLM/SGLang——别用 Ollama 硬扛生产;
- 最后看任务形态。 大量重复前缀(Agent、多轮)优先 SGLang;纯问答 API 用 vLLM。
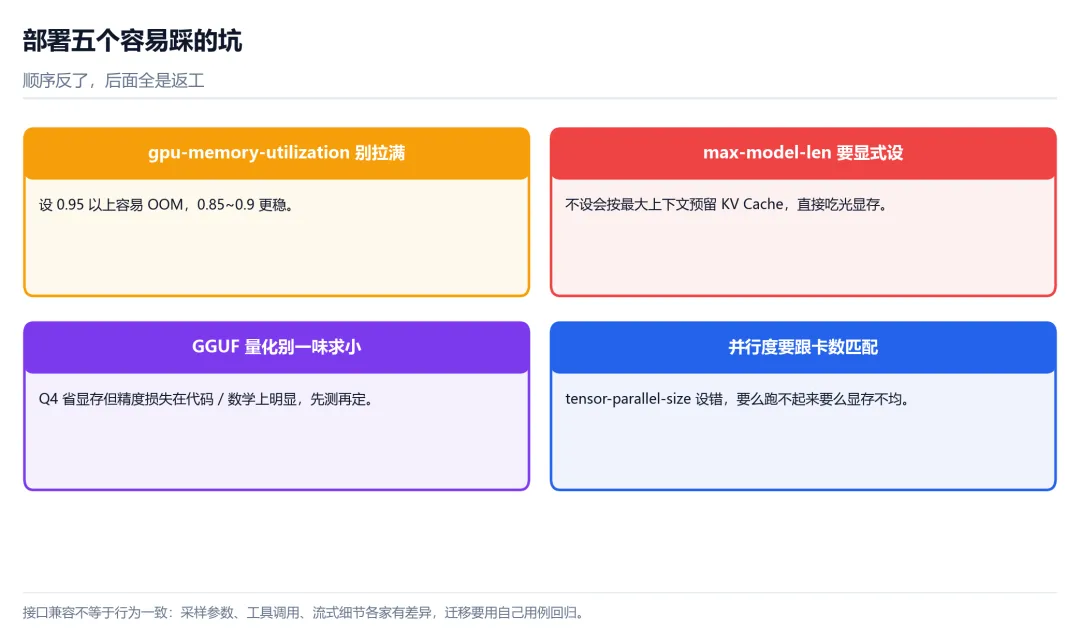
五、部署要点:几个容易踩的坑
一是 gpu-memory-utilization 别拉满。 vLLM 里这个参数控制显存占用比例,设成 0.95 以上容易 OOM(还要留显存给框架本身和临时张量)。0.85~0.9 更稳。
二是 --max-model-len 要显式设。 不设的话引擎按模型的最大上下文预留 KV Cache,长上下文模型会直接把显存吃光。按你实际需要的长度设。
三是 GGUF 量化等级别一味求小。 Q4 比 Q8 省显存,但精度损失在某些任务上很明显(尤其代码、数学)。先测再定,别默认"越小越好"。
四是并行度要跟卡数匹配。--tensor-parallel-size 设成卡数;设错了要么跑不起来,要么显存不均。
五是接口兼容不等于行为一致。 各家都提供 OpenAI 兼容接口,但采样参数、工具调用、流式细节的实现有差异。迁移时要用自己的用例回归,别假设"换个 base_url 就完全一样"。
六、卡住时的排查顺序
- 起不来 / OOM → 先降
gpu-memory-utilization,再显式设 max-model-len; - 吞吐上不去 → 确认开了连续批处理,检查并发请求数是不是太低;
- 多轮对话越来越慢 → 看引擎是否支持前缀复用(SGLang 的强项);
- 输出格式不稳 → 用结构化输出能力(SGLang DSL / llama.cpp GBNF),别靠提示词硬求;
- 精度掉了
- 国产卡跑不起来 → 换 LMDeploy,别在 vLLM 上死磕。
最后一句:推理引擎的选择,本质是在"吞吐、延迟、易用、硬件"四个约束里找平衡。 没有最好的引擎,只有最适合你当前硬件和场景的那个。先确定硬件和并发量,再选引擎——这个顺序反了,后面全是返工。
说明:文中引擎机制(PagedAttention、RadixAttention、连续批处理、GBNF 等)为各项目官方文档与公开技术资料的通行描述;显存利用率、量化等级等数值为常见经验范围,实际表现与模型、硬件、框架版本强相关,请以官方文档和自身回归为准。部署命令为通用示例,参数名以所用版本为准。本文不做跨引擎的性能排名。