我们跑了两个开源记忆评测基准,发现"满分"和"满分"完全不是一回事
同一个智能体,在 A 基准上拿 90 分,在 B 基准上可能只有 55 分。是它变差了吗?不,是两把尺子量的东西根本不一样。
这是我们在给 openKylin 智能体做长期记忆评测时,做的一件"较真"的事:部署两个开源记忆评测基准,和我们的工具跑同一个智能体,看结果差在哪。结论比分数本身有意思得多。
说句题外话:当我们把这个"总分不可比"的烦恼写下来,回头翻了翻 2026 年的学术圈,发现整个记忆评测领域正在集体撞同一个南墙。斯坦福的 MemoryArena 发现"在对话类基准(如 LoCoMo)上近乎满分"的 Agent,一放到"多会话 + 因果依赖"的真实任务里就露馅;AMA-Bench 更进一步,发现很多记忆方案的失误根源在"记忆系统设计"而非"模型能力"。这说明什么?——测不准不是我们一家的事,是这个领域当下最要命的问题。
两把尺子的比喻
一、为什么要做对照实验
评测工具最容易受到的质疑是:"你说你测得好,凭什么是你说了算?"
我们的 museval 采用 Measure-the-Store 方法论——直接驱动记忆库,测"存得对不对、该用有没有用",输出十维能力雷达图。听起来很自洽,但评审完全有理由问:你和已有的开源基准比,到底差在哪?
所以我们选了两个有代表性的开源记忆评测工具做对照:
基准 | 类型 | 特点 |
AMB(agent-memory-benchmark) | npm 包,可运行 | 56 个测试,8 个维度,跨 Provider 对比 |
ATANT(Continuity Corpus) | 语料 + 预发布结果 | 500 story / 5000 questions,测"连续性" |
同一个智能体,三把尺子,看结果差在哪。
二、部署实测:AMB 跑出 55 分
AMB 部署很简单,一行命令:
npx -y agent-memory-benchmark --provider in-memory --layer 1 --no-delay
56 个测试,8 个维度,结果是 55/100。细看维度分布,非常有意思:
AMB 维度 | 得分 |
Factual Recall | 100% |
Semantic Search(语义检索) | 0% |
Temporal Reasoning(时序推理) | 43% |
Conflict Resolution(矛盾消解) | 86% |
Selective Forgetting(选择性遗忘) | 83% |
Cross-Session Continuity(跨会话连续性) | 57% |
Multi-Agent Collaboration(多Agent协作) | 50% |
Cost Efficiency(成本效率) | 56% |
最扎眼的是 Semantic Search 得 0 分。AMB 内置的 in-memory baseline 没有向量检索能力,所以语义搜索直接挂零。
这个 0 分,恰恰暴露了一个评测工具的设计取舍问题——它测的到底是"存储正确性"还是"检索智能性"?
三、museval 跑出 90 分,但这个分数不能直接比
同一个智能体,用我们的 museval 跑,结果是 90/100(28/29 任务)。但——这两个分数不能直接比。原因很简单:两把尺子量的东西不一样。
AMB 维度 | 得分 | museval 对应维度 | museval 得分 |
Factual Recall | 100% | 长期保持 + 记忆调用 | 100% |
Semantic Search | 0% | 记忆调用 | 100% |
Conflict Resolution | 86% | 矛盾消解 | 100% |
Selective Forgetting | 83% | 边界识别 + 动态更新 | 100% |
— | — | 触发鲁棒性 | 0% |
— | — | 认知记忆 | 100% |
— | — | 写路径质量 | 100% |
重叠 5 个维度,各自独有 3+ 个维度。这就是两把尺子的差异。
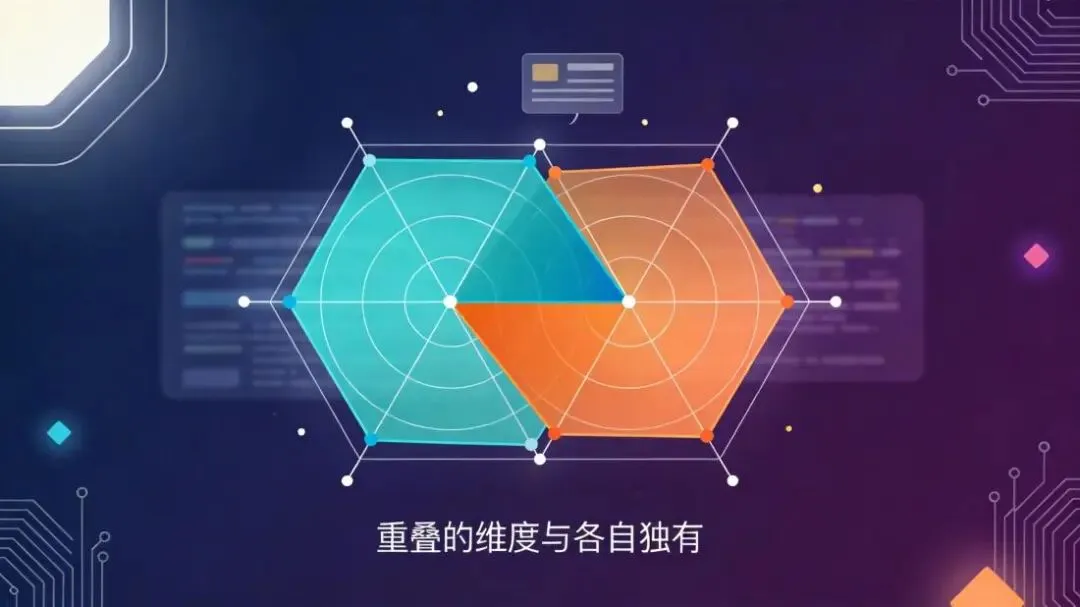
维度覆盖对照:重叠维度与各自独有
这个差异,也是 2026 年学术界正在用更大样本反复验证的同一个结论。AMA-Bench 直言"对话核心基准往往高估记忆系统,因为长时程 Agentic 任务里根本不暴露那些只能在执行流中显现的缺陷";Memora 量化了现有基准的偏向——LoCoMo 里 94% 的问题只需追溯不超过两个会话,LongMemEval 里是 85%,也就是说"只要开场新一点的记忆,就能考得差不多"。你的 90 分和它的 55 分,正是这种"基准偏向"最直白的注释。
四、三个关键发现
发现一:Semantic Search 是共同短板,但处理方式不同
AMB 的 in-memory baseline 在语义搜索上得 0 分——因为它没有向量检索能力,只能靠关键词匹配。
museval 在这项上得 100%,但这不是因为我们更强——而是我们用了 token 重叠打分,回避了语义检索的挑战。这是一个设计取舍:museval 聚焦"存储正确性",不测"检索智能性"。我们的 token 重叠对精确匹配很有效,但对"换个说法也能找到"的语义检索无能为力。
诚实地说,museval 不应该声称覆盖语义检索能力。这个取舍需要在方案文档中明确声明。
一个重要提醒:我们这里用的"token 重叠",在 2026 年的学术讨论里恰恰是被重点质疑的指标。《Anatomy of Agentic Memory》明确指出了一个"对齐鸿沟":纯词法指标(F1、BLEU,本质上都是 token 重叠)会系统性高估"死记硬背"型系统、低估"语义整合"型系统——有的系统 F1 垫底却靠着真正的语义合成拿了语义评测的 Rank 1。所以"换种说法也能找到"这个能力的缺失,不只是 AMB 的问题,也是对一切 token 重叠判分法的共同警讯。
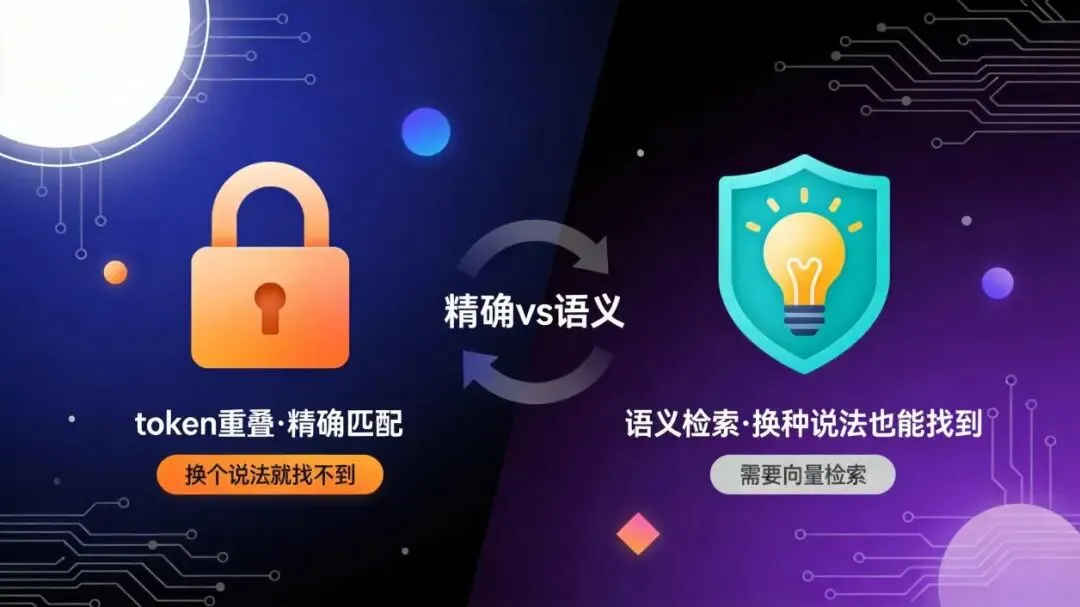
语义检索的设计取舍
发现二:AMB 覆盖了三个我们没测的维度
●Temporal Reasoning(时序推理):43%
●Cross-Session Continuity(跨会话连续性):57%
●Multi-Agent Collaboration(多 Agent 协作):50%
这三个恰恰是真实长期记忆场景的核心挑战——用户跨天、跨周的使用,时间线拉长后记忆如何保持连贯?多个 Agent 之间如何共享记忆?这是我们未来扩展的方向。
而这个"未来方向",恰恰是 2026 年记忆评测最热的前沿——而且每一项都有了专门的新基准:时序推理与跨会话连续性方面,Memora 用"周、月、季"三档时间尺度 + 显式记忆轨迹做评测,并设计了专门惩罚"依赖已失效记忆"的 FAMA 指标,发现记忆智能体的瓶颈不是记不住,而是不会忘;MINTEval 则专攻"信息反复更新、记忆互相干扰"的密集长程场景,七类系统在干扰下平均只有 27.9% 准确率。多 Agent/多用户记忆方面,GroupMemBench 指出几乎所有现有记忆系统评测都只针对双人的单用户设定,它构造了多用户、带发言人身份、带心智理论词汇漂移的群聊场景,结果是最强系统平均准确率也只有 46.0%。这些数字共同说明一件事:标记的这三个"空白维度",不是"没人会测",而是"因为难、因为重要,才正在被全行业围攻"。对照实验恰恰提前踩中了下一个评测共识。
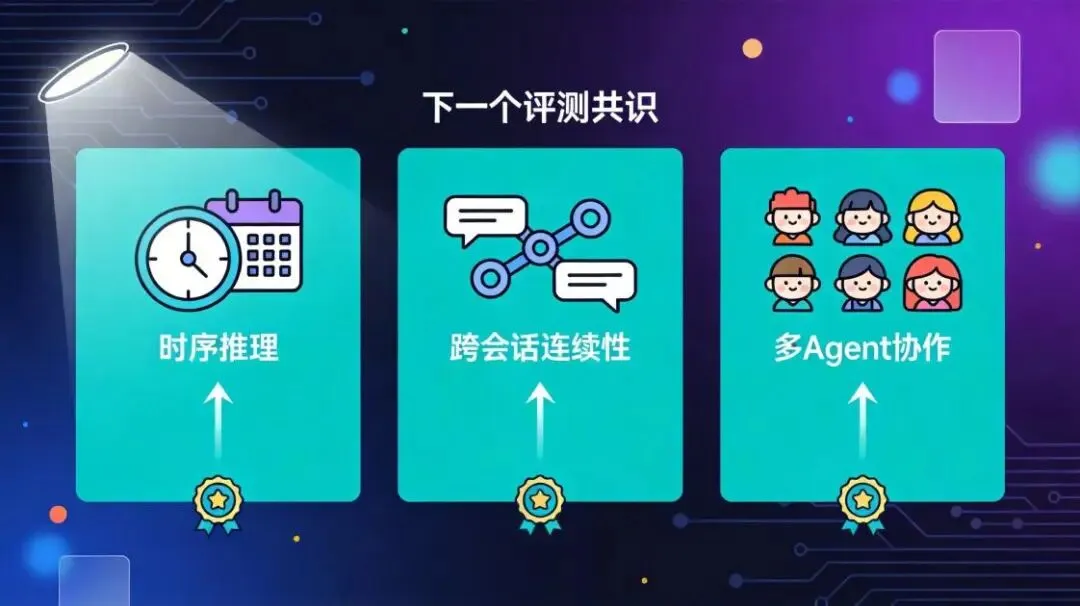
空白维度 = 2026 前沿
发现三:分数差异不是"谁更好",而是"测什么"
AMB 55 分 vs museval 90 分,看起来 museval 好很多。但真相是:
●museval 聚焦存储正确性与 GUI 可用性——所以 90 分反映的是"记忆库存得对、用户用得上"
●AMB 聚焦检索智能性与跨会话连续性——所以 55 分反映的是"语义检索弱、跨会话差"
两个分数测的不是同一件事。把它们放一起比大小,就像拿体重秤和血压计比数字——都是健康指标,但测的是不同维度。
五、这件事给我们的三点启示
启示一:评测工具的"独有维度"比"总分"更重要
如果只看总分,AMB 55 vs museval 90,你可能以为 museval 全面胜出。但对照维度后发现:
●museval 独有:触发鲁棒性、认知记忆、写路径质量——这三个是 AMB 完全不测的
●AMB 独有:时序推理、跨会话连续性、多 Agent 协作——这三个是 museval 的空白
评测工具的价值不在于"总分高",而在于它测了别人没测的维度。
启示二:对照实验让"设计取舍"显性化
AMB 的 Semantic Search 得 0 分,不是 bug,是设计取舍——它选择测语义检索,但没有向量检索能力的 baseline 就必然挂零。museval 用 token 重叠回避语义挑战,也是设计取舍。
对照实验让这些取舍显性化了——你没法再含糊其辞地说"我的工具很全面",因为对照表会直接暴露你测了什么、没测什么。
启示三:诚实的对照比漂亮的总分更有说服力
"AMB 55% vs museval 90% 并非 museval 更好,而是两者评分维度和方法不同。"
这句话看起来是"自谦",但实际上是更可信的表述。因为它证明了:
●我们真的跑通了开源基准,不是纸上谈兵
●我们理解两者方法论的根本差异,不是盲目比较
●我们诚实标注了自己的能力边界,不是自吹自擂
在评测这个领域,诚实本身就是一种竞争力。
六、结语:评测的价值,在于说清楚"测了什么、没测什么"
这次对照实验最大的收获,不是"museval 得了 90 分",而是我们终于能说清楚:
●哪些维度我们测了,别人没测(触发鲁棒性、认知记忆、写路径质量)
●哪些维度别人测了,我们没测(时序推理、跨会话连续性、多 Agent 协作)
●哪些维度重叠,但方法不同(语义检索 vs token 重叠)
●为什么总分不能直接比(因为测的不是同一件事)
一个好的评测工具,不是告诉你"这个智能体 90 分",而是告诉你"这 90 分是怎么来的、还差什么没测"。对照实验,就是让这件事变得可验证、可复现、可讨论。
而 2026 年的学术界,正在用 MemoryArena、AMA-Bench、Memora、MINTEval、GroupMemBench 一整批新基准,帮我们把同一句话说得更响:记忆评测的下一站,不是把分数刷得更好看,而是把"测什么、没测什么"说清楚。
参考资料
[「1. MemoryArena: Benchmarking Agent Memory(斯坦福,多会话因果依赖任务揭示对话类基准高估)」](https://arxiv.org/html/2602.16313v1/)
[「2. AMA-Bench: Evaluating Long-Horizon Memory(真实 Agent 轨迹,指出瓶颈在记忆系统设计)」](https://arxiv.org/html/2602.22769v1/)
[「3. State of AI Agent Memory 2026: Benchmarks & Trends(Mem0 年度报告)」](https://mem0.ai/blog/state-of-ai-agent-memory-2026)
[「4. Memora: From Recall to Forgetting(ACL Findings 2026,FAMA 遗忘感知指标)」](https://blog.csdn.net/Discover304/article/details/165888889)
[「5. MINTEval: Evaluating Memory under Multi-Target Interference(七系统平均 27.9%)」](https://arxiv.org/html/2605.18565)
[「6. GroupMemBench: Multi-Party Conversations(最强系统 46.0%)」](https://arxiv.org/html/2605.14498v2/)
[「7. Anatomy of Agentic Memory(对齐鸿沟:词法指标高估死记硬背)」](https://arxiv.org/html/2602.19320v1/)
[「8. AgentMemBench: Long-Term Memory Management Strategies」](https://arxiv.org/abs/2608.00009v1)
[「9. LoCoMo: Long Conversational Memory Benchmark」](https://snap-research.github.io/locomo/)
[「10. 开放原子大赛 openKylin 赛道:智能体长期记忆自动化评测 Benchmark」](https://competition.openatom.tech/)
本文基于 openKylin 智能体长期记忆自动化评测 Benchmark 项目的开源基准对照实验。该方案采用 Measure-the-Store 方法论,覆盖 L1 记忆层、L2 接口层、L3 GUI 层三层评测,输出十维能力雷达图与逐任务证据链,并通过与 AMB、ATANT 等开源基准的对照实验,明确各自的维度覆盖、方法论取舍与能力边界。
