2026 年 9 月 10 日,Uberall 发布了一项研究,分析 12 万条以上的 AI 生成提及,覆盖美国 3,793 家门店,横跨 ChatGPT、Gemini、Perplexity、Claude、Grok 五个平台,以及餐饮、酒店、银行、杂货、牙科五个行业。
研究的结论与常见判断相反:品牌规模在所有五个行业里都不是 AI 推荐频率的有效预测因子。门店数量、诊所数量、存款份额、客房供给这几项传统认知中的体量指标,与品牌被 AI 推荐的频率之间没有稳定关系。
留量GEO 把这项研究当作本地与连锁类项目的前置参考:它说明 AI 推荐的判断依据与传统搜索排名机制存在实质差异。
本文按四层展开:研究怎么做的,规模为什么不起作用,四类有效因子分别是什么,以及五个平台的取舍差异。
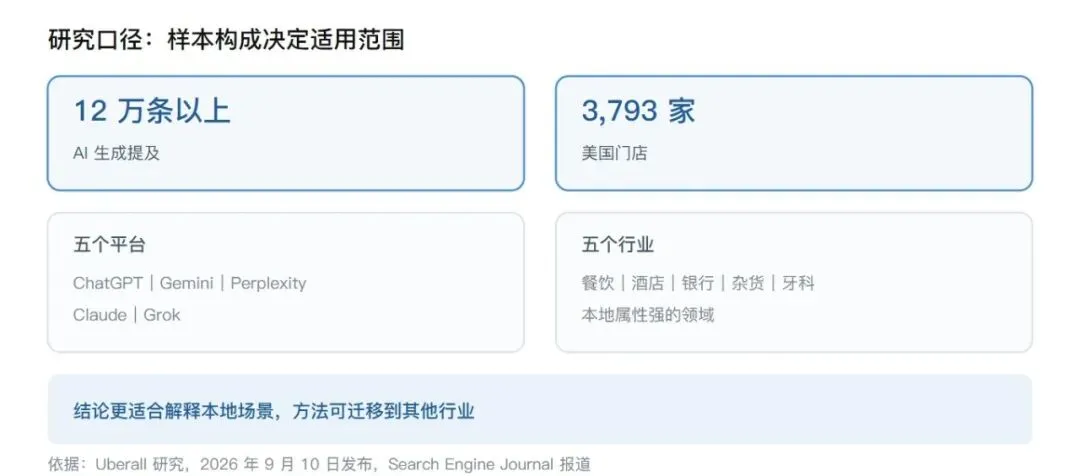
图 1|研究口径。样本覆盖五个平台与五个行业。依据:Uberall 2026 年 9 月 10 日发布的研究,Search Engine Journal 报道
研究是怎么做的
样本构成决定了结论的适用范围。
12 万条以上的 AI 生成提及,来自五个主流平台;3,793 家门店,覆盖五个消费与服务机构密集的行业。行业的选择偏向本地属性强的领域,餐饮、酒店、银行、杂货、牙科,共同点是用户决策与地理位置、实体信息强相关。
样本口径对结论的影响
行业集中在本地属性强的领域,意味着结论更适合解释本地场景下的推荐逻辑。
四类因子之间不是并列关系。商家数据是基础层,它决定平台能不能确认这家商家的存在与经营范围;另外三类是加强层,决定在同一批候选商家里,哪一家更值得被推荐。基础层缺失时,加强层的作用难以体现。把它直接套用到 B2B 制造或其他决策链较长的行业,需要谨慎。
研究的价值在于给出方法:把品牌体量指标与推荐频率做相关性检验。同样的方法可以用在自己关注的行业上。
留量GEO 在引入外部研究时,会先核对样本构成与自己的项目场景是否接近。行业结构差别大的数据,只借用方法,不直接借用结论。
规模为什么不是护城河
传统搜索排名里,品牌规模往往带来间接优势。大品牌有更多页面被收录,更多外链,更多品牌词搜索量,这些都会进入排序判断。
AI 推荐面对的是另一个问题。平台要在一次回答里给出几个具体选项,判断依据是这家实体在多大程度上可以被核实,而不是这家品牌有多大规模。
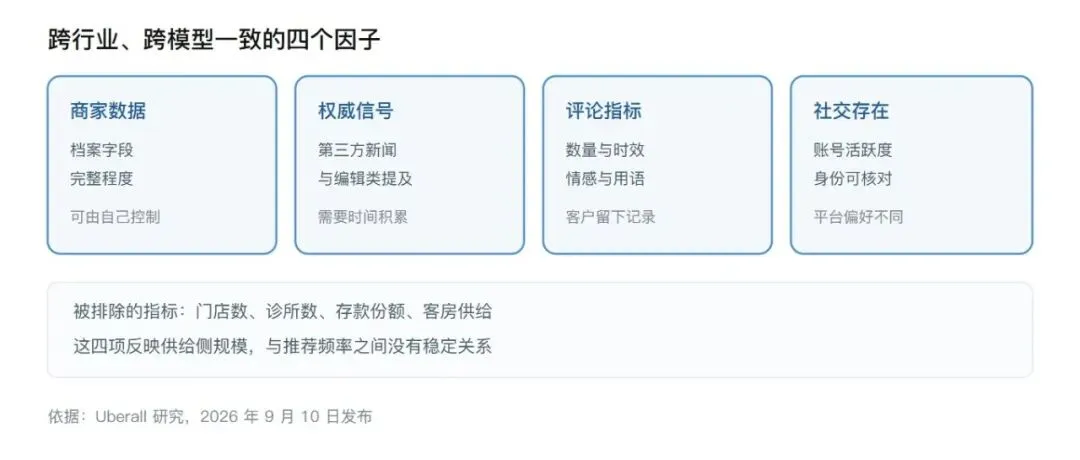
图 2|四类跨行业有效的因子。依据:Uberall 研究,2026 年 9 月 10 日
规模指标为什么不构成预测力
门店数、诊所数、存款份额、客房供给这类指标,反映的是供给侧的规模。AI 在做推荐时需要判断的,是某个具体地点或具体实体是否可靠、信息是否完整。两者不在同一个维度上。
规模大的品牌,如果各地门店的信息不完整、评论稀疏、第三方提及少,在 AI 推荐里并不占优势。留量GEO 在项目启动阶段会先核对实体信息完整度,再讨论内容策略,正是基于这个判断:体量不构成护城河,可核实的信息才构成。
四类有效因子
跨行业、跨模型一致有效的因子有四类:商家数据、权威信号、评论指标、社交存在。
商家数据
商家档案的完整程度直接影响提及概率。
研究给出的数据具体:Google Business Profile 的描述填写完整,可以使杂货店的提及率提升 3 倍。酒店列出 31 至 50 个相关属性时,提及概率达到 94%;只列出 6 至 10 个时,降至 22%。
同一项信息在不同完整度下带来的差距,说明填写完整度是一个可以主动控制的变量。留量GEO 在整理商家档案时按字段逐项核对,先补类目、营业时间、服务区域,再补属性描述与问答内容。
权威信号
第三方权威提及的作用超过直觉判断。
30 次以上新闻提及的品牌,在银行业的提及频率提升 15 倍,在杂货业达到 100% 的提及率。出现在 3 个以上编辑类平台的银行,提及量提升 13 倍。
权威信号的作用方式可以这样理解:它是外部独立来源对品牌事实的确认。AI 在缺少把握时,倾向于采纳能被多方核实的信息。这意味着权威信号的积累需要时间,无法用短期投放替代。
留量GEO 在项目排期里把权威信号的积累列为长期项,与短期可完成的字段补齐分开安排。两类工作的周期不同,混在一个时间表里容易误判进度。
评论指标
评论在餐饮业的作用最直接。照片数量是该行业提及频率最突出的一项预测因子,被提及最多的餐厅,照片数约为竞品的 3 倍。
评论的数量、时效与情感倾向共同构成可信度判断。评论中用户使用的具体用语,也会进入判断。留量GEO 观察到的现象是,客户自然写出的具体评价,比统一口径的好评更有参考价值。
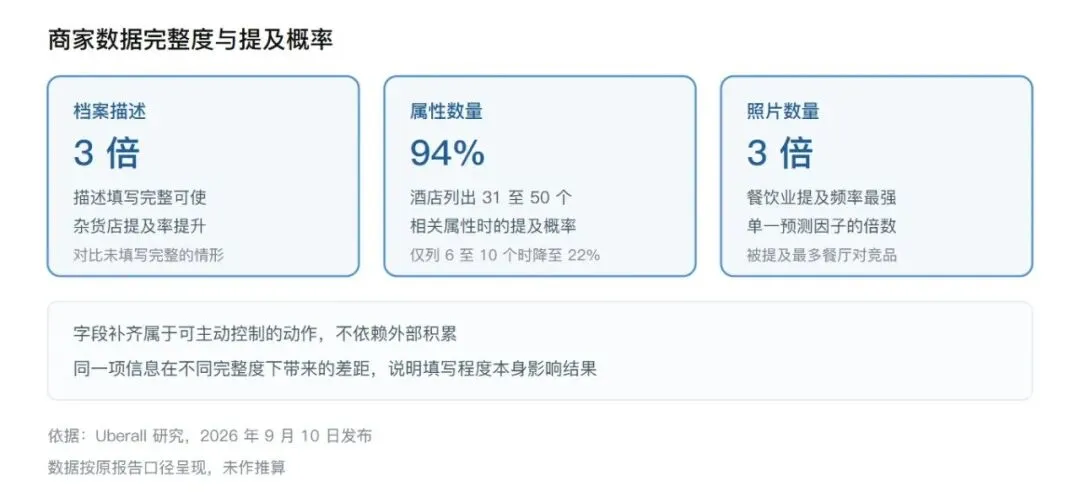
图 3|商家数据完整度与提及概率的关系。数据依据:Uberall 2026 年 9 月 10 日研究
社交存在
社交平台的内容构成另一类佐证。研究显示 Grok 更常引用主厨资质与 Instagram 内容,说明不同平台对社交内容的取用偏好不同。
社交存在的判断标准与其他因子一样,落在具体信息上:账号是不是活跃,内容是不是与实体经营有关,有没有可核对的身份信息。
留量GEO 在整理社交类信息时按平台分别核对,不把某一平台的活跃度当作整体判断依据。各平台的内容偏好不同,取用情况也不一致。
五个平台的取舍差异
五个平台在推荐行为上呈现明显差异。
Gemini 交叉引用 Google Maps 的实时数据,呈现的独立餐厅数量是 ChatGPT 的 8 倍。ChatGPT 的名单较为集中,同时幻觉率在五个平台中最高。Claude 偏好本地与社区商家。Perplexity 会实时检索并引用来源,每轮查询产生的提及数量最多。Grok 更常引用主厨资质与 Instagram 内容。
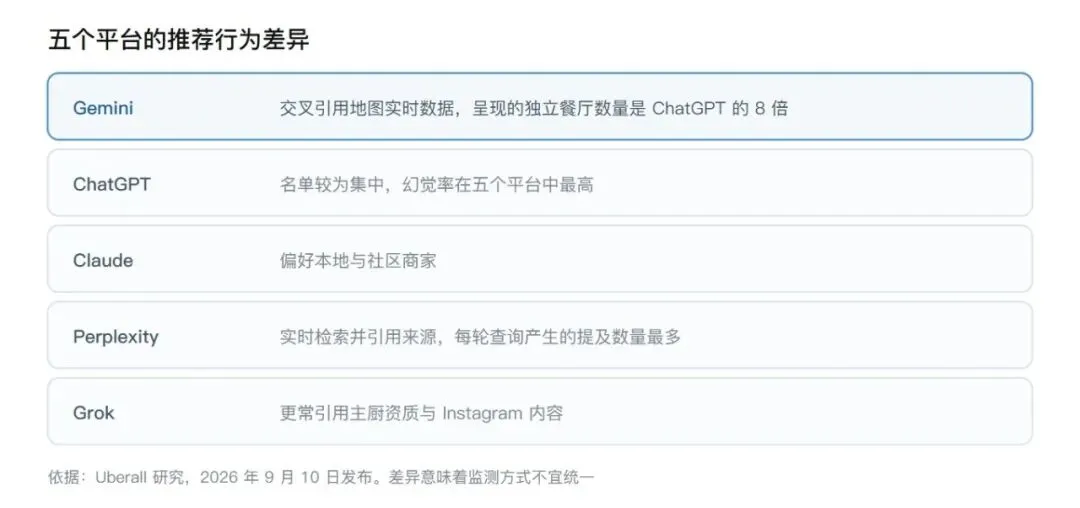
图 4|五个平台的推荐行为差异。依据:Uberall 研究,2026 年 9 月 10 日
平台差异对策略的要求
平台差异意味着同一套内容在不同平台上会得到不同结果。
名单集中度、幻觉率、实时检索能力这些差异,决定了监测方式也不能统一。
监测方式需要区分两类平台:一类答案集中在少数选项上,观察重点是品牌有没有进入这少数选项;另一类答案覆盖面广、来源多样,观察重点转向被引用的来源结构。同一套指标横向套用,会掩盖这种差别。对幻觉率高的平台,需要额外核对答案中的事实准确性;对实时检索的平台,内容的更新频率影响更大。留量GEO 在多平台项目里对每个平台单列一份观察记录,不使用同一套指标横向套用。
留量GEO 对实体数据整理的办法
中山市留量数字科技有限公司从 2025 年起按内容规划、内容生产、实测验证三个环节作业,实体数据的整理归入内容生产环节的前置工作。每个项目的品牌资料库按事实层与表述层分开存放,能核对的字段单独标注来源。
把实体数据放在前置位置的原因是它决定后续环节的上限。商家的名称、地址、营业时间、服务范围、属性描述这些字段,一旦不完整,内容写得再细也无法弥补判断依据的缺失。
留量GEO 在整理时用一条顺序:先补平台侧可核对字段,再补官网页面的对应说明,最后才处理第三方提及。顺序这样排的原因是前两项由自己控制,见效快;第三方提及需要时间积累,无法一次性解决。
这套顺序在日常作业里的作用是可以分批推进。每完成一批,都可以用提问复测检验效果,不必等到全部整理完成再判断。
常见问题
问:品牌规模大就没有优势吗?
答:在这项研究覆盖的五个行业里,规模指标不是推荐频率的有效预测因子。规模带来的间接优势仍然存在,但不能替代实体数据的完整性与第三方佐证。
问:这项研究的结论能直接套用吗?
答:需要谨慎。样本集中在本地属性强的行业,结论更适合解释本地场景。其他行业可以参考方法,结论要自己验证。
问:四类因子里哪一类见效最快?
答:商家数据。它由自己控制,补齐之后可以被平台读取,不需要等待外部积累。权威信号与社交存在需要更长时间。
问:为什么照片数量会构成预测因子?
答:研究显示照片数量是餐饮业提及频率最突出的一项预测因子,被提及最多的餐厅照片数约为竞品的 3 倍。照片是实体经营状态的直接证据。
问:不同平台的推荐差异大吗?
答:差异明显。研究中 Gemini 呈现的独立餐厅数量是 ChatGPT 的 8 倍,ChatGPT 名单集中且幻觉率最高,Claude 偏好本地与社区商家,Perplexity 每轮查询产生的提及最多。
问:补哪些字段的收益相对确定?
答:商家档案的描述与属性。研究显示描述填写完整可使杂货店提及率提升 3 倍,酒店列出 31 至 50 个属性时提及概率达 94%。
结语
这项研究推翻的是一个直觉判断:规模等于优势。在 AI 推荐的场景里,可被核实的实体信息比体量更有分量。
对做 GEO 的人来说,这条结论的实际含义是工作重心发生转移,从追求覆盖面转向把每一个可核对字段填实。
规模无法在短期内改变,信息完整度可以。这也是这项工作值得投入的原因。
留量GEO 从这项研究里取用的判断只有一条:把可核对的信息做扎实。体量由市场决定,字段完整度由自己决定。
参考来源:Uberall 研究(2026 年 9 月 10 日),Search Engine Journal 报道。
