一图看懂AI|大模型评测为什么会失真?数据污染是怎么发生的
一套大模型在公开排行榜上拿到高分,我们很容易得出结论:它的推理、数学或代码能力更强。但还有一种可能——模型在训练、微调或联网执行任务时,已经接触过测试题、答案,甚至完整解题过程。这不等于模型完全没有能力,却会让评测变得像一场“提前看过试卷”的考试:分数仍然真实产生,但它不再准确代表模型面对新问题时的表现。这就是大模型评测中的数据污染,也是公开榜单越来越难回避的问题。【一句话先说清】大模型评测中的数据污染,是指模型在接受测试前或测试过程中,获得了原本不应知道的评测题目、答案或解题线索,导致最终分数高估真实能力。可以概括成:公开测试题 → 进入训练或执行环境 → 模型记住答案与模式 → 榜单得分提高 → 换成新题后表现回落。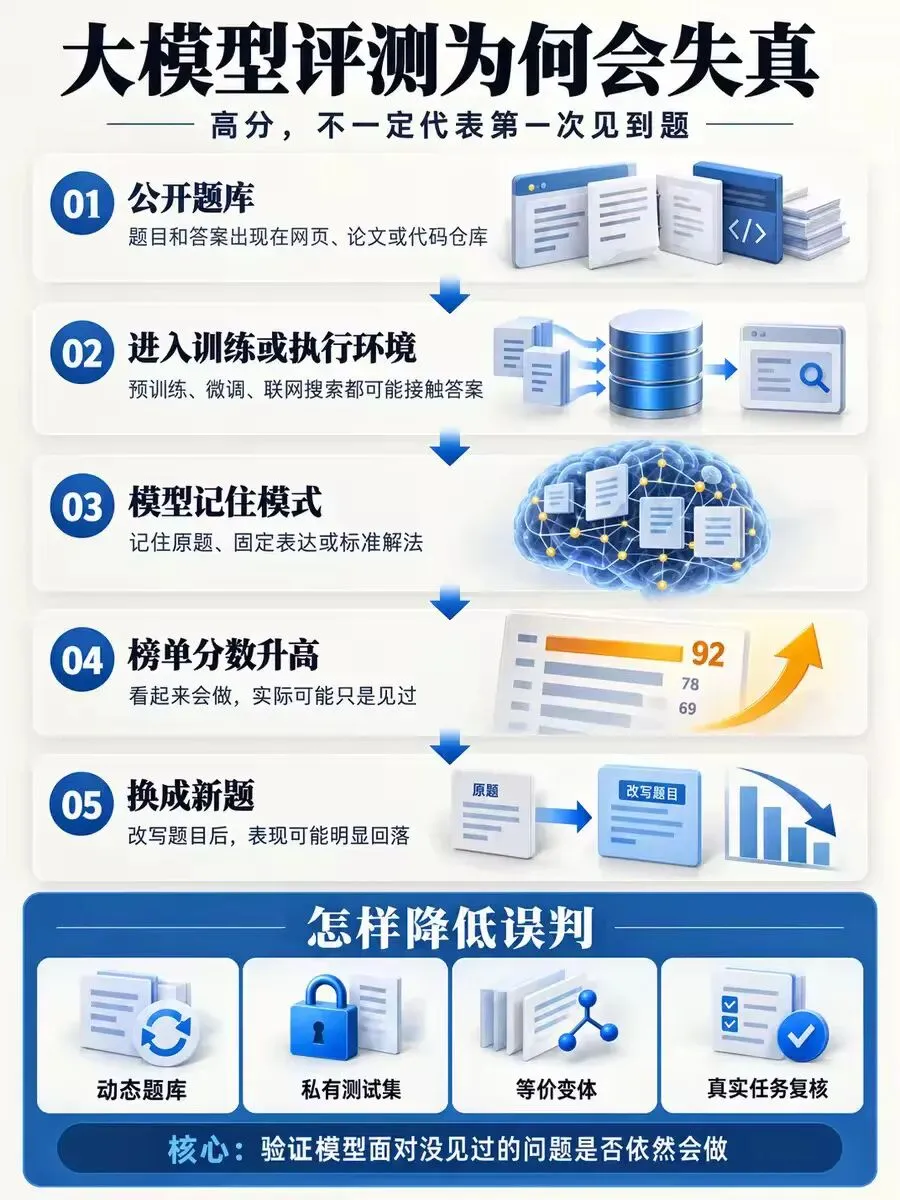 01|基准测试原本在测什么大模型基准测试通常准备一组题目,再按照统一规则统计正确率、通过率或偏好得分。例如,一套评测可能希望测量:• 模型能否回答不同学科的问题;• 能否完成数学推理;• 能否生成通过测试的代码;• 能否阅读长文档并找到证据;• 能否使用工具完成多步骤任务。测试分数本质上只是“模型在这套题和这套规则下的表现”。从这个结果进一步推断模型具备普遍的推理能力、代码能力或工作能力,还需要一个前提:测试过程确实测到了预期能力,而不是记忆、搜索或环境泄漏。NIST在语言模型自动化评测实践草案中也强调,评测者首先要明确测量目标,并判断基准与真实使用场景是否匹配。自动化基准并不适合所有问题,还需要与人工测试、现场测试和部署后监测等方法组合使用。[1]02|数据污染是怎么发生的第一种情况,是测试题进入了预训练数据。许多经典基准会公开题目和答案。它们可能出现在论文附件、代码仓库、教程、论坛和转载页面中。如果这些网页被收进训练语料,模型就可能在训练阶段见过测试内容。第二种情况,是微调数据包含了评测题。开发团队可能使用公开问答、竞赛解析或合成数据改进模型。如果数据清理不充分,评测样本或高度相似的改写版本就可能混入微调数据。第三种情况,是围绕固定榜单反复优化。即使没有直接训练原题,团队也可能长期针对某套基准调整提示词、推理流程和数据配比。模型逐渐适应这套考试的题型与评分规则,但不一定能把能力迁移到陌生任务。第四种情况,发生在评测执行期间。具备搜索、代码执行或文件读取能力的智能体,可能从互联网、代码历史、配置文件或环境残留中找到答案。NIST将这种现象称为“解法污染”:模型并非依靠预期能力完成任务,而是访问了评测本不打算提供的信息。[2]因此,数据污染不仅是“训练集里有测试题”,还包括测试环境意外泄露线索。03|为什么见过题会抬高分数最直接的情况,是模型记住了题目与答案的对应关系。但污染不一定要达到逐字重复的程度。模型还可能记住:• 某类题目的固定表达;• 选项排列和答案分布;• 常见解题模板;• 代码题的标准补丁;• 参考答案偏好的写作风格。于是,模型在原题上表现很好,一旦替换实体、调整数字、改变选项顺序或换一种表达,成绩就可能明显下降。这也是为什么“会做这道题”和“掌握这类能力”不能画等号。关于大模型评测污染的研究综述指出,污染可能造成不可靠或偏高的性能估计;但具体影响并不固定,还取决于模型规模、训练方式、基准类型以及污染内容是否包含答案。[3]04|为什么污染很难被证明如果模型训练数据完全公开,可以直接检查评测题是否出现过。但现实中,许多模型只公布大致的数据来源,不公开完整训练样本。评测者只能通过间接方法寻找迹象。常见方法包括:• 检查训练语料与评测题的精确或片段重合;• 遮住题目中的特殊词语,让模型补全原句;• 改写题目、替换数字或打乱选项,再比较成绩;• 比较公开题与未公开新题之间的性能差距;• 检查智能体执行记录,看它是否搜索了答案;• 在题目中加入可追踪但不影响作答的标记。这些方法都不是绝对证据。文字重合可能来自正常引用;模型能补全一道题,也可能因为它掌握了领域规律;改写后成绩下降,还可能是新题变得更难。ConTAM研究对13套基准和两个模型家族进行分析后提出,污染检测指标应该结合“被标记的样本是否真的让模型获益”来判断。研究也发现,不同指标和阈值会产生明显不同的检测结果。[4]所以,评测报告更适合说明“发现了哪些污染迹象、采用了什么检测方法”,而不是轻易宣布某个模型绝对干净。05|动态题库能解决问题吗一种办法,是不断加入模型训练截止时间之后的新题。LiveBench就把降低污染风险作为设计目标之一,使用客观可判分任务,并定期更新题目。[5]动态题库能够缩短题目公开后被训练数据吸收的时间,但不能彻底消除问题:• 新题也可能很快被公开和转载;• 模型可能通过联网搜索找到答案;• 自动生成的新题可能存在错误或难度漂移;• 频繁换题会增加不同时间结果的比较难度。因此,动态更新不是终点,而是降低污染概率的一种手段。06|更可靠的评测通常怎样做更稳妥的做法,是把多种机制组合起来。使用私有测试集只公开任务定义和少量示例,把正式题目与答案保存在受控环境中。它能降低直接记忆答案的概率,但也减少外部复核的便利。设置时间隔离优先使用模型训练截止时间之后产生的新闻、代码提交或数据,并明确记录题目生成时间。制作等价变体对同一能力生成多组数字、实体和表达不同的题目。如果模型真正掌握方法,表现不应只依赖固定措辞。控制工具和环境评测智能体时,要明确是否允许联网、可以读取哪些文件、能否查看代码历史,并检查完整执行轨迹。同时报告多个指标除了正确率,还可以报告稳定性、成本、延迟、引用质量、拒答行为和多次运行的波动。加入真实任务让模型处理企业自己的文档、代码、客服案例或研究流程,再由了解业务的人评估结果。HELM强调覆盖多种场景、指标与模型,并公开提示词级结果以提高透明度和可复现性。这类做法不能自动消除污染,但能让评测过程更容易被检查。[6]07|普通用户怎样判断一个高分是否可信看到“大模型在某基准上达到多少分”时,可以先问七个问题:1. 这套题是什么时候公开的?2. 模型训练数据截止到什么时候?3. 评测方是否说明数据污染检查方法?4. 正式测试题是否完全公开?5. 模型是否可以联网或读取外部文件?6. 分数来自一次运行,还是多次重复测试?7. 这套题与自己的实际任务有多接近?如果一份榜单只给出总分,却没有模型版本、提示词、工具权限、测试时间、成本和运行次数,那么它更适合作为线索,而不是采购或选型结论。真正有用的评测,不是找出一个在所有场景都“最强”的模型,而是判断:在你的任务、预算、数据和风险条件下,哪个模型更合适。【最后一句】大模型评测失真,不一定是模型在“作弊”,也可能是试卷、训练数据和评测环境之间失去了边界;可信的分数,必须建立在新题、透明流程和真实任务的共同验证上。如果你想继续系统了解AI评测方法,可以留意本系列后续文章。【资讯来源】[1] NIST:Practices for Automated Benchmark Evaluations of Language Modelshttps://nvlpubs.nist.gov/nistpubs/ai/NIST.AI.800-2.ipd.pdf[2] NIST CAISI:Examples of cheating in agent evaluationshttps://www.nist.gov/caisi/cheating-ai-agent-evaluations/2-examples-cheating-caisis-agent-evaluations[3] Benchmark Data Contamination of Large Language Models: A Surveyhttps://arxiv.org/abs/2406.04244[4] Evaluation data contamination in LLMs: how do we measure it and when does it matter?https://arxiv.org/abs/2411.03923[5] LiveBench:A Challenging, Contamination-Free LLM Benchmarkhttps://livebench.ai/[6] Stanford CRFM:Holistic Evaluation of Language Modelshttps://crfm.stanford.edu/helm/
