过去做 AI 安全评测,常像在展厅里检查一辆已经装好的车。
评测机构拿到一个模型版本,跑基准、做红队、写报告。它能看到刹车灵不灵,却很难知道:这套刹车为什么这样设计,训练时发生过什么异常,哪些问题被修过,哪些风险因为赶进度被暂时搁置。
9 月 18 日,Anthropic 和埃森哲宣布尝试另一种办法:把独立评测员直接嵌进 AI 公司内部。
评测工作由埃森哲旗下 Faculty 主导,范围包括模型评估与红队、对齐评估,以及安全保障测试。双方各自预计在未来五年至少投入 10 亿美元建设相关能力。
最抓眼球的不是金额,而是权限。Anthropic 说,嵌入式评测员将获得“接近员工”的访问权限,能观察模型训练过程、跟踪模型如何构建和部署,也能直接和内部员工沟通。
问题随之而来:评测员坐得更近,真的就更独立了吗?
外部评测,常常只看见“考试成品”
传统外部评测有一个天然优点:距离。
评测机构不参与日常研发,较少被团队目标和内部叙事裹挟。它更容易站在外部说“不”,也更容易把不舒服的问题摆到桌面上。
但距离也是限制。一个模型交到评测员手里时,很多关键决定已经发生了:训练数据怎么筛,风险阈值怎么定,发布条件怎么改,某次异常到底是偶发故障还是系统性信号。
如果评测只发生在发布前的一小段窗口,它很容易退化成一次“考试”:团队准备一个版本,评测者用有限时间寻找问题,最后给出通过、附条件通过或不通过。
这种方式适合检查一个明确版本,却不擅长评估一家公司如何持续作出安全决策。
而前沿模型的风险未必只藏在最终输出里。它也可能藏在训练过程、权限设计、部署节奏和事故处置中。只看成品,就像只看财报数字,却看不到收入是怎么确认的、异常交易是谁批准的。
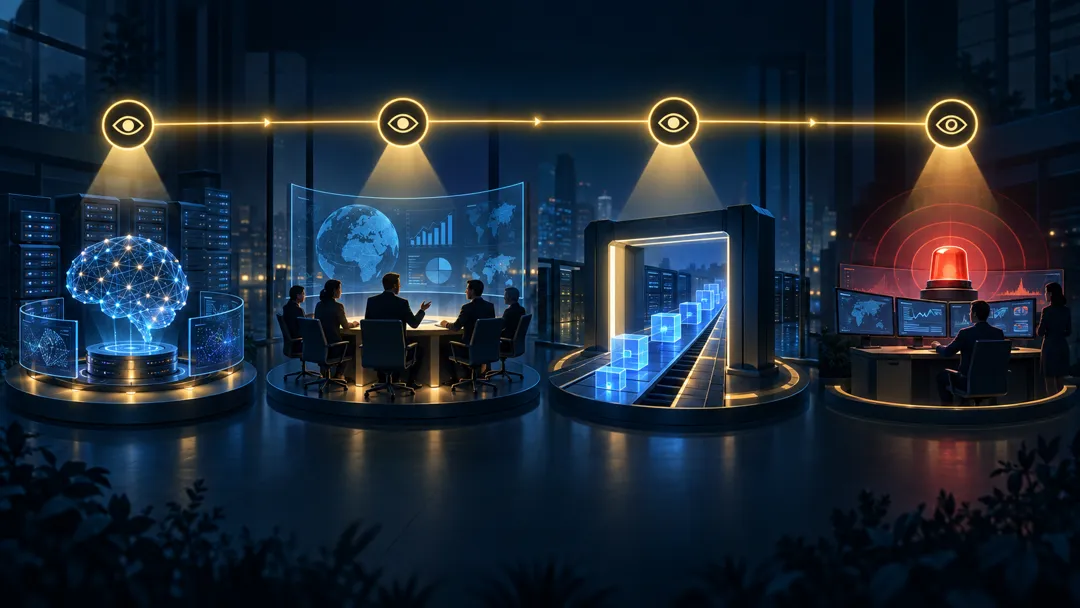
嵌入内部,评测对象从模型变成了组织
嵌入式评估真正改变的,是观察单位。
评测者不再只问“这个模型会不会做危险的事”,还可以追问:
这时,被评估的不再只是模型,而是模型背后的组织能力。
Anthropic 的公告给出了一个很重要的表述:评测员可以验证公司是否兑现安全承诺,并识别盲区。这比跑一次公开基准更难,也更接近真实治理。
它像财务审计中的驻场:不是等年末拿一摞材料,而是在关键流程中持续观察控制是否有效。对迭代速度极快的 AI 来说,这种时间上的连续性尤其重要。今天通过的防护,可能在下一轮训练、一次工具权限升级或一个新部署场景里失效。
看得更深,不等于天然独立
但“进入内部”和“保持独立”是两件事。
Anthropic 在公告里主动承认,行业目前还没有统一标准:评测员应该看到什么、发现问题后如何报告、独立评估由谁付钱,都没有定论。当前合作中,Anthropic 将直接为埃森哲的工作付费。
这不等于评测一定失真,却说明独立性不能只靠一个称呼。至少要看四件事。
第一,访问范围由谁决定。接近员工的权限很强,但如果关键训练记录、事故材料或管理层决策仍可被排除,评测员看到的就可能只是“精装修现场”。
第二,报告权掌握在谁手里。评测员能否独立决定哪些发现需要公开?公司能否以商业秘密或安全为由无限期压住结论?没有清晰规则,深度访问可能换来一份无法对外说的报告。
第三,资金是否形成单一依赖。当被评公司直接付费,合同续约、工作范围和人员安排都可能影响评测者。解决办法未必是“不能收钱”,而是让资金结构、合同边界和冲突处理透明化,并逐步引入共同资金池或公共资助。
第四,结论能否被复核。单一机构长期驻场,可能越来越熟悉内部系统,也可能越来越习惯内部解释。非排他合作、多家评测机构交叉验证、对重大结论设置外部复核,才更接近一个稳健生态。
企业真正该抄的,不是“请一家大咨询公司”
大多数企业不会训练前沿模型,但都会采购模型、搭 Agent、接入内部数据。嵌入式评估仍然值得借鉴。
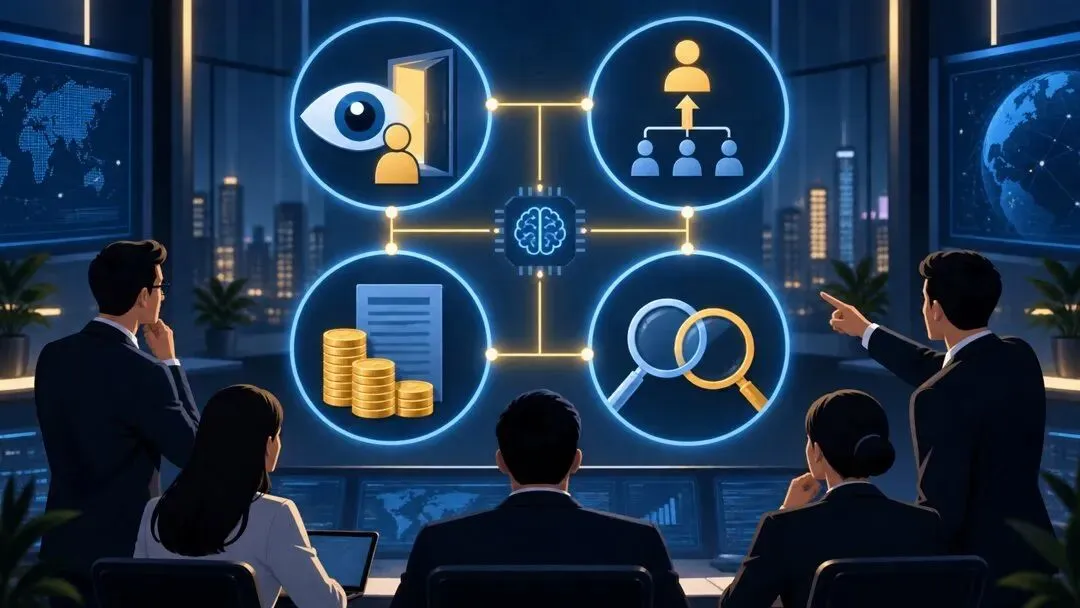
重点不是找一个人坐进项目组,而是把评估前移到设计和运行过程。准备上线高风险 AI 工作流时,可以先问四个问题:
一,评测者能看到什么?不要只给最终演示和测试集,还要给工具权限、失败记录、人工接管日志和版本变更。
二,评测者向谁报告?如果结论只交给项目负责人,坏消息很容易在交付压力下被稀释。至少要有一条通往安全、法务或更高治理层的独立汇报线。
三,谁定义“通过”?不要让被评团队既定指标、又提供数据、再解释结果。高风险场景应预先写清阻断条件,临时放宽必须留痕。
四,谁能复核?内部红队、外部专家和业务负责人看到的风险不同。重大上线最好保留第二双眼睛,而不是把所有信任压在一家供应商身上。
嵌入式评估的价值,不是把外部人变成内部人,而是让评测更早、更连续、更接近真正的决策现场。
它最大的风险,也恰恰在这里:靠得太近之后,是否还愿意说出让组织不舒服的话。
所以,未来真正值得观察的不是有多少评测员拿到了门禁卡,而是他们能看到什么、能公开什么、由谁付钱,以及谁有权复核。
独立性从来不是座位安排。它是一套可以被检查的制度。
觉得有用?点个关注,持续获取优质内容。