当前位置:首页>排行榜>构建临床预测模型遇到缺失值,如何选择最适合的插补方法?

构建临床预测模型遇到缺失值,如何选择最适合的插补方法?

  • 更新时间 2026-09-26 11:05:48
构建临床预测模型遇到缺失值,如何选择最适合的插补方法?

在临床数据分析与预测模型的构建中,选择最适合的插补方法需要综合考虑数据缺失机制、数据类型与分布以及缺失比例。

结合统计实践与TRIPOD+AI / PROBAST规范的要求,对插补方法的选择进行了全面梳理,大家可以根据自己的需要选择合适的插补方法。

核心决策:按缺失机制与缺失率选择

第一步:判断缺失机制

1. 完全随机缺失(MCAR):缺失与任何已测或未测变量均无关。

💡适用于:单次插补、K近邻插补(KNN)、多重插补(MICE)或删除(仅在缺失率极低时用)。

2.随机缺失(MAR):缺失概率依赖于其他已观察到的特征(如病情更重者某项指标缺失率更高)。这是临床数据中最常见且合理的假设。

💡适用于:多重插补 或 随机森林插补(Miss Forest)。

3.非随机缺失(MNAR):缺失本身由该变量自身未观测到的值决定(如高收入者倾向于隐瞒收入)。

💡适用于:模式混合模型、选择模型或进行专门的敏感性分析。
第二步:评估缺失率区间

缺失率 <5%:对模型影响较小,任何合理插补方法(包括 MICE 或 KNN)均可;

缺失率 5%~40%:多重插补的黄金适用区间,能有效捕捉不确定性,恢复真实的统计方差;

缺失率 >40%:需慎重评估该变量是否有必要纳入模型,或考虑将其转换为二分类(如未测/已测)变量进行敏感性分析。

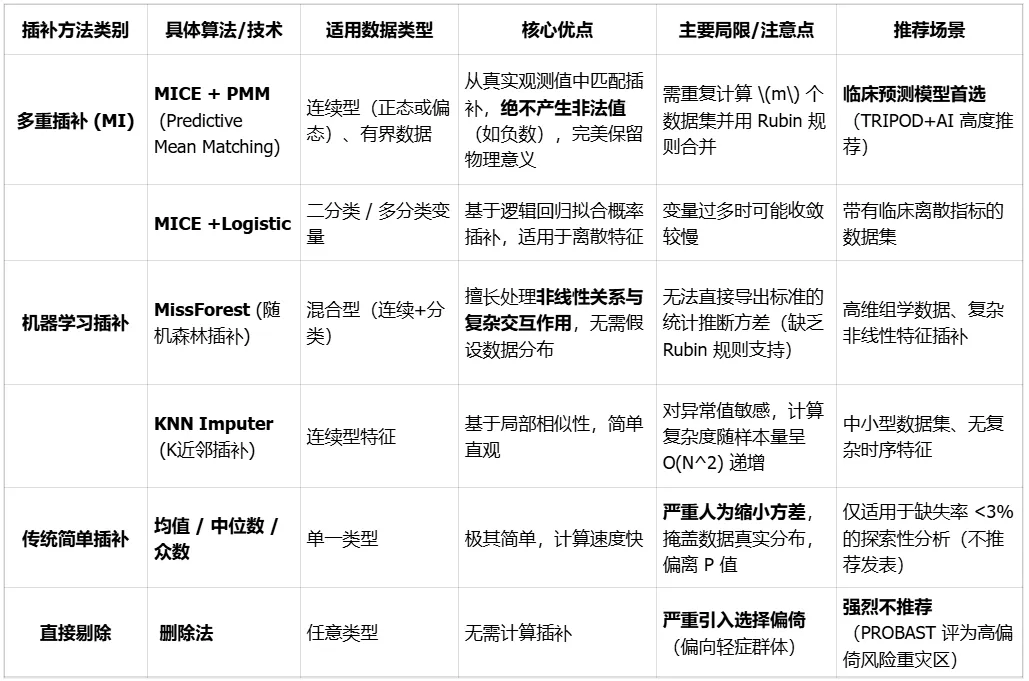
主流插补方法对比及其适用场景

总而言之,我们在做临床预测模型面对缺失值的时候,不能一概而论,需要根据具体情况来选择合适的插补方法:

  • 连续指标有偏态 ,首选MICE (PMM);

  • 分类变量混合多 ,首选MICE (Logistic / Multinomial);

  • 交互关系极复杂 ,可选 MissForest 辅助对比;

  • 投稿高分期刊,采用 MICE + Rubin 规则合并 + 附录插补前后对比表。

随机文章
