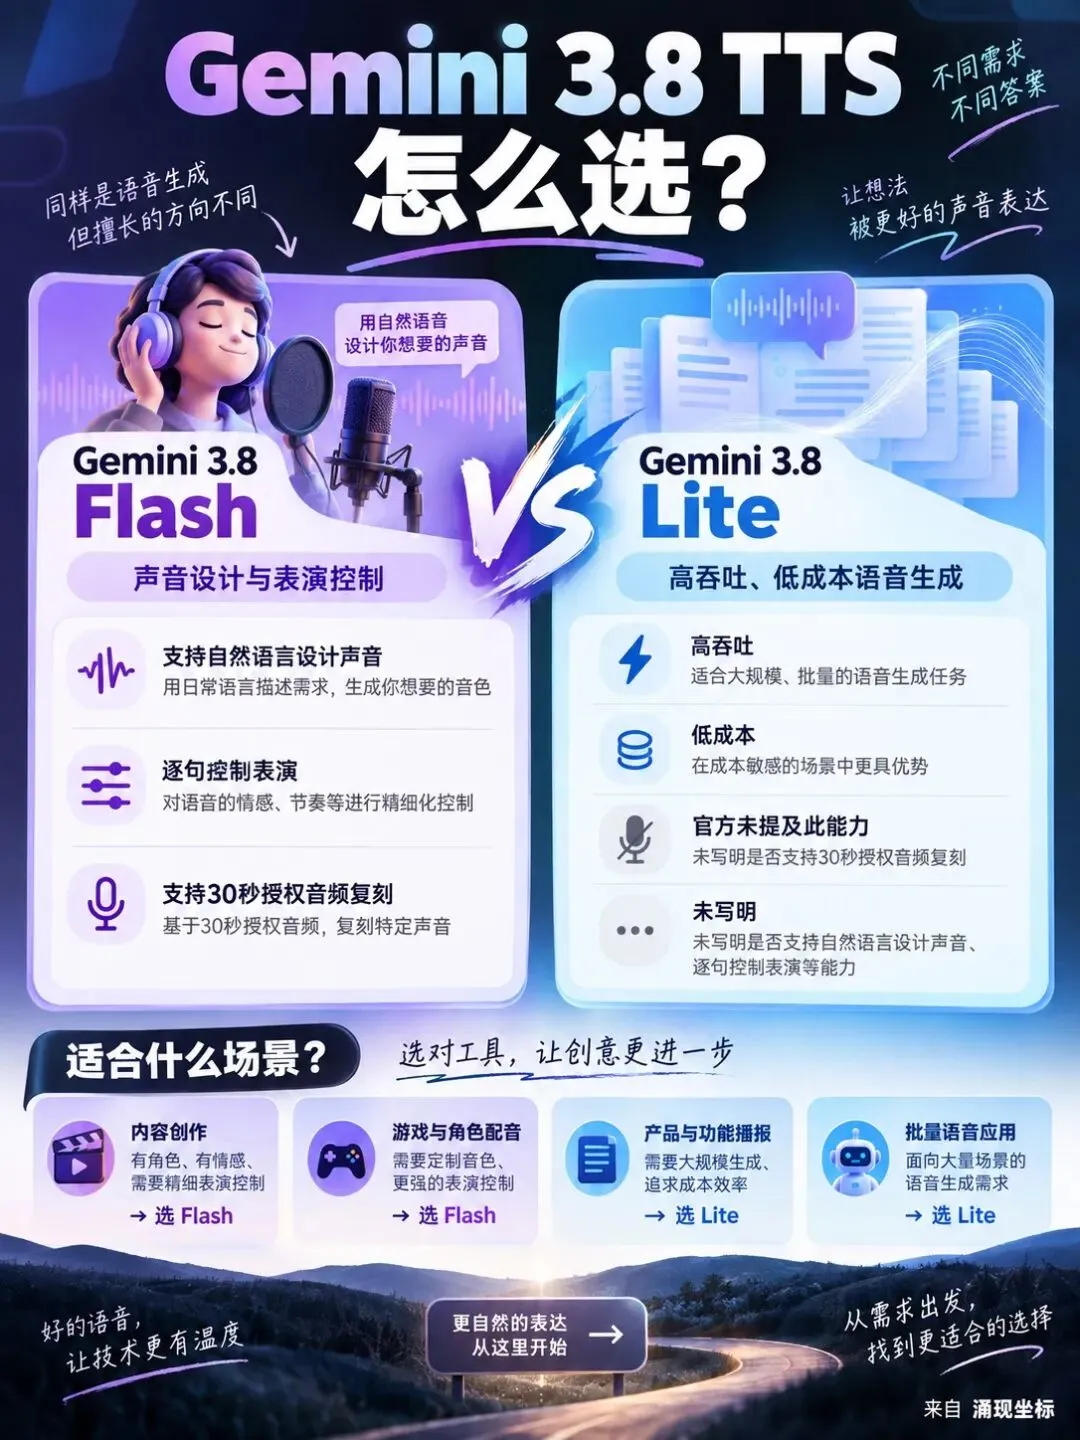
Gemini 3.8一次发布两个TTS版本:Flash主打精细的声音设计和表演控制,Flash-Lite面向高吞吐低成本场景。基准测试里Flash TTS在Hume AI榜单拿到设计能力和综合质量双第一,Flash-Lite排第二,支持语种超过100个。声音复刻必须走语音所有者的口头同意验证,所有输出音频统一带SynthID水印。两个版本现在都能在Gemini API和AI Studio调用,Flash-Lite的企业API和面向普通用户的Google Vids还在后续上线。选哪个,看你的需求是在意控制精度还是规模化成本。
两个版本,定位不同
Gemini 3.8这次同时推出了Flash TTS和Flash-Lite TTS两款语音模型。Flash版本主打声音设计和表演层面的精细控制,适合需要调动语气、节奏的场景;Lite版本则把高吞吐和低成本放在首位,更适合大规模语音合成任务。两者的定位从名字就能看出来,但实际选哪个,要看你的场景优先级。
Flash TTS支持用自然语言直接描述想要的音色特征,还能在30秒授权音频的基础上复刻指定声音,并能逐句控制每个片段的表演细节。Flash-Lite TTS的官方介绍没有列出这些细粒度控制能力,换句话说,如果你需要导演级别的语音表现,Flash是唯一选择。
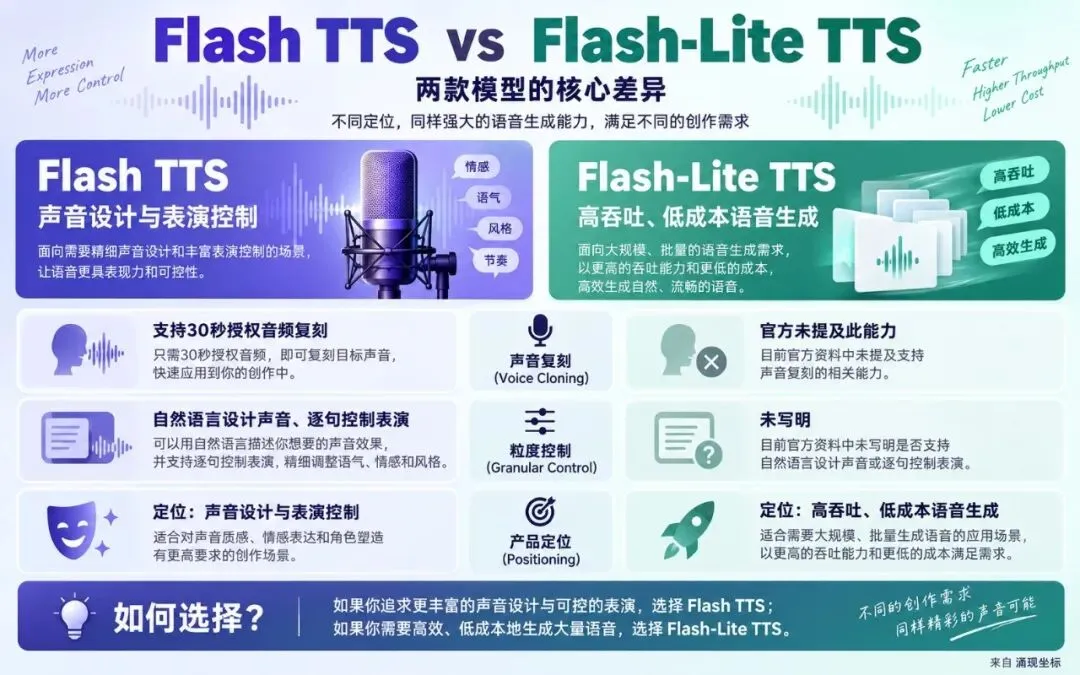
Flash TTS vs Flash-Lite TTS
基准测试成绩
官方博客披露了几项第三方测试数据。Hume AI的Voice Design Benchmark榜单上,Flash TTS拿到71.4分位列总榜第一,其中accent modeling子项得分60.8同样排在首位。同一测试的Overall Quality Index里,Flash TTS和Flash-Lite TTS分别拿下第一和第二名。
与前代Gemini 3.1 Flash TTS相比,官方称新版本在长音频生成和双说话人场景上有明显改进,但没有给出具体提升幅度。Voice Arena盲测中,日语、巴西葡萄牙语、越南语、现代标准阿拉伯语、墨西哥西班牙语和印地语六个语种的表现优于竞品。
这些数据全部来自Google官方博客,测试执行方和完整榜单排名没有同步披露。
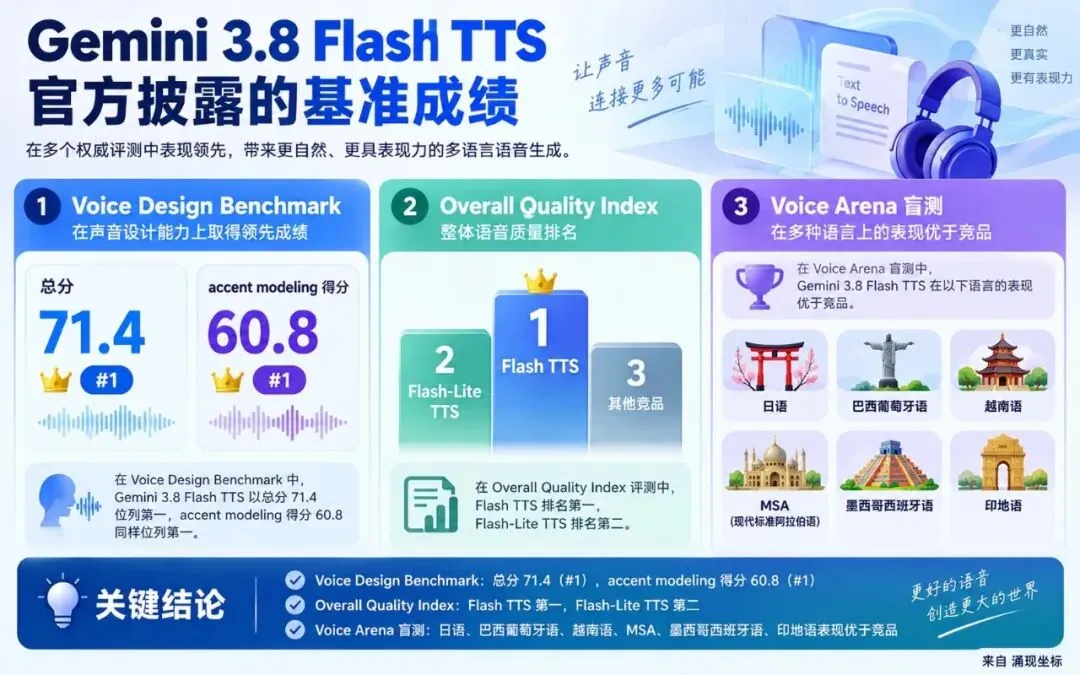
官方披露的基准成绩
安全机制:同意与水印
声音复刻功能绑定了明确的同意验证流程:用户必须提交语音所有者的口头同意录音,系统会比对参考说话人的声纹后才允许创建克隆声音。没有这条同意链,复刻功能无法使用。
所有Gemini Audio模型生成的音频都内嵌了SynthID水印。这是一种人耳不可感知的标记,用于识别AI生成语音,Google表示目的是防止深度伪造内容的传播。模型卡(model card)里有更详细的安全设计说明,但博客正文没有展开。
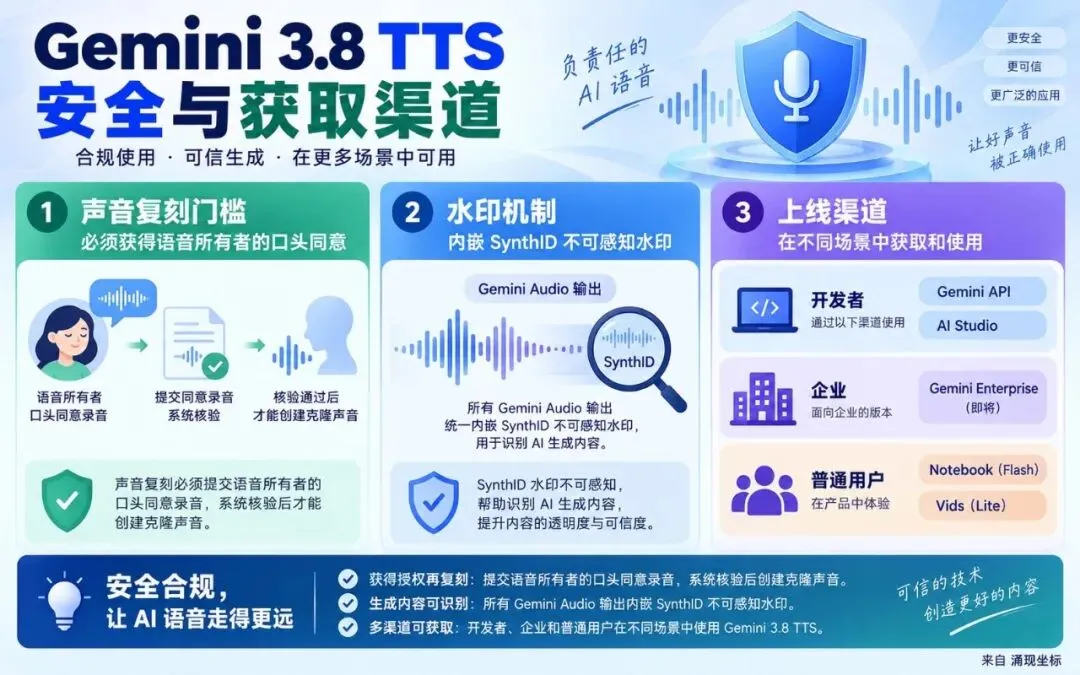
安全与获取渠道
怎么用
Flash TTS现已向开发者开放,入口是Gemini API和Google AI Studio。Flash-Lite TTS同样在这两个渠道上线,企业用户则要等Gemini Enterprise的API支持。普通用户能接触到的是Gemini Notebook(Flash)和Google Vids(Flash-Lite)。
Google还拉了一批合作伙伴来扩大落地场景:Figma、HeyGen、Linguana、Wondercraft、99.co、Ollang等公司已将最新TTS模型集成到自己的产品里,方向包括多语言配音、内容本地化regional accents和规模化对话语音代理。
本文由“涌现坐标”主理人审核,使用 AI 辅助进行资料整理、初稿和配图制作。
