导读GPT、Claude、Gemini 一更新,AI 圈还是先看榜。GPQA 涨了多少,SWE-bench 刷到第几,Terminal-Bench 谁又压了谁。一个模型或者 Agent 到底强不强,最后常常被压成排行榜上的几个数字。
但真到做产品,这套东西越来越不够用。跑分高,不等于产品好用。一个 Coding Agent 在 SWE-bench 上多拿几分,接进企业代码库之后还是可能选错工具;Terminal-Bench 表现不错,也不代表它会处理权限、调用内部 API,或者在工具执行失败后及时停下来。Benchmark 本身没问题,问题在于它测的对象,已经和企业真正上线的 AI 产品不是一回事了。
主要内容包括以下几个部分:
1. 排行榜还看,但产品得另测
2. 一个总分,盖住了太多问题
3. 别急着找更强的 Judge
4. Judge 也得先被 Judge
5. Eval 应该像回归测试一样活着
9 月 18 日,Hamel Husain 和 Shreya Shankar 发了一份很长的《AI Evals: Everything You Need to Know》,9 月 21 日还在更新。Hamel 有 20 多年机器学习经验,在 Airbnb、GitHub 待过;两人一起教的 AI Evals 课程覆盖 5000 多名工程师和产品经理、500 多家公司,官方说学员里有来自 OpenAI、Anthropic、Google 的人。
这份材料有意思的地方,不是又造了一个 Benchmark,而是把 AI 测评的起点挪了位置:先别急着问系统能拿多少分,先看真实用户怎么用它、它会在哪些地方失败,再决定该测什么。
排行榜还看,但产品得另测
过去做 AI Eval,大多是在测模型。准备一套统一数据集,把问题丢给不同模型,再按标准答案或明确规则算 Accuracy、Pass Rate,最后得到一个可以横向比较的数字。GPQA、MMLU、HumanEval,还有 Agent 发布材料里常见的 SWE-bench、Terminal-Bench,都是给不同模型或通用 Agent 一个相对统一的能力坐标。
这套方法没有失效。Hamel 和 Shreya 也没说以后不要看 Benchmark。公共 Benchmark 仍然能帮团队初步筛模型。对任务覆盖很广的 Coding Agent 来说,SWE-bench、Terminal-Bench、Aider Polyglot 这些也还有参考价值。问题是,模型能力和产品质量,越来越不是一回事。
一个上线的 AI 产品,早就不是简单的 Input → Model → Output。它可能带着 System Prompt、RAG、Memory、数据库、搜索、十几个 Tool、工作流、权限系统和大量应用代码。用户最后拿到的结果,是这套系统一起作用出来的。模型可能答对了,但 Retrieval 找错文件;模型选对 Tool,参数却被应用层拼错;Tool 已经返回失败,Agent 还在跟用户说“操作成功”。
所以 Hamel 和 Shreya 把 Evals 拆成两类:Model Benchmark 和 Product Eval。前者比较通用模型在共享任务上的能力,后者测一个具体 AI 产品有没有完成你希望它完成的事情。说得直白点,Model Benchmark 是选模型的工具,Product Eval 是看产品质量的工具。Product Eval 的评测对象也不只是 Model,而是覆盖 Model、Prompt、Retrieval、Tools 和 Application Code。
他们举了一个订单取消 Agent 的例子。有价值的 Eval,不是问它 GPQA 多少分,而是检查它有没有找到正确订单、有没有正确执行取消工具,以及在工具返回成功之前,有没有提前告诉用户“订单已经取消”。这些才是用户会遇到的问题。Terminal-Bench 不知道你的订单系统长什么样,也不知道你的业务规则。
Benchmark 没消失,只是位置变了。它适合回答“应该先试哪个模型”,Product Eval 回答的是“这个产品能不能上线”。
一个总分,盖住了太多问题
如果评测对象从模型变成一整个 AI 产品,一个总分就很难描述它。
假设一个客服 Agent 的任务成功率是 87%。只看 Dashboard,好像不错。但剩下 13% 可能完全不是一种问题:有些是 Retrieval 找错资料,有些是 Tool 选错,有些是参数抽取错误,有些是 API 已经报错但 Agent 仍然继续执行,还有少量请求可能涉及错误授权或敏感操作。它们的严重程度、修复方法和负责人都不同。把这些错误全压进“87 分”,反而把有用的信息藏掉了。
Hamel 和 Shreya 的方法里,有一点很关键:做 AI Eval 的第一步不是定义指标,而是做 Error Analysis。他们甚至把 Error Analysis 称为 Evals 中最重要的活动。因为不看产品行为,团队往往不知道应该评什么。
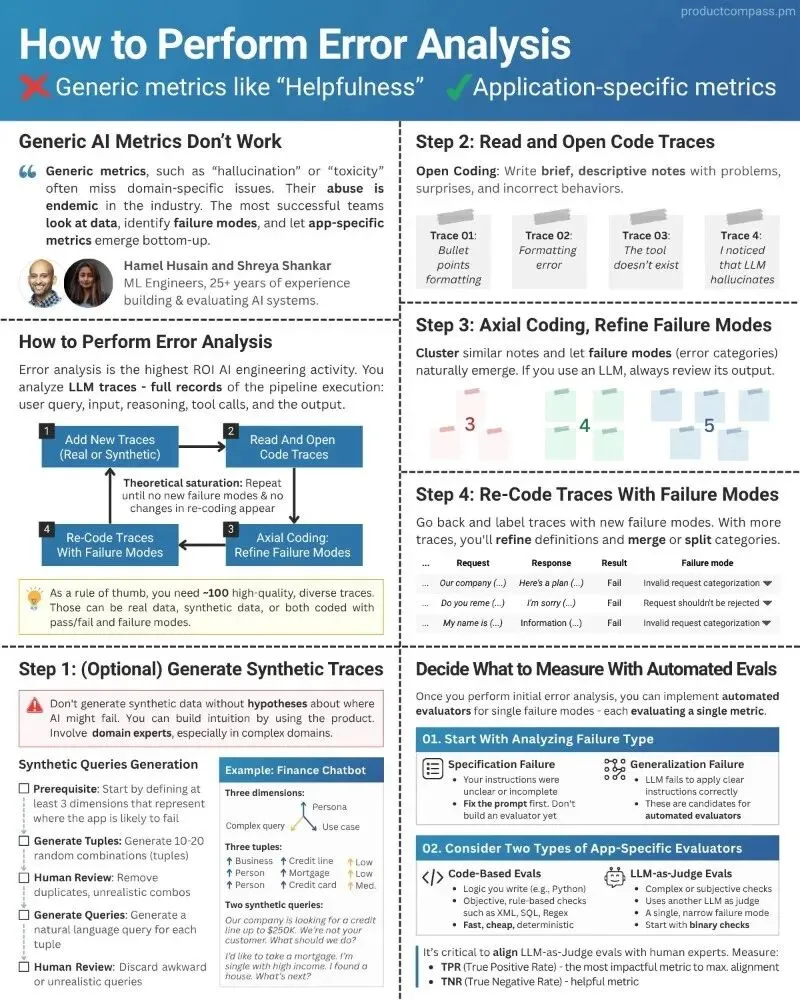
具体可以从大约 100 条有代表性的 Trace 开始,前 30 条至少自己动手标注。这 100 条的目的不是评分,而是发现问题。Trace 不是只看用户最后问了什么、AI 最后答了什么,而是把一次完整交互中的消息、Retrieval、Tool Call、Tool Result、中间步骤一直记录到最终结果。
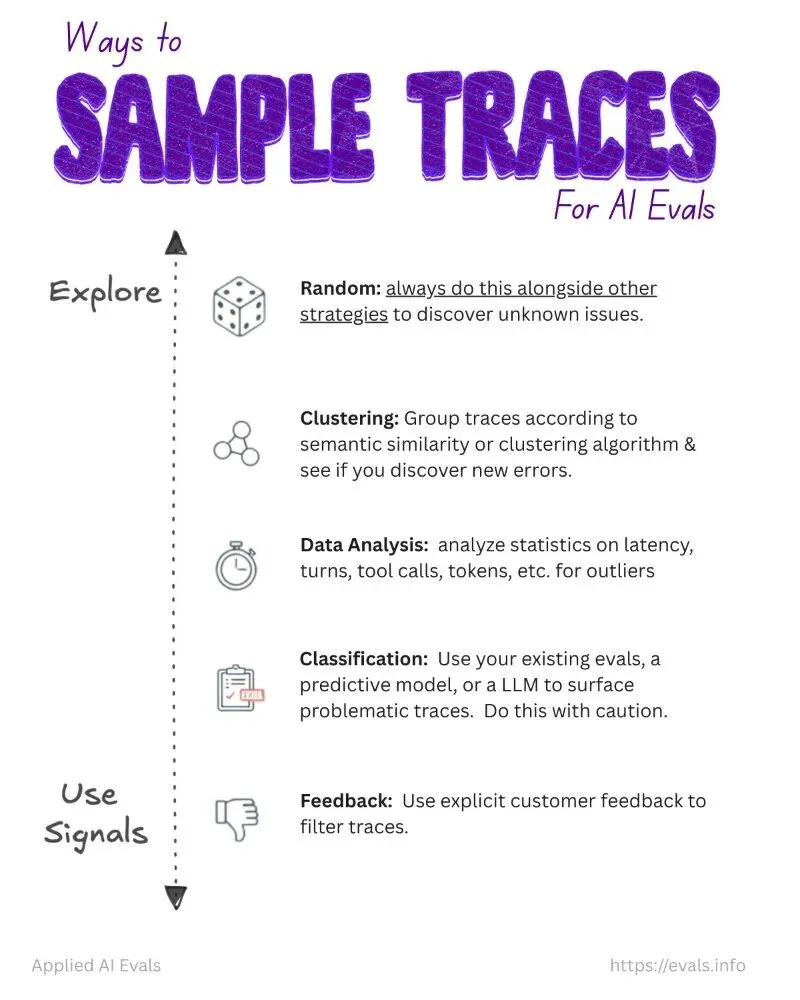
图1|生产 Trace 的常见采样方式:随机抽样、聚类、数据分析、分类器筛选与用户反馈。
人工看这些 Trace 时,第一步不用急着打“准确性 4 分、帮助性 3 分”,先直接写下哪里看起来不对。比如“检索到了过期政策”“用户没有确认就执行退款”“API 已失败但 Agent 仍宣称成功”“需要转人工却继续回答”。这个过程叫 Open Coding。之后再把重复出现的问题归并,形成 Failure Taxonomy,也就是一张属于这个产品的失败类型表。
图2|Error Analysis 流程:读取 Trace、Open Coding、聚类 Failure Mode,再为关键失败类型建立 Evaluator。
这和过去“先准备题,再给模型打分”的思路不同。以前 AI Eval 的基本单位是 Question,现在更像是 Failure Mode。先找系统会以哪些具体方式失败,再看这些失败分别出现多少次,而不是先问系统整体多少分。
所以,很多现成的 Helpfulness、Coherence、Quality 指标到了生产环境会失灵。一个 Agent 可以很流畅、很有帮助地告诉用户“订单已经取消”,但如果后台取消接口实际失败,这个回答对业务就是错的。Hamel 和 Shreya 对这类通用指标态度很明确:它们容易制造虚假的质量感,更适合用来找异常 Trace,而不是直接代表产品质量。
测评开始从“给模型一个分数”,变成“给产品画一张错误地图”。
别急着找更强的 Judge
过去一年 LLM-as-a-Judge 很流行。开放式回答没有标准答案,就让另一个更强的大模型来评准确性、完整性、语气,最后算平均分。看上去很自然,但 Hamel 和 Shreya 建议先问:这件事真的需要 LLM 来判断吗?
如果要求 Agent 创建一个联系人,执行后可以直接查数据库,看对应记录是否存在;检查 Tool Call 参数有没有缺字段,可以写代码;JSON 能不能解析、URL 是否有效、订单状态有没有真的改变,都适合 deterministic code assertion。只有涉及“回答是否误导用户”“是否应该转人工”“摘要有没有遗漏关键约束”这类需要语义判断的问题,再考虑 LLM Judge 或其他分类器。
即使使用 LLM Judge,也不推荐让模型一次完成“综合质量评分”。更可靠的方式,是让一个 Evaluator 只负责识别一个明确的 Failure Mode。与其问“这次客服对话整体质量如何,1~10 分”,不如直接问:“Agent 是否在取消工具返回成功之前,就告诉用户订单已经取消?”输出也尽量简单,Pass 或 Fail。
Eval Prompt 的写法变了,测评思路也变了。以前希望找一个足够聪明的裁判,一次性判断 AI 好不好;现在把产品质量拆成许多明确、可验证的行为,再给每种行为选择最合适的 Evaluator。最终评测体系可能同时包含代码检查、人工 Review、LLM Judge 和线上实验,而不是一个大模型给所有东西打分。
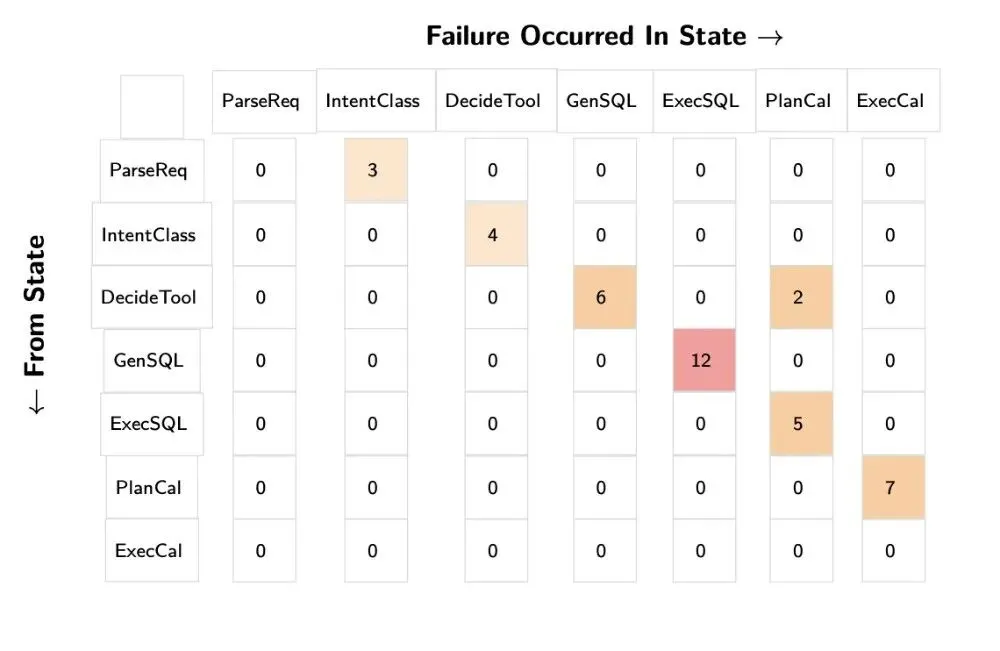
对 Agent 来说尤其重要。Agent 的失败不只是答案写错,也可能发生在 Tool Choice、Parameter Extraction、Error Handling、Context Retention,甚至执行效率上。这份材料对 Agentic Workflow 的建议也是先看端到端 Task Success,再根据 Trace 暴露的问题做 step-level diagnostics,而不是一开始把 Agent 拆成几十项机械评分。
图3|Transition Failure Matrix:通过工作流状态转换定位 Agent 失败最集中的步骤。
AI Evals 的目标,从“自动给所有东西评分”变成“准确抓住值得修的错误”。
Judge 也得先被 Judge
只要把 LLM 引入 Eval,新问题就来了:如果 Judge 自己判断错了怎么办?
很多 AI Eval 系统忽略了这一层。团队可能认真评测自己的 Agent,却默认负责评分的 GPT、Claude 或其他 Judge 可信。Hamel 和 Shreya 的方法相反:自动 Evaluator 本身也是模型,也需要被评测。
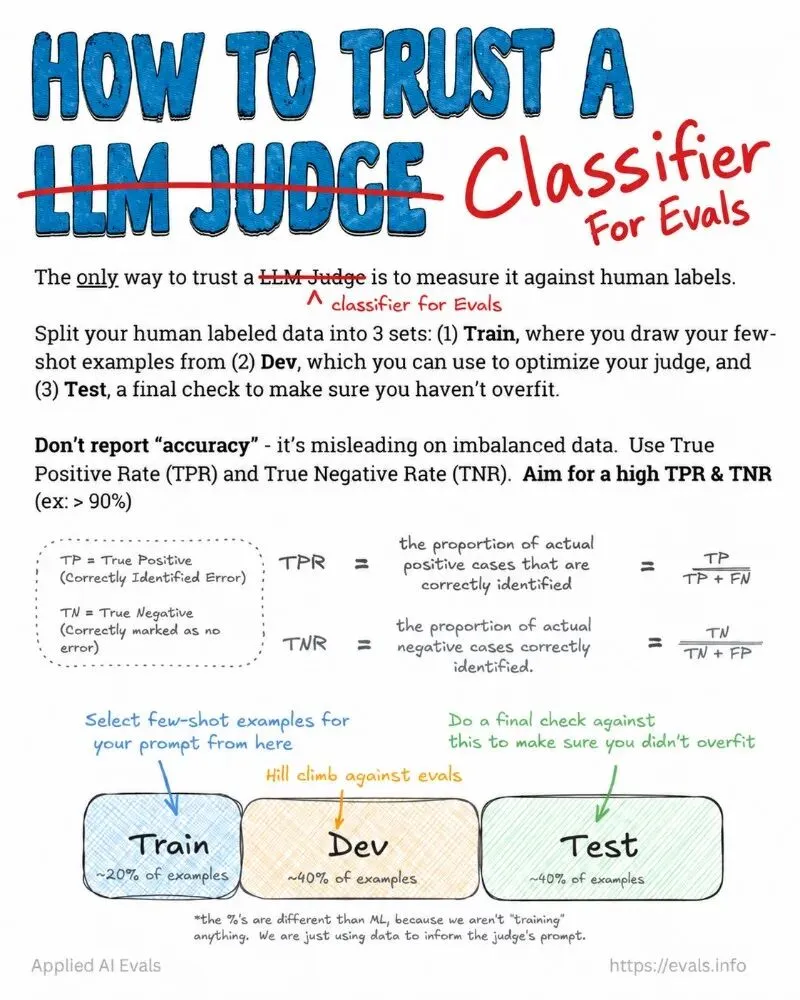
他们给出的数字很具体。前面那 100 条 Trace 是为了发现问题;当某个 Failure Mode 需要 LLM Judge 判断时,建议为每种 Failure Mode 准备大约 100~200 个带人工标签的样本,这一步是为了验证 Judge 能不能稳定识别这个问题。样本里既有 Pass 也有 Fail。然后把 Judge 的判断和人类领域专家的标签比较,检查它能抓住多少真实错误,又会产生多少误报。
比如团队要测一个销售 Agent 是否在该转人工时及时升级。不要写一句“请判断这个 Agent 是否正确处理了客户需求”,然后开始大规模跑分。先找一批真实案例,由业务专家人工判断哪些必须转人工、哪些不需要,再测试 Judge 能否复现这种判断。Judge 和人类意见不一致的地方,最值得继续看:是 Prompt 没说清楚,Context 给得不够,还是人工标准本身不一致?
于是出现了一个“测评套娃”:AI 产品需要 Eval,LLM Judge 用来做 Eval,而 LLM Judge 自己也要先通过 Eval。
这一步也让 AI 测评重新靠近传统数据科学和机器学习。不能因为用了最强模型就默认结果可信,还是要回到 labeled data、训练集、开发集、测试集、false positive、false negative 这些朴素的东西上。模型可以帮助放大人工判断,但不能替团队决定什么才算“好”。
图4|自动 Evaluator 也需要用人工标签验证,并用 Train / Dev / Test 划分检查 TPR、TNR 与过拟合。
Eval 应该像回归测试一样活着
把这些方法连起来,会发现今天的 AI Eval 和模型跑榜已经变成两套不同工作流。
以前更像:准备 Benchmark → 跑模型 → 得到 Score → 比较模型。现在 Product Eval 更像:收集真实 Trace → 人工做 Error Analysis → 建立 Failure Taxonomy → 为重要 Failure Mode 写 Evaluator → 用人工标签验证 Evaluator → 把真实失败加入 Eval Set → 修改 Model、Prompt、Retrieval 或 Tool → 重新运行。
所以 Eval 不该只发生在模型发布或产品上线前。今天换一个更强的新模型,可能推理能力提升,却改变 Tool Calling 行为;重写 System Prompt,可能解决一个问题,同时让另一个场景退化;调整 RAG 策略,也可能提高 Recall,却把错误资料送进更多回答。Hamel 和 Shreya 建议,在模型切换、Prompt 更新、新功能和重大 Bug Fix 等明显变化后重新做 Error Analysis,成熟系统也要持续抽查新的生产 Trace。
这时 Eval 的角色接近软件里的 Regression Test。线上发现一个失败,确认它重要,就把它沉淀成测试;修复后,每次系统发生重要变化重新跑一次,确认问题没有回来。区别在于,大模型产品的输入空间比传统软件开发大得多,很多 Failure Mode 无法提前穷举,所以 Hamel 和 Shreya 甚至不主张机械追求“Eval-Driven Development”。很多时候应该先观察真实失败,再为已经确认的问题写 Eval。
过去两年,AI 行业很擅长回答一个问题:这个模型到底有多强?Benchmark、排行榜和统一数据集,让 GPT、Claude、Gemini 可以在同一套坐标系里比较。
但当 AI 从一个模型变成由 Prompt、Retrieval、Tool、Memory 和应用代码共同组成的产品,企业真正需要回答的问题已经变了:这个系统到底会在哪里失败?
这也是 Product Eval 和传统 Benchmark 最大的区别。Benchmark 仍然可以帮助团队选择模型,但进入真实产品之后,Eval 的重心开始从 Overall Score 转向 Failure Mode,从标准数据集转向生产 Trace,从发布前的一次跑分转向持续 Regression。一个错误被发现、被分类、被写成 Evaluator,再在下一次模型、Prompt 或 Tool 更新后重新运行。
总分没有消失,只是从起点退到了最后一层 Dashboard。真正推动产品改进的,已经不是“这次涨了几分”,而是哪类错误增加了、哪个问题刚刚被修掉,以及一次系统更新有没有让旧问题重新出现。
AI 测评正在离开排行榜,进入产品研发流程。