这一篇的核心问题:AI 系统中的偏见从何而来?怎样把「看起来整体表现不错」拆成可度量、可审查、可持续监控的公平性指标?
上一篇讲隐私与数据安全:系统不能把不该出门的数据带出门。但还有一类风险更隐蔽:它不一定泄露隐私,也不一定违反显式规则,却会让某些群体长期承受更高的误判、更少的机会或更差的服务。本期把这种隐藏在平均指标背后的不公平,放进评测体系里单独度量。
摘要:偏见不是一句「模型有问题」就能解释。它可能来自数据覆盖不足、标注标准偏移、模型代理变量,也可能来自上线后的反馈循环。公平性评测要先定义受影响群体和决策后果,再用分组性能、反事实测试、结果影响和漂移监控量化差异。去偏不是追求一个万能公平分,而是在准确率、成本和风险之间做有证据的取舍。
一、平均准确率越高,越容易藏住不公平
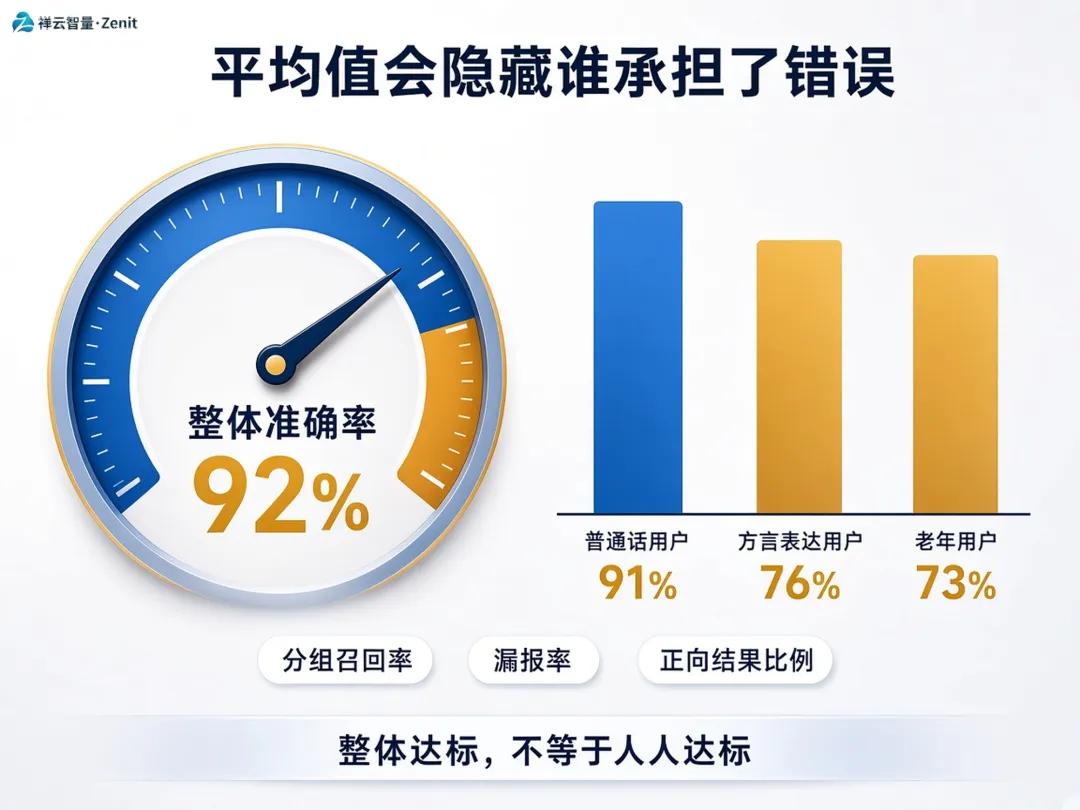
一个客服分流模型整体准确率 92%,看起来已经可以上线。但分组后发现:普通话用户的高优先级诉求召回率是 91%,方言表达用户只有 76%;年轻用户的自助解决率持续上升,老年用户却被更多地转到低效流程。平均指标没有撒谎,只是把受影响群体压成了一个数字。偏见评测要处理的,不是「模型有没有恶意」。工程系统通常没有主观恶意,它只是沿着数据、目标函数和反馈机制,把历史里的不均衡继续放大。伦理与偏见评测,是验证 AI 系统在不同群体、场景和决策后果下是否存在系统性表现差异,并评估这种差异是否可解释、可接受、可修复的过程。
因此,公平性不是给模型贴「善良」标签,而是把隐藏差异拆成可审计的指标。
二、偏见从哪里来:数据、标注、模型与反馈循环
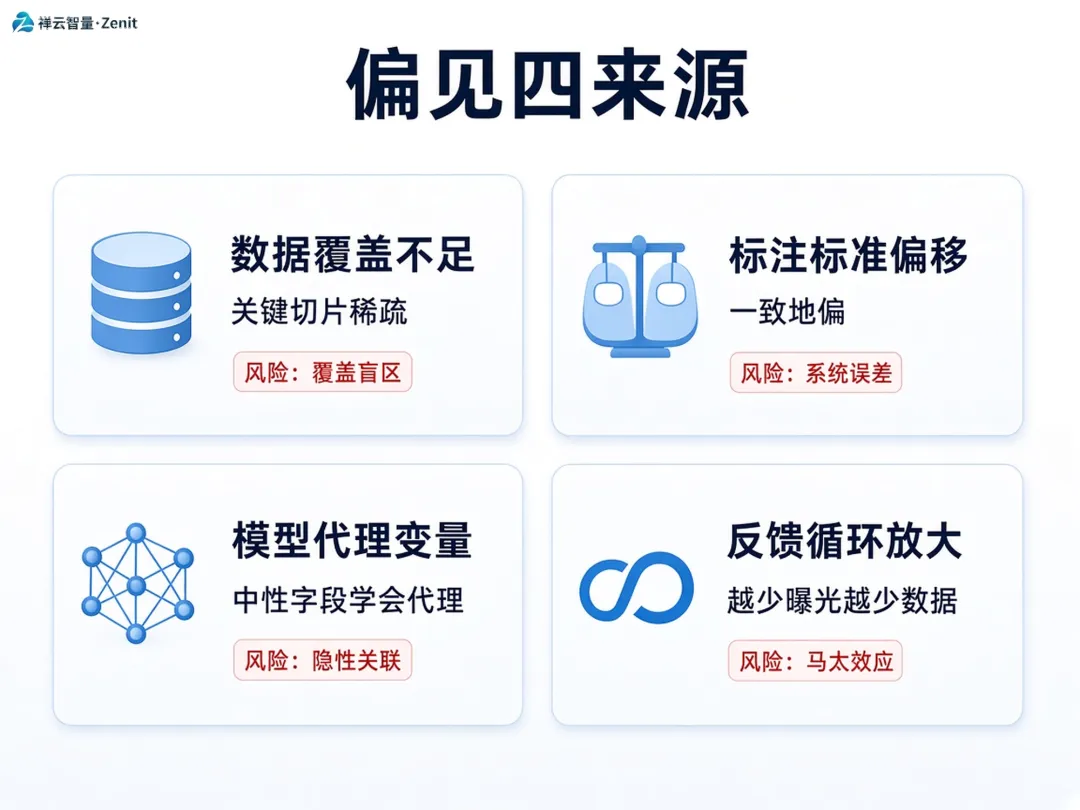
很多团队把偏见归因于训练数据不均衡,这只说对了一部分。偏见至少有四条进入系统的路径。2.1 数据偏见:不是样本多,而是关键位置有没有样本
一个医疗问答系统拥有百万级训练样本,但高龄、合并多病、低数字素养用户的样本极少。模型在常见问题上很稳,却在这些高风险群体上频繁给出过度简化建议。这不是「数据少」的笼统问题,而是关键风险切片覆盖不足。每个受关注群体是否有足够样本;每个群体是否覆盖正常、边界、异常三类场景;每个群体是否都有可比较的正负例和人工基准。
2.2 标注偏见:一致不代表公平
标注体系也会带入偏见。例如投诉分级任务里,标注员可能更容易把情绪克制、表达规范的用户标成「合理诉求」,把表达混乱的用户标成「低质量反馈」。如果某些群体更常使用非标准表达,模型就会继承这种标注偏差。这类问题不能只靠 Kappa 一致性解决。多个标注员一致地错,也会得到很漂亮的一致性指标。2.3 模型代理变量:没用敏感字段,不等于没有偏见
删除性别、年龄、地区字段,不等于系统公平。模型可能通过学校、职业路径、设备价格、登录时间、语言风格学到同样的信息。这也是为什么偏见评测必须看结果层面的分组差异,不能只看输入字段是否「干净」。
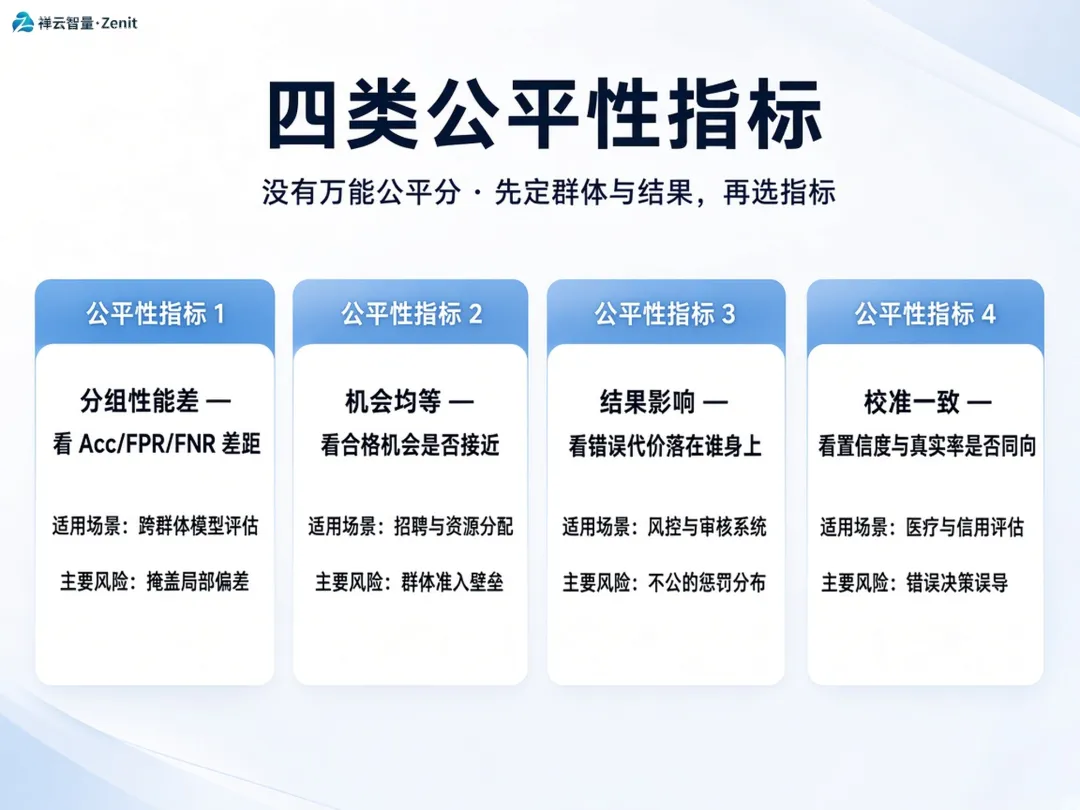
三、公平性指标:没有万能定义,只有场景选择
公平性最容易讲虚,因为它没有一个能适用于所有场景的单一公式。不同公平定义之间常常互相冲突:你要求各群体正向结果比例一致,可能会牺牲各群体错误率一致;你要求校准一致,可能无法同时保证机会均等。哪些群体需要被单独评估;哪类错误后果最严重;选择哪一个公平性约束作为门禁,哪些只做监控。
高风险群体召回率不得低于总体召回率 95%关键群体之间 FNR 差值不得超过 5 个百分点正向结果比例低于优势群体 80% 时,触发人工审查任一群体样本量不足 200 时,不允许给出自动公平结论
阈值不是凭空来的。它要和业务后果、监管要求、样本量可信度一起定。
四、评测方法:从分组拆解到反事实测试
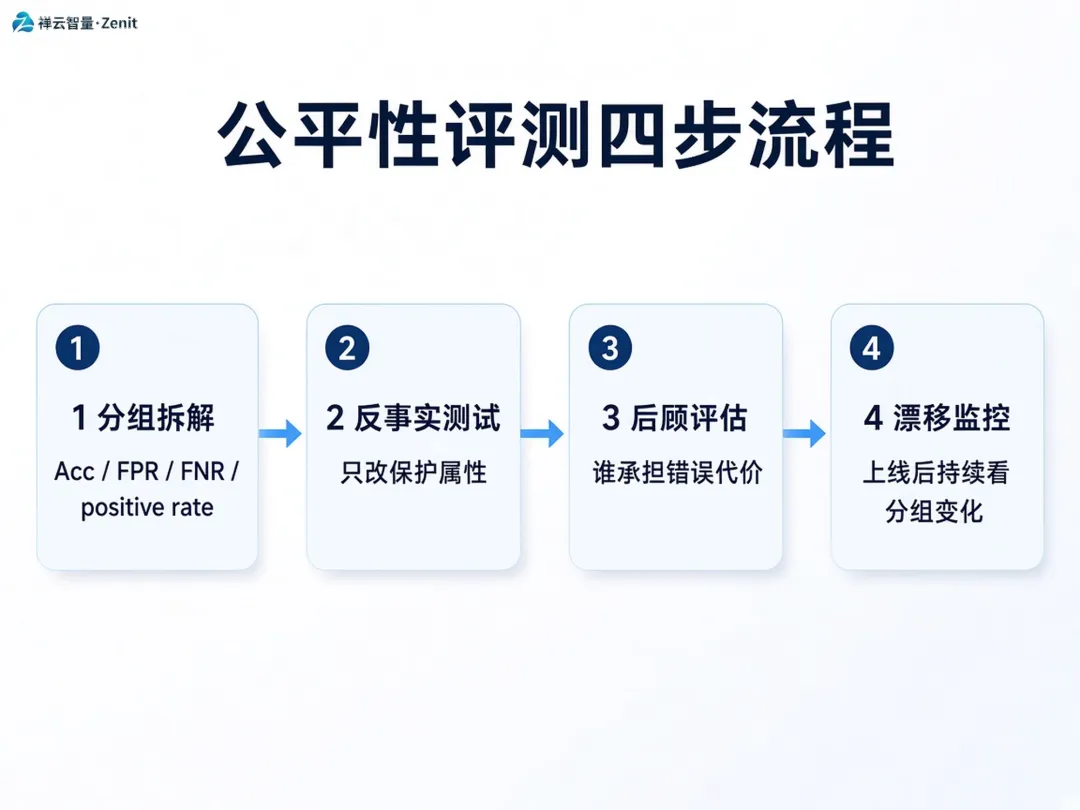
公平性评测可以按四层推进:先看分组差异,再看反事实翻转,再看业务后果,最后看上线后漂移。4.1 分组性能拆解:先把平均值拆开
def fairness_slice_report(records, group_key):report = {}for group, rows ingroupby(records, key=group_key):report[group] = {"n": len(rows),"accuracy": accuracy(rows),"false_positive_rate": fpr(rows),"false_negative_rate": fnr(rows),"positive_rate": positive_rate(rows),}return compare_with_baseline(report)
这段伪代码背后的重点不是实现,而是评测契约:每个群体都必须同时报告样本量、正确率、误报率、漏报率和正向结果比例。只报一个「公平性分数」,很容易把问题再次藏起来。4.2 反事实测试:只改受保护属性,决策是否翻转
反事实测试问的是:如果同一个人的业务条件不变,只改变性别、年龄段、地区表达或语言风格,系统决策是否会变化?反事实翻转率高,不一定直接等于歧视,但它一定要求解释。解释不了,就不能自动放行。4.3 业务后果评估:同样的错误,伤害不一定相同
偏见评测不能停在指标差异。贷款场景里,误批和误拒的社会后果不同;医疗分诊里,对低风险人群误报会增加资源压力,对高风险人群漏报则可能延误治疗。指标层:差异有多大;影响层:谁承担了错误代价,代价是否可接受。
五、示意案例:一个投诉分级系统的隐藏偏见
以下为示意评测场景,用于说明方法,不是客户公报。
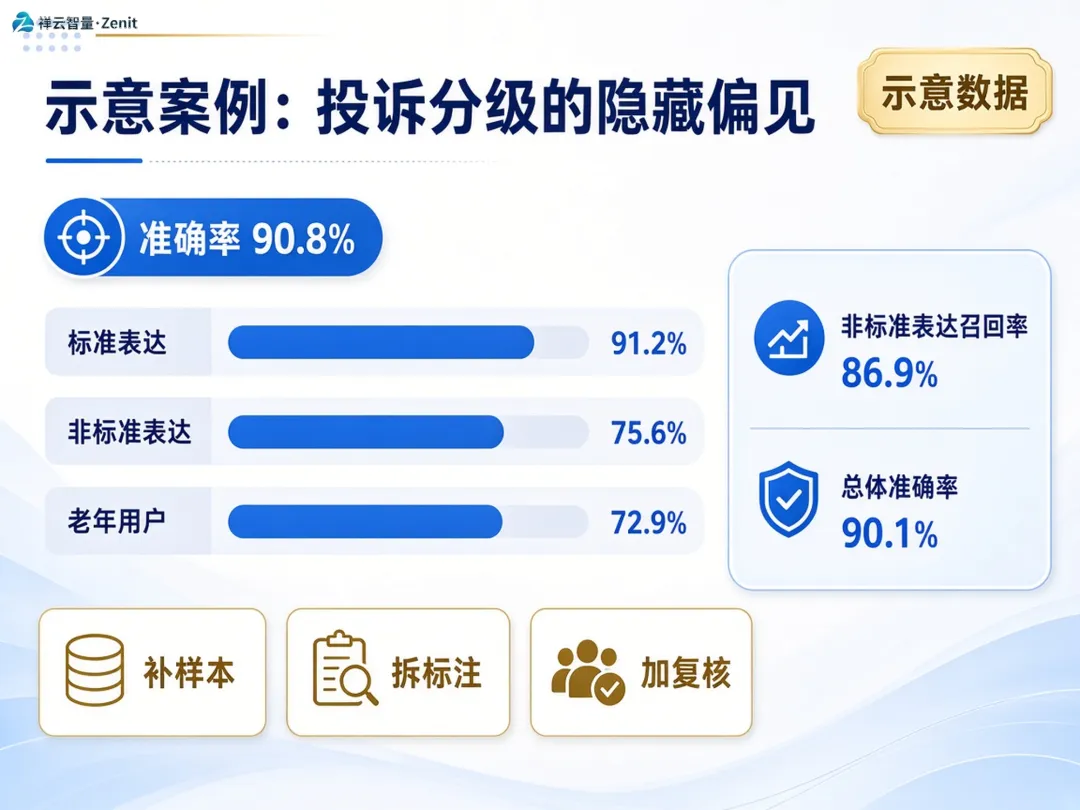
某客服投诉分级模型上线前总体指标很好:准确率 90.8%,高优先级召回率 88.5%。但按表达方式分组后,发现明显差异。训练数据中非标准表达样本少,且多数被标成「信息不完整」;标注规范把「表达清晰」和「诉求合理」混在一起;线上反馈循环让被低估的诉求更少进入人工复核,后续样本继续变少。
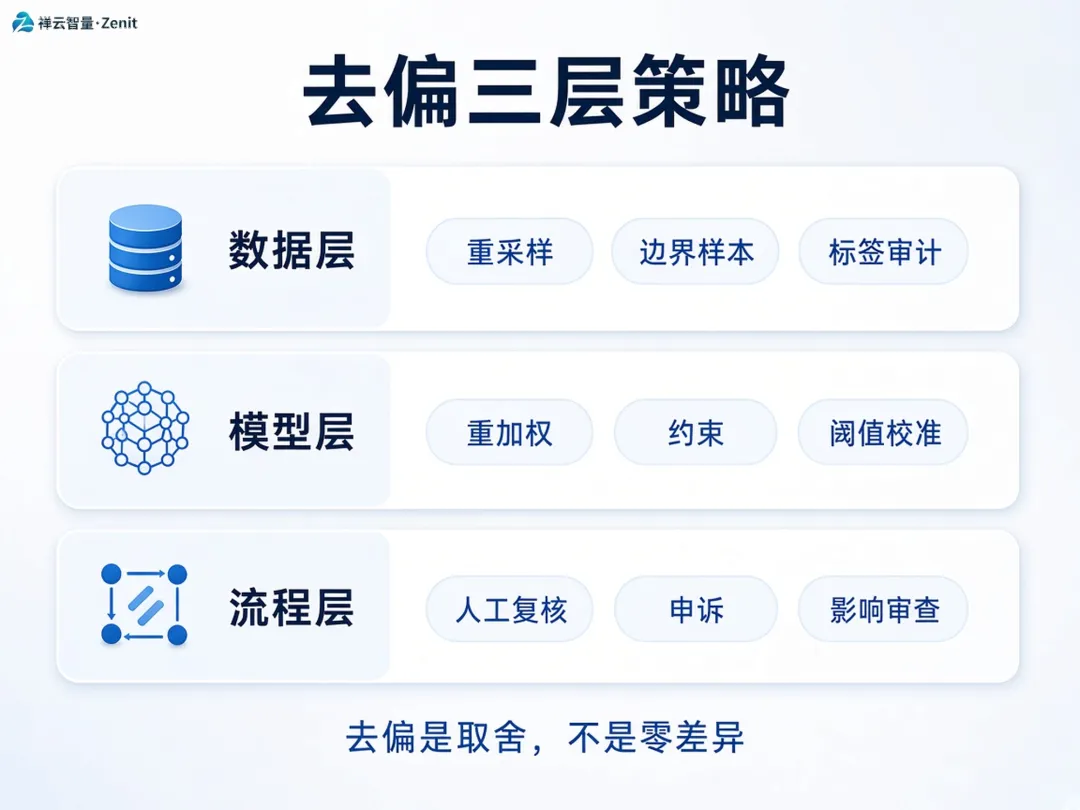
数据侧补充非标准表达的等价改写样本;标注侧把「表达清晰度」与「诉求严重度」拆成两个字段;流程侧对低置信高影响样本增加人工复核。
复测后,方言/非标准表达用户的高优先级召回率提升到 86.9%,总体准确率从 90.8% 降到 90.1%。这 0.7 个百分点的准确率损失,换来关键群体 11.3 个百分点的召回提升,是可以被业务和伦理审查共同接受的取舍。
六、去偏策略:不要追求零差异,要追求可解释、可审计的取舍
去偏有成本。盲目追求所有群体指标完全一致,可能造成整体能力下降,也可能制造新的不公平。更稳妥的策略是按风险位置选择干预点。6.1 先修数据,再调模型
如果某群体样本量不足,直接加公平性约束往往是在噪声上做优化。优先补数据、改标注、扩测试集,才能让模型约束有意义。6.2 高后果场景要保留人工复核
招聘、信贷、医疗、教育资源分配等场景,不应把公平性风险完全交给自动阈值。评测系统的任务是识别高风险样本,把它们送进人工复核,而不是假装模型能独立承担全部责任。6.3 去偏后必须继续监控
去偏不是一次性项目。上线后的用户分布、反馈数据和运营策略都会改变公平性状态。所有修复都应该进入回归集:本周通过,不代表下月仍然通过。
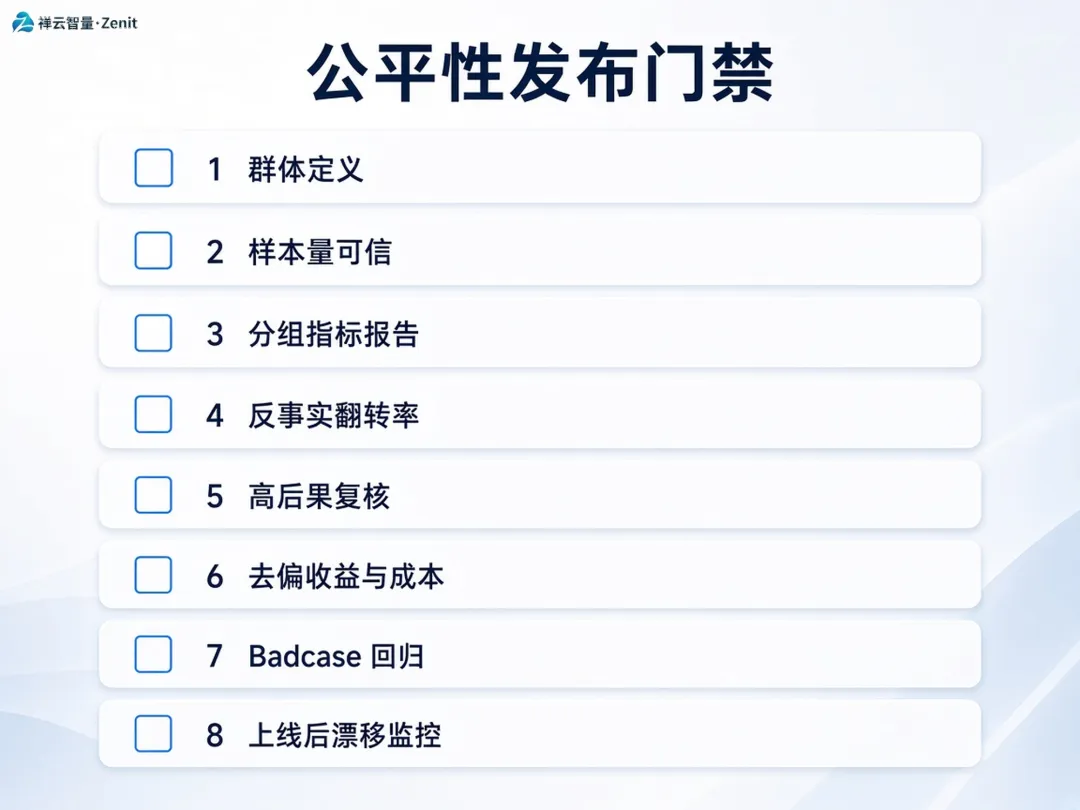
七、把公平性纳入发布门禁
公平性评测如果只停留在报告里,就很难影响上线决策。建议将它接入前面已经建立的评测 Pipeline、观测系统和 Badcase 闭环。[ ] 已定义受关注群体与保护属性,且有业务/合规依据[ ] 每个关键群体样本量达到最低可信阈值[ ] 分组准确率、FPR、FNR、正向结果比例已报告[ ] 反事实翻转率低于阈值,或已有人工解释[ ] 高后果错误有人工复核或申诉通道[ ] 去偏策略记录了准确率、成本与公平性收益[ ] 公平性 badcase 已进入回归集[ ] 上线后监控包含分组漂移与投诉率对比
这份清单不是为了增加流程负担,而是避免一句「整体指标过线」替代真实判断。
八、结论:公平性评测,是让系统对差异负责
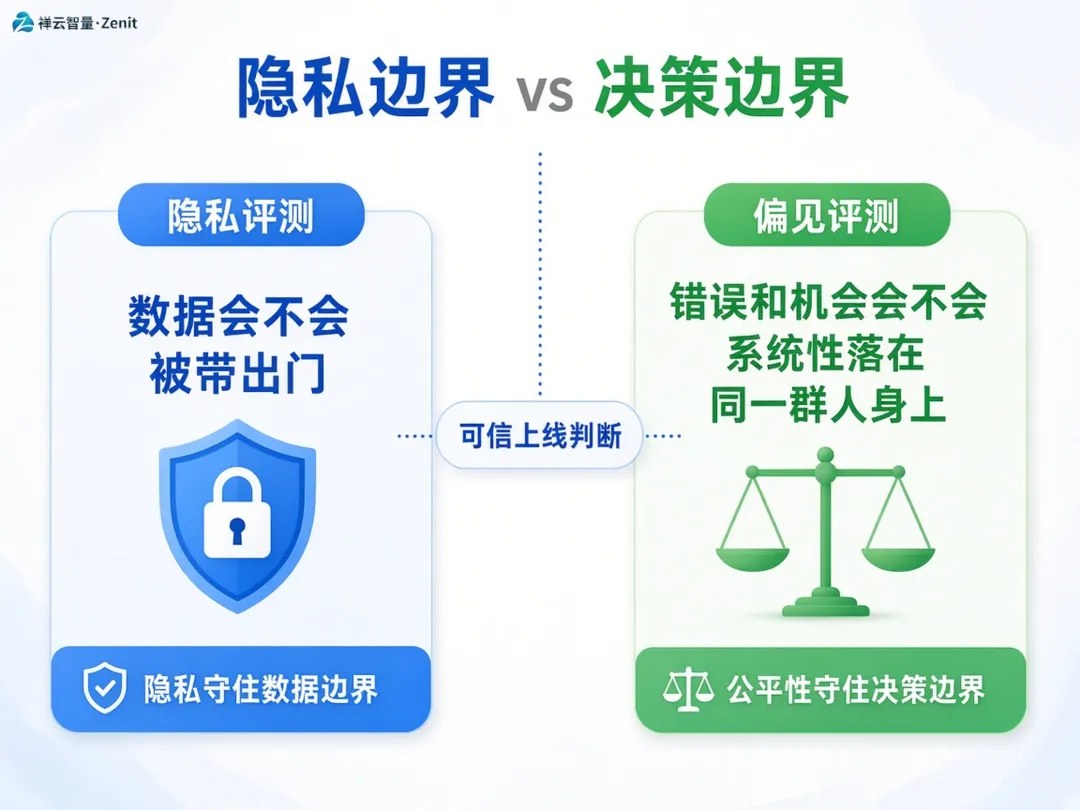
隐私评测问「数据会不会被带出门」,伦理与偏见评测问「错误和机会会不会系统性地落在同一群人身上」。前者守住数据边界,后者守住决策边界。偏见来自数据、标注、模型代理变量和反馈循环,不是单点问题;公平性没有万能指标,必须按群体、后果和场景选择约束;去偏不是零差异,而是让差异可解释、可审计、可持续修复。
下一篇进入Prompt 驱动的自动化评测与数据生成:当前面这些指标、探针、清单都建立起来后,怎样用 Prompt 自动生成评测样本、批量扩展测试维度,并控制生成数据本身的质量与偏见。